Opgesteld door: Aetherix B.V. — Trusted Jetson Hardware Provider for Edge AI
Platform: NVIDIA Blackwell Ultra (B300 SXM) · juli 2026
Inhoud
- Inhoud
- 1. Doel en reikwijdte
- 2. Algemene architectuur van NVIDIA DGX B300
- 3. Algemene architectuur van NVIDIA GB300 NVL72
- 4. Technische specificaties en mogelijkheden van de B300-GPU
- 5. Het belangrijkste onderscheidende kenmerk van GB300 NVL72: een NVLink-domein van 72 GPU’s
- 6. Netwerkarchitectuur van DGX B300
- 7. Netwerkarchitectuur van GB300 NVL72
- 8. Stroom- en koelingsvereisten
- 9. Virtualisatie en het delen van GPU’s
- 10. Technische vergelijking DGX B300 vs GB300 NVL72
- 11. Platformkeuze op basis van workload
- 12. Vergelijking vanuit trainingsperspectief
- 13. Vergelijking vanuit inferentieperspectief
- 14. Simulatie en HPC
- 15. Operationele flexibiliteit
- 16. De keuze tussen ARM64 en x86
- 17. Wanneer kiest u voor DGX B300
- 18. Wanneer kiest u voor GB300 NVL72
- 19. Welk platform wanneer?
- 20. Wanneer is een hybride architectuur zinvol?
- 21. Beknopte beslissingstabel
- 22. Conclusie
1. Doel en reikwijdte
Dit document geeft een technische vergelijking van twee op NVIDIA Blackwell Ultra gebaseerde architecturen — NVIDIA DGX B300 en NVIDIA GB300 NVL72 — voor AI-infrastructuur van de volgende generatie.
Hoewel beide platforms dezelfde NVIDIA Blackwell Ultra-GPU-architectuur gebruiken, verschillen ze aanzienlijk in systeemontwerp, schaalaanpak, processorarchitectuur, GPU-interconnectmodel, netwerkarchitectuur, virtualisatieaanpak, eisen aan stroom en koeling in het datacenter, en doelworkloads.
Daarom moeten DGX B300 en GB300 NVL72 niet als directe alternatieven voor elkaar worden beschouwd, maar als twee afzonderlijke infrastructuurbenaderingen die zijn geoptimaliseerd voor verschillende workloadprofielen.
Dit document bespreekt beide platforms aan de hand van een voorbeeldontwerp van een cluster:
- DGX B300-zijde: meerdere DGX B300-servers (voorbeeld: ~40 nodes)
- GB300-zijde: meerdere GB300 NVL72-racks (voorbeeld: ~4 racks)
- gedeelde, krachtige opslag
- gescheiden Compute-, Storage/In-band- en OOB-netwerken
- beheerlaag met NVIDIA Mission Control / BCM / Run:ai
2. Algemene architectuur van NVIDIA DGX B300
NVIDIA DGX B300 is een AI-systeem met 8 NVIDIA B300 Blackwell Ultra-GPU’s in één server, qua ontwerp dichter bij een klassieke x86-server. NVIDIA omschrijft het systeem als een platform dat is ontworpen voor algemene AI-infrastructuurworkloads, waaronder training, inferentie (inference) en analytics.
Elk DGX B300-systeem:
| Kenmerk | DGX B300 |
|---|---|
| GPU | 8 × NVIDIA B300 Blackwell Ultra |
| GPU-geheugen | ~2.3 TB HBM in totaal |
| CPU | 2 × Intel Xeon Platinum 6776P |
| Systeemgeheugen | 2 TB, tot 4 TB |
| GPU-interconnect | NVLink / NVSwitch van de 5e generatie |
| Computenetwerk | 8 × ConnectX-8 |
| Poortsnelheid compute | 8 × 800 Gb/s |
| Opslag / beheer | 2 × dual-port BlueField-3 |
| Lokale cache | 8 × 3.84 TB E1.S NVMe |
| Vormfactor | 10 RU |
| Stroomverbruik | ~14.5 kW |
| Processorarchitectuur | x86 |
| Koeling | Lucht- of vloeistofgekoeld (luchtgekoeld in dit ontwerp) |
De acht GPU’s in de DGX B300 zijn met elkaar verbonden via de interne NVSwitch-fabric van het systeem, met snelle NVLink. Het NVLink-domein is echter beperkt tot één DGX B300-server. Tussen twee DGX B300-systemen verloopt de GPU-communicatie over de externe Compute Fabric.
In het voorbeeldontwerp van het cluster is deze fabric Quantum-X800 InfiniBand.
De NVIDIA DGX B300 SuperPOD-referentiearchitectuur ondersteunt ook een 800 Gb/s XDR InfiniBand-computefabric en gebruikt Q3400-RA-switches.
DGX B300 is leverbaar in luchtgekoelde en vloeistofgekoelde configuraties. De architectuur in dit document gebruikt de luchtgekoelde DGX B300. Ondanks een TDP van 1,400 W per GPU kan het systeem in een vormfactor van 10 RU met luchtkoeling worden gebruikt. Dat is een belangrijk voordeel: in de bestaande datacenterinfrastructuur is geen investering in vloeistofkoeling (DLC) nodig.
3. Algemene architectuur van NVIDIA GB300 NVL72
GB300 NVL72 verschilt architectonisch van DGX B300 — het is ontworpen als een computesysteem op rackschaal, niet op serverschaal.
Eén NVL72-rack bevat:
- 18 × compute tray
- 72 × Blackwell Ultra-GPU
- 36 × NVIDIA Grace-CPU
- 9 × NVLink Switch Tray
- passieve koperen NVLink-backplane
- power shelves
- manifolds voor vloeistofkoeling
Een compute tray
Elke GB300-compute tray bevat:
- 2 × NVIDIA Grace-CPU
- 4 × B300 Blackwell Ultra-GPU
- 4 × ConnectX-8
- 1 × dual-port BlueField-3 B3240
- lokale NVMe-cache
- NVMe voor het opstarten
Eén NVL72-rack levert dus:
18 trays × 4 GPU = 72 GPU
Op rackniveau heeft GB300 NVL72:
| Kenmerk | GB300 NVL72 |
|---|---|
| GPU | 72 × B300 Blackwell Ultra / rack |
| CPU | 36 × NVIDIA Grace (2592 Neoverse V2-cores) |
| Totale NVLink-BW | 130 TB/s |
| Rackgeheugen | 20 TB HBM |
| FP4 sparse (rack) | 1,440 PF |
| FP4 dense (rack) | 1,080 PF |
| Rackvermogen | ~135 kW (132–142 kW; piek ~155 kW) |
| Koeling | Volledige vloeistofkoeling (DLC verplicht) |
NVIDIA omschrijft de GB300 NVL72 als “fully liquid-cooled”. Dat betekent niet dat 100% van de warmte naar de vloeistof gaat; in NVL72-racks wordt ongeveer 90% van de warmte aan de vloeistof en 10% aan de lucht afgegeven (OSFP-modules, opslag, PDB).
4. Technische specificaties en mogelijkheden van de B300-GPU
Beide platforms gebruiken dezelfde B300 Blackwell Ultra-GPU. Deze sectie behandelt de technische specificaties en mogelijkheden per GPU.
4.1 Specificaties per GPU
Alle rekenwaarden zijn in PFLOPS (PF). De waarden komen van NVIDIA’s HGX-productpagina.
| Kenmerk | B300 SXM |
|---|---|
| Architectuur | Blackwell Ultra |
| VRAM | 288 GB (capaciteit van de die) |
| Bruikbaar VRAM (HGX) | ~262 GB/GPU (2.3 TB ÷ 8) |
| HBM-type | HBM3e |
| Geheugenbandbreedte | 8 TB/s |
| FP4 sparse | 18 PF |
| FP4 dense | 13.5 PF |
| FP8 sparse | 9 PF |
| FP8 dense | 4.5 PF |
| FP16/BF16 sparse | 4.5 PF |
| FP16/BF16 dense | 2.25 PF |
| TDP | 1,400 W |
| NVLink | NVLink 5 (1.8 TB/s) |
| ConnectX | ConnectX-8 (800G) |
| Procesnode | TSMC 4NP |
| Transistors | 208 B |
Belangrijke opmerkingen:
-
Sparse vs dense: sparse waarden zijn gemeten met 2:4 structured sparsity (van elke 4 opeenvolgende waarden zijn er hoogstens 2 ongelijk aan nul) en weerspiegelen een theoretische winst van ~2×. Dense is de werkelijke doorvoer (throughput) zonder deze aanname. Selectiebeslissingen moeten op de dense waarden worden gebaseerd; sparse waarden geven alleen de theoretische piekcapaciteit aan en zijn voor de meeste workloads in productie niet volledig haalbaar.
-
Verschil in basis voor de FP4-waarde van B300: NVIDIA’s technische blog over Blackwell Ultra noemt 15 PF dense / 20 PF sparse NVFP4 per die; op basis van het HGX-systeem met 8 GPU’s is dat 13.5 PF dense / 18 PF sparse (108 PF ÷ 8 en 144 PF ÷ 8). Die × 8 = 120/160 PF, HGX = 108/144 PF — er is een consistent verschil van ~10% op systeemniveau.
-
Waarom BF16 belangrijk is: het grootste deel van pretraining, master weights/optimizer state en SFT/LoRA-fine-tuning gebeurt nog steeds in BF16; veel inferentiepijplijnen in productie draaien ook in BF16.
-
2× attention-prestaties van B300: de 2× hogere attention-prestaties van B300 ten opzichte van Blackwell komen voort uit een verdubbeling van de doorvoer van de SFU (Special Function Unit) voor belangrijke instructies die in attention-lagen worden gebruikt — niet uit een toename van de ruwe FP4-rekenkracht. De winst is daarom het grootst bij workloads met lange context en reasoning.
-
Geheugenarchitectuur van B300: de capaciteit van 288 GB komt van 12-high HBM3e-stacks. De toename van het geheugen is geen nieuwe HBM-generatie, maar wordt bereikt door de stacks hoger te maken.
4.2 Functiematrix
De volgende matrix geeft het datacenter-SXM-segment weer.
| Kenmerk | B300 |
|---|---|
| FP4 (NVFP4) | ✓ |
| FP6 | ✓ |
| FP8 | ✓ |
| FP16/BF16 | ✓ |
| TF32 | ✓ |
| MIG | ✓ (2×140 / 4×70 / 7×34 GB) |
| Confidential Computing | ✓ TEE-I/O (1/2/4/8 GPU) |
| GPUDirect RDMA | ✓ |
| Tensor Core-generatie | 5e generatie |
| Transformer Engine | 2e generatie (FP4/NVFP4) |
| NVLink-generatie | 5 (1.8 TB/s) |
| ConnectX | CX-8 (800G) |
| Procesnode | TSMC 4NP |
| Transistors | 208 B |
MIG (Multi-Instance GPU)
Verdeelt één GPU in instances die op hardwareniveau van elkaar zijn geïsoleerd. Voor Blackwell Ultra (B300) publiceert NVIDIA specifieke partitie-opties: 2×140 GB, 4×70 GB of 7×34 GB. Dit is een cruciale isolatiefunctie voor multi-tenant workloads in datacenter en cloud; in hoeveel geheugen per tenant een GPU van 288 GB wordt verdeeld, is een directe input voor de capaciteitsplanning.
Confidential Computing / TEE-I/O
Blackwell is de eerste GPU met TEE-I/O-functionaliteit en breidt het beveiligde domein via NVLink/NVSwitch uit naar meerdere GPU’s: via NVLink verbonden Blackwell HGX/DGX-systemen ondersteunen beveiligde deployments van 1, 2, 4 of 8 GPU’s in TEE-modus. De prestatie-overhead is in de praktijk nul: NVIDIA’s technische blog over Blackwell Ultra vermeldt voor TEE-I/O “nearly identical throughput compared to unencrypted modes”; metingen van derden bevestigen dit in cijfers (BF16-matmul 0.998×, CUDA graph met 96,000 matmuls 1.0012×). Dit is een bepalende functie voor gereguleerde workloads (financiële sector, zorg, overheid).
4.3 Interconnect en netwerken
- NVLink 5: 1.8 TB/s per GPU. Op rackniveau levert GB300 NVL72 in totaal 130 TB/s.
- ConnectX-8: 800G. Verdubbelt de bandbreedte (bandwidth) tussen nodes ten opzichte van ConnectX-7 (400G).
- NVLink vs NVSwitch: NVLink is een point-to-point-verbinding van GPU naar GPU. NVSwitch is de chip die NVLink-poorten bundelt tot een fabric, waardoor één domein mogelijk wordt op de schaal van 8 GPU’s per node (HGX) of 72 GPU’s per NVL72-rack. NVL72-racks zijn afhankelijk van NVSwitch; deze schaal is met alleen NVLink niet mogelijk. Op beide schalen (node met 8 GPU’s en rack met 72 GPU’s) is NVSwitch aanwezig, zodat Fabric Manager nodig is (zie sectie 8).
- NVLink-C2C: de coherente verbinding op chipniveau tussen Grace-CPU en GPU (900 GB/s). Het is een ander protocol dan NVLink van GPU naar GPU; het vormt de basis van de GB300-superchiparchitectuur (1 Grace-CPU + 2 Blackwell-GPU’s) en daarmee van GB300 NVL72-racks. Unified memory — CPU- en GPU-geheugen dat als één adresruimte verschijnt — wordt via deze verbinding geleverd.
- GPUDirect RDMA: stelt de NIC in staat GPU-geheugen rechtstreeks te benaderen zonder te kopiëren via het CPU-geheugen. Een fundamentele functie voor scale-out-prestaties bij gedistribueerde training en inferentie; verkort het datapad van NCCL.
5. Het belangrijkste onderscheidende kenmerk van GB300 NVL72: een NVLink-domein van 72 GPU’s
Dit is het grootste architectonische voordeel van GB300 NVL72 ten opzichte van DGX B300.
Binnen een DGX B300 omvat het NVLink-domein:
8 GPU’s
terwijl GB300 NVL72 beschikt over:
72 GPU’s in één NVLink-domein
Dankzij NVIDIA’s GB300-rackontwerp kunnen 72 GPU’s binnen het rack via NVLink/NVSwitch met zeer hoge bandbreedte en lage latentie (latency) communiceren. Op rackniveau is in totaal 130 TB/s NVLink-bandbreedte beschikbaar.
Dit is vooral belangrijk voor toepassingen die grootschalig modelparallellisme vereisen.
Bijvoorbeeld:
- tensorparallellisme (tensor parallelism)
- pipelineparallellisme (pipeline parallelism)
- expertparallellisme (expert parallelism)
- MoE-modellen
- training van zeer grote LLM’s
- inferentie met grote context
- reasoningmodellen
Deze veroorzaken intensieve communicatie tussen GPU’s.
In een DGX B300-cluster loopt dit verkeer tussen servers over InfiniBand, terwijl het bij GB300-GPU’s in hetzelfde rack op de NVLink-fabric blijft.
Dit is de kern van de architectonische waardepropositie van GB300.
6. Netwerkarchitectuur van DGX B300
Het voorbeeldontwerp van ~40 nodes omvat drie primaire fysieke netwerken.
6.1 Computenetwerk
Elke DGX B300 heeft:
8 × 800 Gb/s ConnectX-8-computeverbindingen
Voor 40 DGX-nodes:
40 × 8 = 320 × 800 Gb/s computeverbindingen
Het voorbeeldontwerp van de computefabric:
- 8 × Q3400-RA leaf
- 4 × Q3400-RA spine
- Totaal: 12 × Q3400-RA
Deze structuur biedt hoge bandbreedte en lage latentie voor:
- training over meerdere nodes
- gedistribueerde inferentie
- collectieve communicatie via NCCL
- MPI/HPC
- RDMA van GPU naar GPU
Totale scale-out-bandbreedte per node: 8 × 800G = 6.4 TB/s (8 × ConnectX-8).
6.2 In-band- en opslagnetwerk
Los van de computefabric wordt een apart, op Ethernet gebaseerd in-band-/opslagnetwerk ontworpen.
Voorbeeldstructuur:
- 4 × SN5610 leaf
- 2 × SN5610 spine
Totaal:
6 × SN5610
Dit netwerk transporteert:
- provisioning
- gebruikerstoegang
- Kubernetes-/Run:ai-verkeer
- beheer
- toegang tot opslag
- serviceverkeer
6.3 OOB- en fabricbeheer
Voor het OOB-beheernetwerk:
4 × SN2201
Omdat de computefabric InfiniBand is, daarnaast:
2 × UFM
voor InfiniBand-fabricbeheer met HA.
UFM verzorgt:
- topologie van de InfiniBand-fabric
- subnet management
- statusmonitoring
- congestiemonitoring
- fabrictelemetrie
- probleemoplossing (troubleshooting)
Aan de Ethernet-zijde kunnen netwerktelemetrie en monitoring via NetQ/Mission Control worden uitgevoerd.
6.4 Voorbeeldtopologie DGX B300
Hieronder staat een voorbeeld van een DGX B300-clustertopologie:
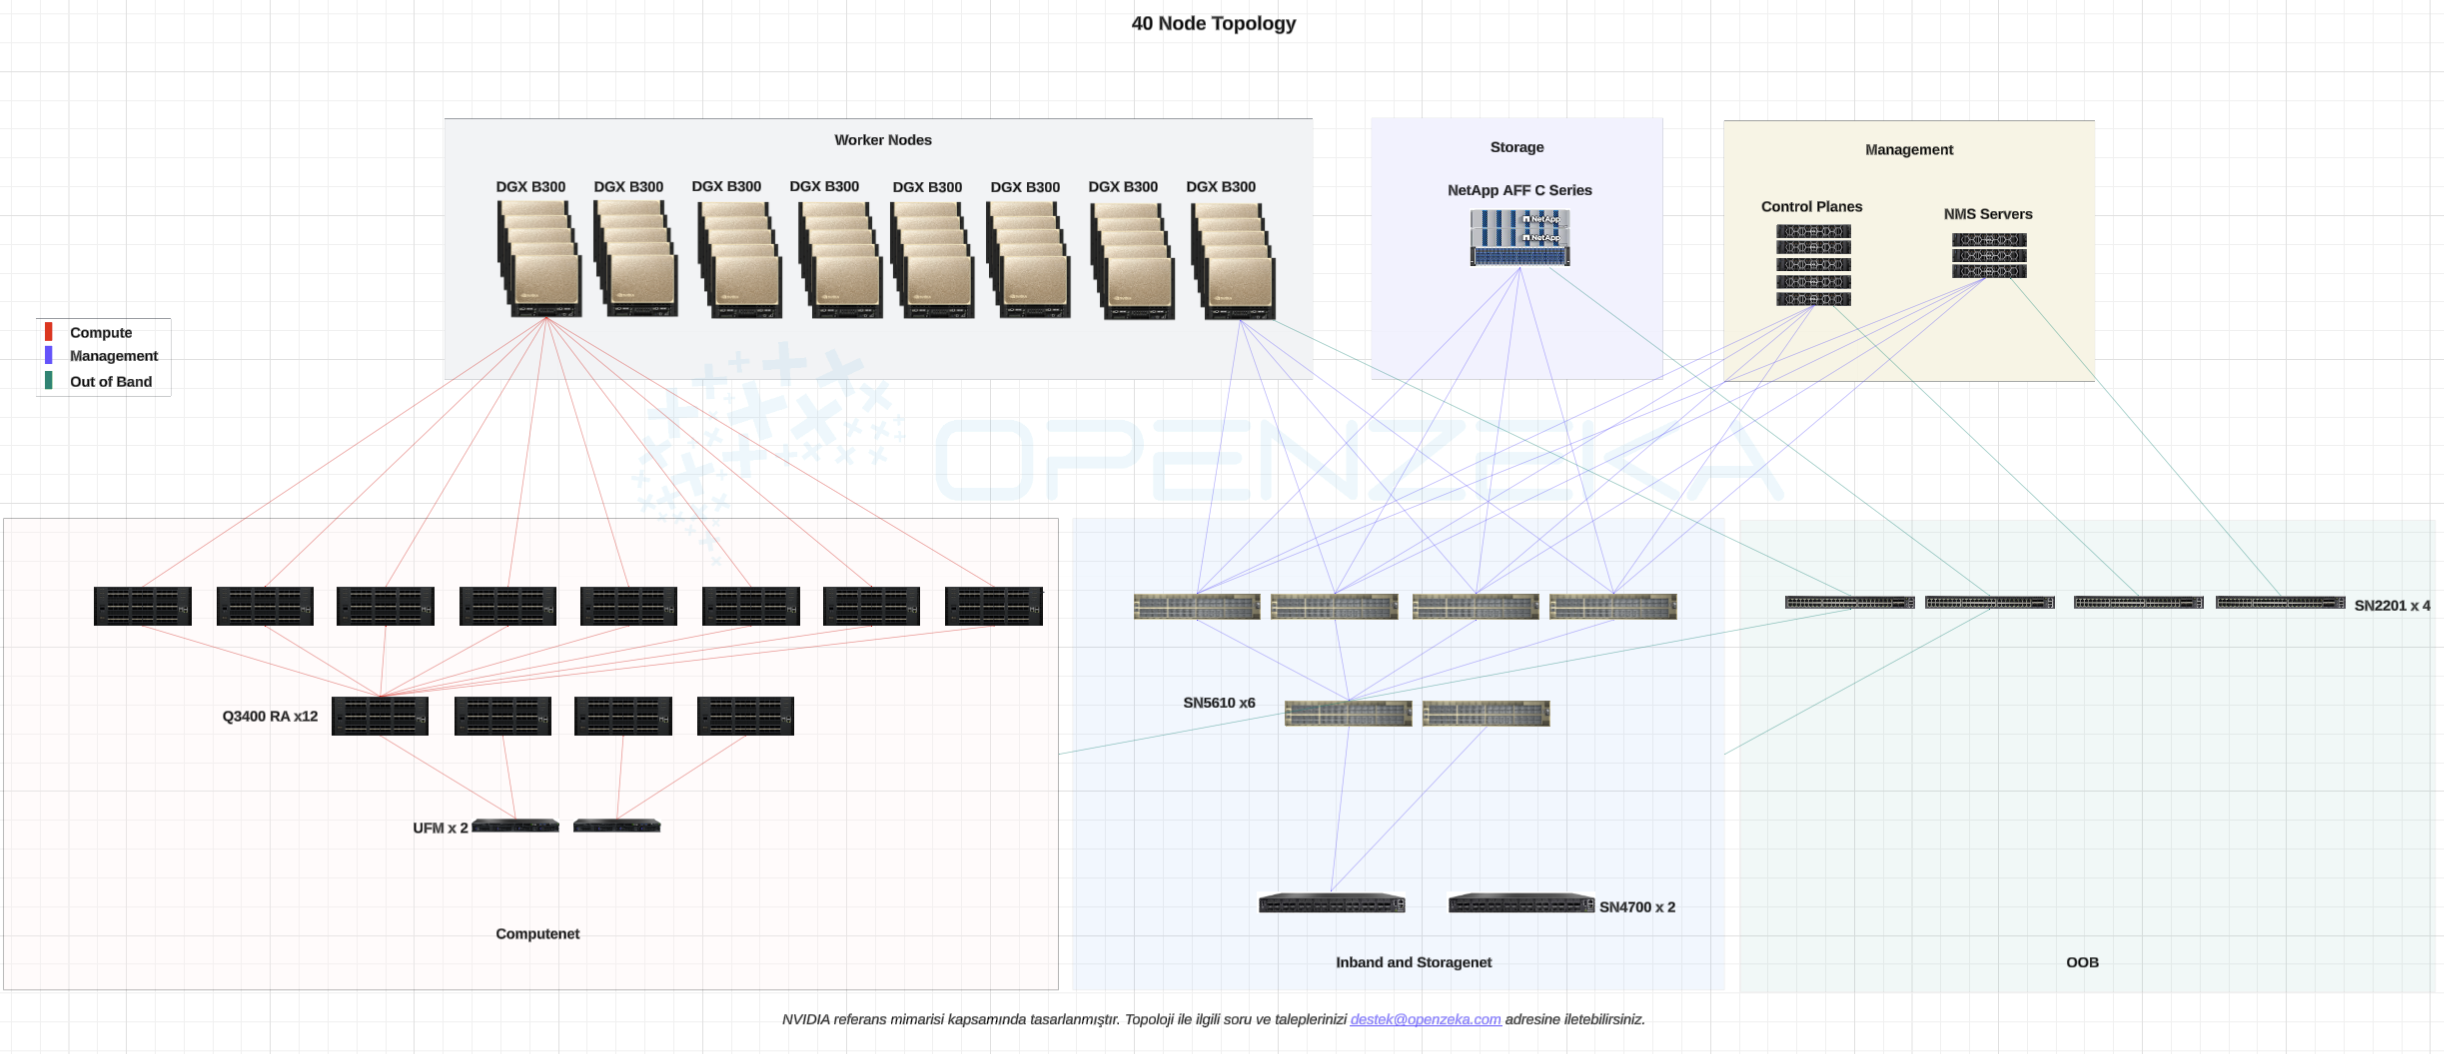
Figuur 1: Voorbeeld van een DGX B300-clustertopologie — Compute Fabric (Quantum-X800 IB), In-band/Storage- en OOB-netwerken
In deze topologie is elke DGX B300-node via 8 × 800 Gb/s InfiniBand-links verbonden met de Compute Fabric. Opslag- en beheerverkeer loopt over een apart Ethernet-netwerk. Het OOB-netwerk transporteert al het BMC- en switchbeheerverkeer.
7. Netwerkarchitectuur van GB300 NVL72
Voor de voorbeeldconfiguratie met vier racks:
72 compute trays / 288 GPU’s
NVIDIA Enterprise RA gebruikt Spectrum-X Ethernet voor de computefabric.
7.1 GPU-computenetwerk (east/west)
Voorbeeldstructuur die compatibel is met NVIDIA Enterprise RA:
- 16 × SN5610 leaf
- 8 × SN5610 spine
Totaal:
24 × SN5610
Het computenetwerk is ontworpen als twee gescheiden planes.
Elke ConnectX-8-verbinding van 800G wordt opgesplitst in:
2 × 400G
verdeeld over twee gescheiden planes.
Deze structuur zorgt voor:
- minder SPOF’s
- padredundantie
- load balancing voor NCCL
- railoptimalisatie
7.2 CPU converged-netwerk (north/south)
GB300 Enterprise RA omvat een aparte CPU Converged North/South Fabric.
Voorbeeld voor vier racks:
- 4 × SN5610 leaf
- 2 × SN5610 spine
Totaal:
6 × SN5610
Deze fabric transporteert:
- in-band-beheer
- opslag
- klantnetwerk
- supportserver
- CPU-communicatie
De dual-port BlueField-3-DPU op elke compute tray is voor padredundantie aangesloten op twee afzonderlijke switches.
De compute- en converged fabrics samen:
24 + 6 = 30 × SN5610
7.3 OOB-netwerk
NVIDIA gebruikt twee SN2201-switches per NVL72-rack.
Voor vier racks:
4 × 2 = 8 × SN2201
Het OOB-netwerk biedt fysiek gescheiden 1 GbE-beheertoegang voor:
- BMC van de compute trays
- BlueField-BMC
- beheer van de NVLink-switches
- overige beheerendpoints in het rack
7.4 Voorbeeldtopologie GB300 NVL72
Hieronder staat een voorbeeld van een GB300 NVL72-clustertopologie:
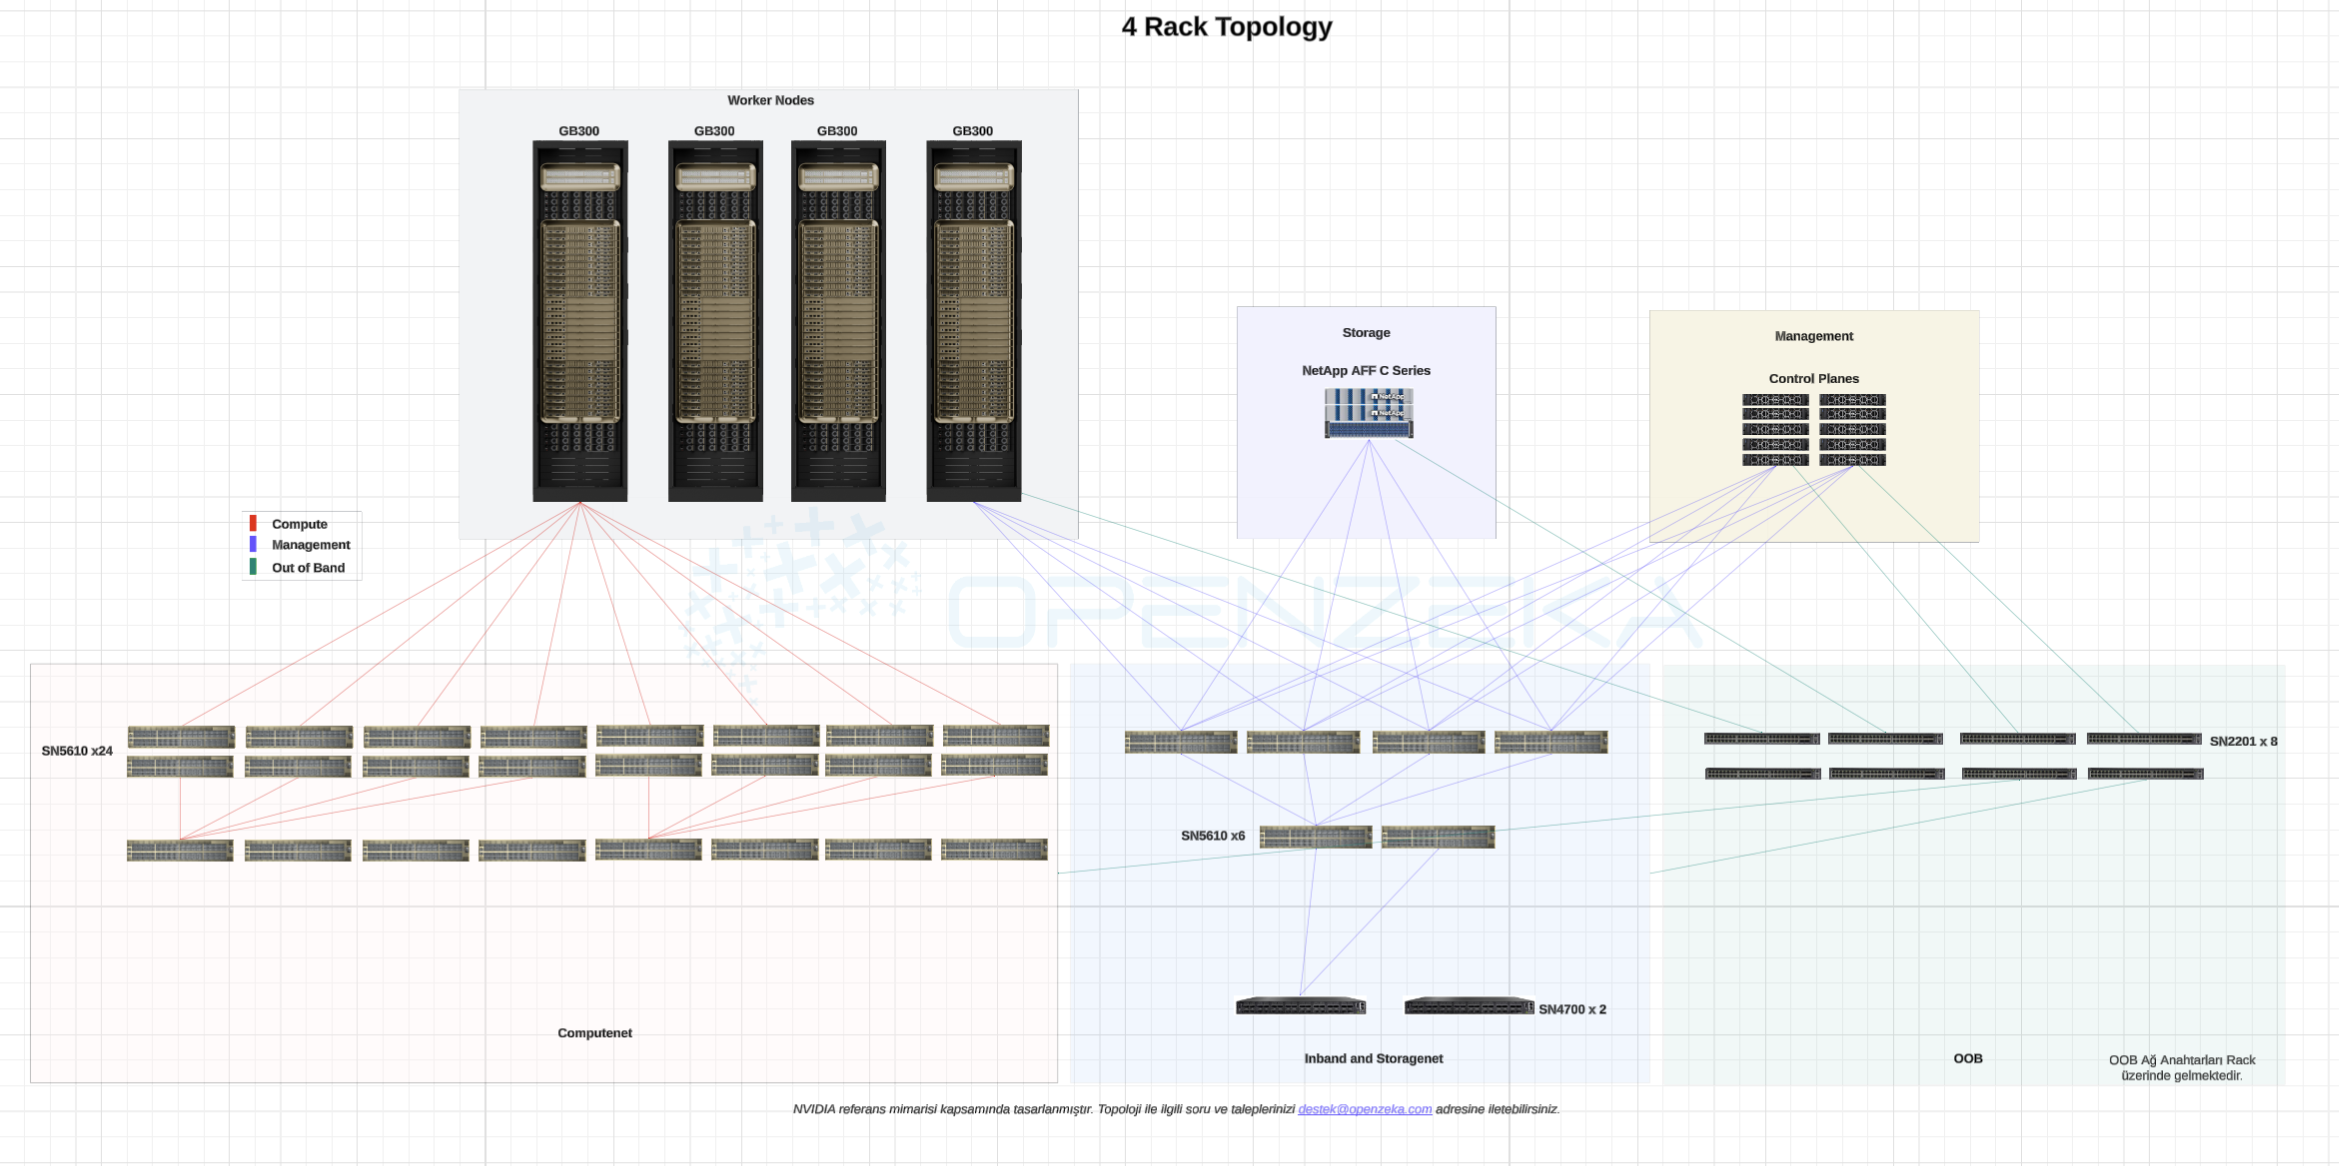
Figuur 2: Voorbeeld van een GB300 NVL72-clustertopologie — GPU Compute Fabric (Spectrum-X), CPU Converged- en OOB-netwerken
In deze topologie zijn de 18 compute trays van elk NVL72-rack met elkaar en met andere racks verbonden via een Spectrum-X Ethernet-fabric met twee planes. Het NVLink-domein omvat de 72 GPU’s binnen het rack; communicatie tussen racks verloopt via Ethernet.
8. Stroom- en koelingsvereisten
8.1 Stroom en koeling van GB300 NVL72
GB300 NVL72 is geen traditioneel serverrack. Het is een systeem op rackschaal met geïntegreerde componenten voor stroomdistributie met hoge dichtheid en vloeistofkoeling.
Het systeem omvat:
- vloeistofgekoelde compute trays,
- vloeistofgekoelde NVLink-switch trays,
- een koelmanifold in het rack,
- power shelves,
- stroomdistributie in het rack op basis van een DC-busbar
Volgens NVIDIA’s huidige Enterprise RA kan een volledig GB300 NVL72-rack tot 142 kW vermogen vereisen. Volgens OEM- en analistenbronnen ligt het rackvermogen tussen 132–142 kW, met een piekvermogen van ongeveer 155 kW.
DLC (Direct Liquid Cooling) is verplicht voor GB300 NVL72. “Fully liquid-cooled” betekent niet dat 100% van de warmte naar de vloeistof gaat; in NVL72-racks wordt ongeveer 90% van de warmte aan de vloeistof en 10% aan de lucht afgegeven (OSFP-modules, opslag, PDB).
De voedingsstroom van het rack bedraagt 60 A.
Bij de keuze voor GB300 moet de datacenterinfrastructuur worden beoordeeld op:
- AC-stroomcapaciteit met hoge dichtheid naar het rack,
- CDU-capaciteit,
- infrastructuur voor aan- en afvoer van koelwater van de faciliteit,
- vloeistofkoelingsaansluitingen die compatibel zijn met het geïntegreerde manifold van het rack,
- gewicht van het rack,
- draagvermogen van de vloer,
- A/B-voeding en redundantie van de stroomvoorziening stroomopwaarts
De power shelf, DC-busbar en koelmanifold maken deel uit van het systeem en hoeven niet apart te worden geïnstalleerd.
De belangrijkste fysieke geschiktheidscriteria voor de keuze van GB300 zijn daarom of de faciliteit kan voldoen aan de vereiste vermogensdichtheid per rack, stroomredundantie en eisen voor vloeistofkoeling.
8.2 Stroom en datacentercompatibiliteit van DGX B300
DGX B300 verbruikt ongeveer 14.5 kW en is 10 RU groot. De TDP per GPU is 1,400 W.
DGX B300 is leverbaar in luchtgekoelde en vloeistofgekoelde configuraties. De architectuur in dit document gebruikt de luchtgekoelde DGX B300. Ondanks een TDP van 1,400 W per GPU kan het systeem in een vormfactor van 10 RU met luchtkoeling worden gebruikt. Dat is een belangrijk voordeel: in de bestaande datacenterinfrastructuur is geen investering in vloeistofkoeling (DLC) nodig.
Het referentieontwerp van NVIDIA SuperPOD plaatst vier DGX B300’s per rack, wat neerkomt op een vermogensdichtheid van ongeveer 56 kW/rack. NVIDIA vermeldt uitdrukkelijk dat het aantal DGX-eenheden per rack kan worden verlaagd op basis van de bestaande stroom- en koelingslimieten van het datacenter. Als de vermogensdichtheid per rack onvoldoende is, kan het aantal DGX B300’s per rack dienovereenkomstig worden verminderd.
Dit document gebruikt 4 GB300 NVL72-racks en 40 DGX B300-servers als referentie voor de vergelijking.
8.3 Vereisten aan de DC-infrastructuur
| Vereiste | DGX B300 | GB300 NVL72 |
|---|---|---|
| Rackvermogen | ~14.5 kW/node | 132–142 kW/rack (piek ~155) |
| Koeling | Luchtgekoeld | DLC verplicht (90% vloeistof / 10% lucht) |
| Voeding rack | Standaard | 60 A |
| Rackstandaard | Traditioneel EIA-rack mogelijk | Speciale OCP-/rackschaalinfrastructuur |
| CDU | Niet vereist | Vereist |
| Koelwater van de faciliteit | Niet vereist | Vereist (aan- en afvoer) |
9. Virtualisatie en het delen van GPU’s
Dit onderwerp vormt een van de belangrijkste verschillen tussen de twee systemen.
9.1 DGX B300
DGX B300 gedraagt zich meer als een klassieke x86-server, waardoor het een logischere keuze is voor virtualisatie en integratie met diverse infrastructuurplatforms.
Voor B300 publiceert NVIDIA specifieke MIG-partitie-opties:
- 2×140 GB
- 4×70 GB
- 7×34 GB
Deze partities bieden isolatie op hardwareniveau voor multi-tenant workloads in datacenter en cloud. In hoeveel geheugen per tenant een GPU van 288 GB wordt verdeeld, is een directe input voor de capaciteitsplanning.
Aan de bare-metal Kubernetes-/Run:ai-zijde is GPU-toewijzing (allocation) als:
- volledige GPU
- MIG
- delen op basis van de scheduler
een natuurlijker gebruiksmodel.
9.2 GB300 NVL72
Aan de GB300-zijde is de aanpak anders.
NVIDIA Enterprise RA definieert de GB300-oplossing uitdrukkelijk voor:
Kubernetes, Slurm en niet-gevirtualiseerde workloads
Het is daarom niet juist om GB300 te zien als een klassiek:
“72 GPU’s beschikbaar, laten we ze op VMware in honderden vGPU’s opdelen”
platform.
Het primaire mechanisme om GB300 te delen is workloadscheduling via:
- Slurm
- Run:ai
- Kubernetes
- rekening houden met NVLink-domeinen / -partities
De documentatie van Mission Control vermeldt uitdrukkelijk dat bij Multi-Node NVLink-systemen zoals GB300 rekening moet worden gehouden met de concepten NVLink Domains en NVLink Partitions wanneer ze via Run:ai en Slurm als gedeelde resources worden gebruikt.
Daarom:
DGX B300 = flexibeler voor partitionering op GPU-niveau en traditionele pooling van serverresources
GB300 = sterker in het partitioneren van GPU-domeinen op rackschaal en scheduling op jobniveau
10. Technische vergelijking DGX B300 vs GB300 NVL72
| Kenmerk | DGX B300 | GB300 NVL72 |
|---|---|---|
| Architectuureenheid | Zelfstandige server | Systeem op rackschaal |
| GPU / systeem | 8 × B300 | 72 × B300 / rack |
| CPU | 2 × Intel Xeon 6776P | 36 × NVIDIA Grace (2592 Neoverse V2) |
| CPU-architectuur | x86 | ARM64 |
| VRAM per GPU | 288 GB (HGX: ~262 GB bruikbaar) | 288 GB (HGX: ~262 GB bruikbaar) |
| Totaal geheugen systeem/rack | ~2.3 TB (HGX) | 20 TB |
| Geheugen-BW per GPU | 8 TB/s | 8 TB/s |
| NVLink-domein | 8 GPU’s | 72 GPU’s |
| Totale NVLink-BW (systeem/rack) | 14.4 TB/s | 130 TB/s |
| FP4 sparse (systeem/rack) | 144 PF | 1,440 PF |
| FP4 dense (systeem/rack) | 108 PF | 1,080 PF |
| TDP per GPU | 1,400 W | 1,400 W |
| Scale-up | 8 GPU’s | 72 GPU’s |
| Scale-out | Quantum-X800 IB | Spectrum-X Ethernet |
| Compute-NIC | 8 × CX-8 / DGX | 4 × CX-8 / tray |
| Computefabric | Quantum-X800 IB | Spectrum-X Ethernet |
| Computeswitch | Q3400-RA | SN5610 |
| Storage/In-band | SN5610 | SN5610 |
| OOB | SN2201 | SN2201 |
| Fabricmanager | UFM + nv-fabricmanager |
nv-fabricmanager + NetQ / Mission Control |
| UFM | Vereist, IB wordt gebruikt | Niet vereist, Spectrum-X-ontwerp |
| NetQ | Voor Ethernet-monitoring | Kerncomponent voor netwerkobservability |
| MIG | ✓ (2×140 / 4×70 / 7×34 GB) | Afhankelijk van de architectuur |
| Confidential Computing | ✓ TEE-I/O (1/2/4/8 GPU) | ✓ TEE-I/O |
| Transformer Engine | 2e generatie (FP4/NVFP4) | 2e generatie (FP4/NVFP4) |
| Tensor Core | 5e generatie | 5e generatie |
| Procesnode | TSMC 4NP | TSMC 4NP |
| Koeling | Luchtgekoeld (in dit ontwerp) | Rack met directe vloeistofkoeling (DLC verplicht) |
| Vermogen | ~14.5 kW / DGX | 132–142 kW/rack (piek ~155) |
| Rackstandaard | Traditioneel EIA-rack mogelijk | Speciale OCP-/rackschaalinfrastructuur |
| Granulariteit van deployment | 1 server tegelijk | Gericht op rack/SU |
| CPU-ISA van het OS | x86 | ARM64 |
| Fysieke service-isolatie | Per server | Per tray/rack |
| Scale-up voor grote modellen | 8 GPU’s, daarna netwerk | Tot 72 GPU’s via NVLink |
11. Platformkeuze op basis van workload
| Workload / vereiste | DGX B300 | GB300 NVL72 | Aanbeveling |
|---|---|---|---|
| Inferentie op één GPU | ★★★★★ | ★★ | B300 |
| Inferentie op 2-8 GPU’s | ★★★★★ | ★★★ | B300 |
| Inferentie van grote modellen | ★★★★ | ★★★★★ | GB300 |
| Zeer groot reasoningmodel | ★★★ | ★★★★★ | GB300 |
| Training op één node | ★★★★★ | ★★★★ | B300 |
| Training tot 8 GPU’s | ★★★★★ | ★★★★ | B300 |
| Training over meerdere nodes | ★★★★★ | ★★★★★ | Afhankelijk van de workload |
| Training van zeer grote LLM’s | ★★★★ | ★★★★★ | GB300 |
| Model met een biljoen parameters | ★★★ | ★★★★★ | GB300 |
| MoE-training | ★★★★ | ★★★★★ | GB300 |
| Fine-tuning | ★★★★★ | ★★★★★ | Beide |
| Kleine LoRA-/QLoRA-jobs | ★★★★★ | ★★★ | B300 |
| Veel onafhankelijke gebruikers | ★★★★★ | ★★★★ | B300 |
| GPU-partitionering / MIG | ★★★★★ | Afhankelijk van de architectuur | B300 |
| Kubernetes | ★★★★★ | ★★★★★ | Beide |
| Run:ai | ★★★★★ | ★★★★★ | Beide |
| Slurm | ★★★★★ | ★★★★★ | Beide |
| HPC | ★★★★★ | ★★★★★ | Afhankelijk van de workload |
| x86-HPC-applicatie | ★★★★★ | ★★ | B300 |
| ARM-native HPC | ★★★ | ★★★★★ | GB300 |
| CFD-/CAE-simulatie | ★★★★★ | ★★★ | Doorgaans B300 |
| AI + simulatie | ★★★★★ | ★★★★ | Doorgaans B300 |
| Omvangrijk cluster uitsluitend voor AI | ★★★★ | ★★★★★ | GB300 |
| Zeer groot NVLink-domein | ★★ | ★★★★★ | GB300 |
| Lage vermogensdichtheid per rack | ★★★★ | ★ | B300 |
| AI-fabriek met zeer hoge dichtheid | ★★★ | ★★★★★ | GB300 |
| Stapsgewijze uitbreiding | ★★★★★ | ★★ | B300 |
| Kant-en-klare compute op rackschaal | ★★★ | ★★★★★ | GB300 |
12. Vergelijking vanuit trainingsperspectief
Voor training moet de keuze worden gebaseerd op de modelgrootte en de communicatiepatronen.
Als het model:
- binnen 8 GPU’s past
- veel onafhankelijke jobs heeft
- honderden kleine/middelgrote trainingsjobs gelijktijdig draaien
kan DGX B300 een efficiënter gebruik van de resources opleveren.
Als het model daarentegen:
- tientallen GPU’s vereist
- een hoge mate van tensorparallellisme heeft
- expertparallellisme gebruikt
- veel all-reduce-/all-to-all-verkeer genereert
wordt het voordeel van GB300 NVL72 met zijn NVLink-domein van 72 GPU’s duidelijk.
Perspectief van dense FP4:
B300 levert 13.5 PF dense FP4 per GPU. Een DGX B300-systeem heeft 8 × 13.5 = 108 PF, terwijl een GB300 NVL72-rack 72 × 13.5 = 1,080 PF aan dense FP4-rekenkracht heeft. Selectiebeslissingen moeten op de dense waarden worden gebaseerd; sparse waarden geven alleen de theoretische piekcapaciteit aan en zijn voor de meeste workloads in productie niet volledig haalbaar.
De 2× hogere attention-prestaties van B300 ten opzichte van Blackwell zijn het duidelijkst bij trainingsworkloads met lange context en reasoning. Deze winst komt voort uit een verdubbeling van de doorvoer van de SFU (Special Function Unit) voor belangrijke instructies die in attention-lagen worden gebruikt.
13. Vergelijking vanuit inferentieperspectief
Voor inferentie is het niet juist om te generaliseren dat “GB300 altijd sneller is”.
Voor kleine en middelgrote modellen die het volgende vereisen:
- veel onafhankelijke replica’s
- endpoints met lage latentie
- MIG
- GPU-isolatie
- multi-tenant serving
is DGX B300 een zeer geschikt platform.
Als echter:
- het model niet op één GPU past
- het meer dan 8 GPU’s vereist
- een grote KV-cache nodig is
- een zeer grote context wordt gebruikt
- het reasoningmodel over tientallen GPU’s moet draaien
wordt de scale-up-architectuur van GB300 NVL72 voordeliger.
13.1 Inferentie over meerdere nodes
LLM-inferentie van de volgende generatie gaat verder dan de aanpak “laad het model op één GPU”.
Vooral bij methoden zoals:
- scheiding van prefill en decode
- tensorparallellisme
- pipelineparallellisme
- expertparallellisme
- gedistribueerde KV-cache
- multi-node serving
worden de prestaties van de interconnect belangrijk.
De huidige integratie van NVIDIA Run:ai met Mission Control omvat ondersteuning voor gedistribueerde inferentie en NVIDIA Dynamo.
GB300 is daarom voordelig voor zeer grote inferentiedeployments over meerdere nodes.
Voor inferentiefarms van middelgrote schaal kan de zelfstandige serverstructuur van B300 flexibeler zijn.
14. Simulatie en HPC
Voor simulatieworkloads is de CPU-architectuur bijzonder belangrijk.
DGX B300 gebruikt:
Intel Xeon / x86
GB300 gebruikt:
Grace / ARM64
Daarom moet de compatibiliteit met ARM64 worden gecontroleerd voor:
- Ansys
- Abaqus
- LS-DYNA
- afgeleiden van OpenFOAM
- propriëtaire solvers
- eigen MPI-applicaties
- simulatiebibliotheken
Als GPU-versnelde simulatiesoftware is geoptimaliseerd voor Grace/ARM64, kan GB300 een zeer krachtig HPC-platform worden.
Als de applicatie echter alleen op x86 is gecertificeerd, is DGX B300 de veiligere keuze.
15. Operationele flexibiliteit
Een van de belangrijkste voordelen van DGX B300 is het kleinere storingsdomein.
Als een DGX B300 voor onderhoud offline wordt gehaald, worden:
8 GPU’s
getroffen.
In het GB300-systeem op rackschaal moet de workloadscheduler rekening houden met het gedrag van trays, NVLink-partities en de rackfabric.
Omgekeerd is GB300 ontworpen om resources op rackschaal per job te beheren via de mechanismen van Mission Control/NVLink-partities.
Risicofactoren:
-
Levertijd en beschikbaarheid: het aanbod is beperkt — de vraag van hyperscalers overtreft de productiecapaciteit, en grote clusters hebben na levering nog eens ~3 maanden nodig voor de deployment. De tijd van bestelling tot verzending verschilt per product en regio; hiervoor moet bevestiging van de distributeur worden verkregen. Omdat deze architectuur de luchtgekoelde DGX B300 gebruikt, is geen infrastructuur voor vloeistofkoeling nodig.
-
Knelpunt in de koeling (rackschaal): GB300 NVL72 vereist naast de GPU-kosten een investering in DLC (CDU, manifold, drycooler) — een CapEx-post. De luchtgekoelde DGX B300 (node met 8 GPU’s) die in deze architectuur wordt gebruikt, vereist deze investering niet.
-
Koppeling van driverbranch en Fabric Manager: het datacenter-SXM/PCIe-segment gebruikt de LTS-branch (Long-Term-Support). De LTS-branch en de versie van Fabric Manager moeten samen worden beheerd; voor de op NVSwitch gebaseerde DGX B300 en GB300 NVL72 moet de bijpassende versie van het pakket
nv-fabricmanagerbeschikbaar zijn vóór een driverupgrade.
16. De keuze tussen ARM64 en x86
Deze keuze gaat niet alleen over CPU-prestaties.
DGX B300
Doordat het x86 is, hebben:
- bestaande bedrijfssoftware
- traditionele virtualisatie
- legacy HPC
- veel commerciële applicaties
een lager integratierisico.
GB300
Met Grace ARM64 bieden:
- hoge CPU-geheugenefficiëntie
- een CPU-architectuur dicht bij de GPU
- energie-efficiëntie op rackschaal
- NVIDIA’s nauw geïntegreerde computearchitectuur
voordelen.
Softwarepijplijnen moeten echter multi-architectuur of ARM64-compatibel zijn.
Daarom wordt aanbevolen de software-inventaris op ARM64-compatibiliteit te analyseren voordat voor GB300 wordt gekozen.
17. Wanneer kiest u voor DGX B300
DGX B300 is in de volgende scenario’s een geschiktere keuze.
1. Heterogene omgeving met veel gebruikers
Als onderzoekers, datawetenschappers, verschillende afdelingen, uiteenlopende GPU-behoeften en onafhankelijke projecten dezelfde infrastructuur delen, biedt DGX B300 een fijnmazigere toewijzing van resources.
2. Virtualisatie is belangrijk
Als een VM-gebaseerde infrastructuur en een meer klassieke cloudaanpak gewenst zijn, is de op B300 gebaseerde architectuur met zelfstandige servers geschikter.
3. Er is een afhankelijkheid van x86
Als eigen software, simulatieapplicaties, legacy HPC-code, binaries van leveranciers en x86-containerimages niet op ARM64 zijn gevalideerd, is DGX B300 de keuze met het laagste risico.
4. Stapsgewijze groei is gewenst
De uitbreidingsgranulariteit van DGX B300 is:
8 GPU’s
terwijl de natuurlijke bouwsteen van GB300 op het niveau ligt van:
een rack met 72 GPU’s
Als de capaciteit naar verwachting over meerdere jaren groeit, kan DGX flexibeler zijn.
5. De vermogensdichtheid van het datacenter is beperkt
De rackdichtheid van DGX B300 kan worden verlaagd om aan te sluiten bij de bestaande faciliteitsinfrastructuur.
GB300 vereist een faciliteitsinfrastructuur die een rackdichtheid van ~100 kW+ ondersteunt.
6. HPC en AI naast elkaar
Workflows die simulatie en AI combineren en een x86-CPU vereisen, vormen een sterke use case voor DGX B300.
Bijvoorbeeld:
CFD → AI-surrogaatmodel → inferentie
of:
CAE → synthetische data → training
Zulke workflows kunnen profiteren van compatibiliteit met x86-CPU’s.
18. Wanneer kiest u voor GB300 NVL72
GB300 NVL72 biedt duidelijke voordelen in de volgende scenario’s.
1. Training van zeer grote LLM’s
Als het model niet op één node of binnen 8 GPU’s past, nemen de communicatiekosten toe.
GB300 heeft 72 GPU’s in hetzelfde NVLink-domein en biedt zo een hoge scale-up-bandbreedte voor zeer grote modellen.
2. Grote MoE-modellen
Mixture-of-Experts-modellen genereren veel all-to-all-communicatie tussen GPU’s.
Een groot NVLink-domein biedt hier een aanzienlijk voordeel.
3. Grote inferentie- / reasoningmodellen
Op de schaal van honderden miljarden of biljoenen parameters kunnen workloads zoals:
- modelparallelle inferentie
- reasoning
- inferentie met lange context
- gedisaggregeerde inferentie
profiteren van zeer grote GPU-groepen.
NVIDIA positioneert Enterprise RA specifiek voor realtime inferentie en training/fine-tuning met biljoenen parameters. GB300 NVL72 levert ten opzichte van Hopper 5× TPS per MW, 10× TPS per gebruiker en 50× de output van een AI-fabriek.
4. Minder netwerkcommunicatie
Bij DGX B300 gaat het verkeer na 8 GPU’s naar de externe fabric.
Bij GB300:
kan het verkeer tot 72 GPU’s binnen het NVLink-domein blijven.
Dit verschil is aanzienlijk voor modelparallelle workloads.
5. Er is een groter enkelvoudig computedomein nodig
Bij GB300 gaat het minder om “72 afzonderlijke GPU’s kopen” en meer om:
een computer op rackschaal met 72 GPU’s kopen
Voor workloads die een zeer groot acceleratordomein vereisen, is het een klasse apart.
19. Welk platform wanneer?
Kies DGX B300 als:
- het bestaande datacenter geen hoge vermogensdichtheid per rack ondersteunt,
- x86 vereist is,
- VM’s belangrijk zijn,
- GPU-resources in kleine delen over gebruikers moeten worden verdeeld,
- de workloads heterogeen zijn,
- jobs op 1-8 GPU’s de meerderheid vormen,
- capaciteitsuitbreiding in de loop van de tijd gewenst is,
- simulatie/HPC en AI op dezelfde infrastructuur draaien,
- veel onafhankelijke onderzoeksgroepen worden bediend.
Kies GB300 NVL72 als:
- training van grote en zeer grote LLM’s de primaire workload is,
- de grens van 8 GPU’s vaak wordt overschreden,
- een scale-up-domein van 72 GPU’s kan worden benut,
- zeer grote reasoning-/inferentiemodellen worden uitgerold,
- er MoE-workloads en workloads met intensieve communicatie tussen GPU’s zijn,
- een vermogen van de klasse 120-142 kW per rack beschikbaar is,
- infrastructuur voor directe vloeistofkoeling aanwezig is of kan worden gebouwd,
- compatibiliteit van de software met ARM64 is gewaarborgd,
- het primaire doel van de AI-fabriek maximale scale-up-prestaties is.
20. Wanneer is een hybride architectuur zinvol?
Een hybride aanpak is een optie die het overwegen waard is wanneer beide platforms nodig zijn.
In een hybride structuur:
DGX B300-pool
- werkruimte voor onderzoekers
- ontwikkeling
- fine-tuning
- LoRA/QLoRA
- kleine/middelgrote inferentie
- simulatie
- MIG
- VM’s
- onafhankelijke projectworkloads
GB300 NVL72-pool
- training van foundation models
- grootschalige gedistribueerde training
- grootschalige reasoning
- omvangrijke inferentie
- MoE
- modelparallelle workloads
In de bovenste laag kunnen:
- Mission Control
- BCM
- Run:ai
- Kubernetes
- Slurm
gebruikers naar de juiste resourcepool leiden, zonder dat zij de fysieke infrastructuur hoeven te kennen.
Deze aanpak combineert de sterke punten van beide platforms.
21. Beknopte beslissingstabel
| Prioriteit | Aanbevolen platform |
|---|---|
| Maximale prestaties voor grote modellen | GB300 NVL72 |
| Maximale flexibiliteit in gebruik | DGX B300 |
| Veel gebruikers / veel workloads | DGX B300 |
| NVLink-domein van 72 GPU’s | GB300 NVL72 |
| VM’s | DGX B300 |
| Intensief gebruik van MIG | DGX B300 |
| Traditionele HPC | DGX B300 |
| ARM-native HPC | GB300 NVL72 |
| Training met biljoenen parameters | GB300 NVL72 |
| Grootschalige reasoning-inferentie | GB300 NVL72 |
| Simulatie + AI | DGX B300 |
| Bestaand bedrijfsdatacenter | DGX B300 |
| Speciaal gebouwde AI-fabriek | GB300 NVL72 |
| Stapsgewijze investering | DGX B300 |
| Maximale computedichtheid per rack | GB300 NVL72 |
| Diverse workloads in dezelfde organisatie | Hybride |
22. Conclusie
DGX B300 en GB300 NVL72 gebruiken dezelfde GPU-generatie, maar vertegenwoordigen twee verschillende ontwerpfilosofieën.
DGX B300 is een AI-server.
Het systeem is zelfstandig, op x86 gebaseerd en schaalt in kleine stappen. Het is zeer flexibel voor het verdelen van GPU-resources in kleinere eenheden over verschillende gebruikers en workloads, voor integratie met de bestaande bedrijfsinfrastructuur en voor het draaien van uiteenlopende AI-/HPC-applicaties op hetzelfde platform.
GB300 NVL72 is een AI-computer op rackschaal.
Het belangrijkste voordeel is niet het aantal GPU’s, maar dat 72 GPU’s binnen één NVLink-domein kunnen werken. Dit levert aanzienlijke schaalvoordelen op voor de training van grote modellen, reasoning, MoE en gedistribueerde workloads met intensieve communicatie.
De keuze moet daarom niet simpelweg zijn:
“Afzonderlijke servers met 8 GPU’s of racks met 72 GPU’s?”
De werkelijke vergelijking moet zijn:
Worden de GPU’s gebruikt als onafhankelijke NVLink-domeinen van 8 GPU’s of als NVLink-domeinen van 72 GPU’s — en wat past het best bij de doelworkloads?
Als het workloadportfolio breed is, het aantal gebruikers hoog is en de resourcebehoeften heterogeen zijn, is DGX B300 de evenwichtigere keuze.
Als het primaire doel zeer grote foundation models, gedistribueerde training, MoE en grootschalige inferentie is, en het datacenter de vereiste infrastructuur voor stroom en vloeistofkoeling kan leveren, is GB300 NVL72 de geschiktere architectuur.
Als beide klassen workloads belangrijk zijn, biedt een hybride architectuur met DGX B300 + GB300 NVL72 de meest flexibele technische aanpak.