Opgesteld door: Aetherix B.V. — Trusted Jetson Hardware Provider for Edge AI
Testplatform: NVIDIA DGX Spark (GB10) · Model: Qwen3.6-27B · Rapportdatum: juli 2026
Inhoud
- 1. Inleiding en testmethodologie
- 2. Prestaties van de kwantisatievarianten
- 3. Vergelijking van de kwantisatieformaten
- 4. Diepgaande analyse van het MTP-effect
- 5. Analyse van het effect van gelijktijdigheid
- 6. Analyse van schaalbaarheid en GPU-efficiëntie
- 7. Staartlatentie en stabiliteit
- 8. Optimaal werkpunt en aanbevelingen
- 9. Conclusie
- Bijlage A: Kwantitatieve impact van de hardwaretekortkomingen van SM121
- Bijlage B: Grafieken per variant
- Over ons — Aetherix
1. Inleiding en testmethodologie
1.1 Introductie van het model
Qwen3.6-27B is een groot taalmodel met 27 miljard parameters uit de Qwen-familie van Alibaba. Deze versie, ontwikkeld na de Qwen3.5-serie op basis van feedback uit de community, biedt aanzienlijke verbeteringen, met name op het gebied van agentic coding (front-end-workflows en reasoning op repositoryniveau) en thinking preservation (het behouden van de reasoning-context uit eerdere berichten).
Dit rapport evalueert de prestaties van hetzelfde model met verschillende kwantisatieformaten (quantization) en MTP-configuraties (Multi-Token Prediction) op het NVIDIA DGX Spark-platform.
Modelarchitectuur:
| Parameter | Waarde |
|---|---|
| Aantal parameters | 27B |
| Verborgen dimensie (hidden dimension) | 5120 |
| Aantal lagen | 64 |
| Indeling van de architectuur | 16 × (3 × Gated DeltaNet → FFN → 1 × Gated Attention → FFN) |
| DeltaNet-attention-heads | V: 48, QK: 16, Head dim: 128 |
| Gated Attention-heads | Q: 24, KV: 4, Head dim: 256 |
| RoPE-dimensie | 64 |
| Tussenliggende FFN-grootte | 17408 |
| Grootte van de token-embedding | 248320 (padded) |
| Contextlengte (context length) | 262,144 tokens (native), met YaRN uit te breiden tot 1,010,000 |
| MTP-ondersteuning | Ondersteund, met multi-step-training |
| Visuele encoder | Aanwezig (Image-Text-to-Text) |
Opmerking: In het kader van deze benchmark is uitsluitend tekstinvoer/-uitvoer gebruikt; de visuele encoder is niet actief.
1.2 Geteste varianten
| Variant | Kwantisatie | MTP | Beschrijving |
|---|---|---|---|
| FP8 | FP8 (8-bit floating point) | Geen | Floating-point-kwantisatie met 8 bits |
| FP8-MTP | FP8 | Ja | FP8 + multi-token prediction |
| AWQ-MTP | AWQ (Activation-aware Weight Quantization) | Ja | Activatiebewuste gewichtskwantisatie + MTP |
| NVFP4 | NVFP4 (NVIDIA-formaat met 4 bits) | Geen | NVIDIA-specifieke 4-bitkwantisatie |
| NVFP4-MTP | NVFP4 | Ja | NVFP4 + multi-token prediction |
Opmerking: Van de AWQ-variant is geen test zonder MTP beschikbaar. Een directe vergelijking van het MTP-effect is daarom alleen mogelijk voor FP8 en NVFP4.
1.3 Kwantisatieformaten
- FP8 (Float8): Floating-point-getalformaat met 8 bits. Zet de modelgewichten (weights) om van BF16 naar FP8. De kwantisatiemethode die Qwen toepast, is fijnmazige (fine-grained) FP8-kwantisatie met een blokgrootte van 128; de prestatiemetrieken zijn vrijwel identiek aan die van het oorspronkelijke model. Het precisieverlies is minimaal. Omdat FP8 8 bits per gewicht gebruikt, halveert het de modelgrootte en de benodigde geheugenbandbreedte (memory bandwidth) ten opzichte van het oorspronkelijke BF16-model; het is echter ~2x groter dan de 4-bitformaten (AWQ, NVFP4) in dit rapport en vraagt meer geheugenbandbreedte — de belangrijkste reden waarom NVFP4 FP8 overtreft in de decode-fase (geheugengebonden) (zie paragraaf 3.1). Bron:
Qwen/Qwen3.6-27B-FP8 - AWQ (Activation-aware Weight Quantization): Een methode die de gewichten naar 4-bit kwantiseert maar de activaties behoudt. Alleen de gewichten worden gekwantiseerd; de activaties blijven op volledige precisie. Dit bespaart geheugenbandbreedte. Tijdens runtime zet vLLM AWQ-gewichten automatisch om naar de Marlin-kernel; deze versnelling op hardwareniveau is een van de belangrijkste redenen voor het prestatievoordeel in de decode-fase. Bron:
shawnw3i/Qwen3.6-27B-AWQ-MTP - NVFP4 (NVIDIA Float4): Floating-point-formaat met 4 bits dat NVIDIA heeft geoptimaliseerd voor de Blackwell-architectuur. Biedt de hoogste compressieverhouding, met ondersteuning voor versnelling op hardwareniveau. Het is gekalibreerd op de UltraChat-dataset, voorbereid met sequenties tot 16K contextlengte en een kalibratiebudget van ongeveer 2M tokens. Doordat de kalibratie gebaseerd is op een op chat gerichte UltraChat-verdeling, kan het nauwkeurigheidsgedrag in andere domeinen (bijv. code, wiskunde) worden beïnvloed; omdat deze benchmark alleen snelheid meet, is dat effect niet geëvalueerd. Bron:
unsloth/Qwen3.6-27B-NVFP4
1.4 Wat is MTP (Multi-Token Prediction)?
MTP is een techniek waarmee het model meerdere tokens per forward pass kan voorspellen. Waar traditionele autoregressieve modellen per stap slechts één token genereren, kunnen met MTP meerdere tokens per stap worden gegenereerd. Dit verhoogt de tokengeneratiesnelheid (TPS) aanzienlijk en verlaagt tegelijk de inter-token-latentie (ITL).
Hoe MTP werkt:
- Bij elke decode-stap genereert het model N tokens
- De gegenereerde tokens worden gecontroleerd met een verificatiemechanisme
- Correct voorspelde tokens worden direct aan de uitvoer toegevoegd
- Onjuiste voorspellingen worden verworpen en opnieuw gegenereerd
1.5 Definities van de metrieken
| Metriek | Eenheid | Beschrijving |
|---|---|---|
| TTFT (Time To First Token) | ms | De tijd die verstrijkt tussen het verzenden van het verzoek en de generatie van het eerste token. Weerspiegelt de snelheid van de prefill-fase. |
| ITL (Inter-Token Latency) | ms | De vertraging tussen twee opeenvolgende tokens. Weerspiegelt de snelheid van de decode-fase. |
| TPS (Tokens Per Second) | tokens/s | Het gemiddelde aantal tokens dat per seconde wordt gegenereerd. De waargenomen snelheid aan de kant van de gebruiker. |
| Latentie (latency) | s | De totale tijd vanaf het begin van een verzoek tot de voltooiing ervan (end-to-end). |
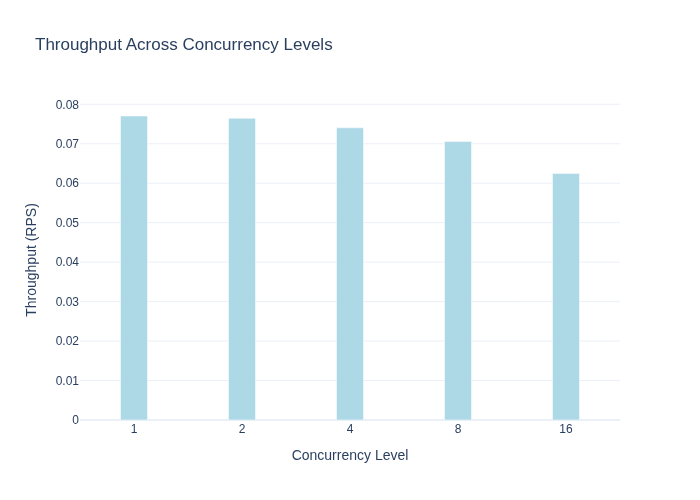
| Doorvoer (throughput) | RPS | Definitie per verzoek van de meettool: valid_request_count / Σ(latency) = 1 / average_latency. Dit is de voltooiingssnelheid per seconde van één enkele verzoekstroom; het is NIET de totale werkcapaciteit (fleet) van het systeem. |
⚠️ Belangrijk — Correcte interpretatie van de metriek “Throughput (RPS)”: De gebruikte meettool (CordatusAI/llm-benchmark) berekent deze waarde in de broncode als
throughput = valid_request_count / Σ(latency_i); dit is algebraïsch gelijk aan1 / average_latencyen is per definitie onafhankelijk van de gelijktijdigheid (concurrency). Met andere woorden: dat de metriek vlak blijft, bewijst niet dat de GPU niet schaalt — het weerspiegelt alleen dat één enkele stroom de inverse van de latentie meet. De werkelijke totale capaciteit van het systeem wordt gemeten alsTPS × Concurrency(totaal aantal tokens/s) ofConcurrency / average_latency(totale RPS) en neemt duidelijk toe met de gelijktijdigheid (zie paragrafen 5.5 en 6.1). Dit onderscheid is cruciaal voor de interpretaties van gelijktijdigheid in dit rapport (paragrafen 5.5, 8.2, 9.1).
1.6 Testomstandigheden
- Platform: NVIDIA DGX Spark
- Gelijktijdigheidsniveaus: 1, 2, 4, 8, 16 gelijktijdige verzoeken
- Statistische metingen: Voor elke metriek zijn het gemiddelde, p50 (mediaan) en p90 (90e percentiel) vastgelegd
- Per variant zijn 5 metrieken × 5 gelijktijdigheidsniveaus = 25 datapunten verzameld
1.7 Meettool
Alle metingen zijn uitgevoerd met de opensourcetool CordatusAI/llm-benchmark. Deze tool is een op Streamlit gebaseerde applicatie, ontworpen om de prestaties van LLM-inferentieservers (inference) te meten via de OpenAI-compatibele streaming-API.
Werkwijze:
- Er worden streaming-verzoeken verzonden naar het OpenAI-compatibele endpoint
/v1/chat/completions - Het aantal tokens wordt aan de serverkant geverifieerd met
stream_options={"include_usage": True} - Dankzij ondersteuning voor
reasoning_contentworden ook de reasoning-tokens van reasoning-modellen in de meting meegenomen
Meetparameters:
| Parameter | Waarde | Beschrijving |
|---|---|---|
| Aantal prompts | 100 | Geladen uit het bestand prompts.txt, bij elke run in willekeurige volgorde |
| Promptlengte | ~128 tokens | Elke prompt vraagt expliciet om een antwoord van minstens 128 tokens |
| Maximaal aantal uitvoertokens | 128 | Antwoorden worden bij 128 tokens afgekapt |
| Minimaal aantal rondes | 10 | Minstens 10 rondes per gelijktijdigheidsniveau |
| Totaal aantal verzoeken | 10 × gelijktijdigheid | Concurrency=8 → 80 verzoeken, Concurrency=16 → 160 verzoeken |
| Opwarmen | 1 verzoek | Vóór de benchmark wordt 1 opwarmverzoek verzonden |
| Statistische metingen | Gemiddelde, p50, p90 | Voor elke metriek worden het gemiddelde, de mediaan en het 90e percentiel berekend |
Beperking: Het aantal verzoeken per gelijktijdigheidsniveau is 10 × gelijktijdigheid; bij C=1 worden slechts ~10 samples gemeten. Daarom kunnen vooral de p90-waarden bij lage gelijktijdigheid en de TTFT-schommelingen (bijv. het onregelmatige TTFT-verloop van AWQ-MTP, paragraaf 2.3; de p90/p50-waarde van 1.56 van NVFP4-MTP, paragraaf 7.1) deels ruis door de kleine steekproef weerspiegelen. Voor een definitieve karakterisering van de staartlatentie (tail latency) wordt een nieuwe meting met meer verzoeken aanbevolen.
1.8 Configuratie van de inferentieserver
Alle varianten zijn gedraaid met vLLM v0.22.0 (Docker-image vllm/vllm-openai:v0.22.0-ubuntu2404).
Gemeenschappelijke configuratie:
| Parameter | Waarde |
|---|---|
| Inferentie-engine | vLLM v0.22.0 |
| Docker-image | vllm/vllm-openai:v0.22.0-ubuntu2404 |
| Benutting van het GPU-geheugen | 0.8 (80%) |
| Maximaal aantal gebatchte tokens | 8192 |
| Prefix caching | Ingeschakeld (--enable-prefix-caching) |
| Chunked prefill | Ingeschakeld (--enable-chunked-prefill) |
| Reasoning-parser | qwen3 |
| Tool-call-parser | qwen3_coder |
| API-poort | 8000 |
Opmerking: Bij de NVFP4-varianten is de parameter
--max-num-batched-tokensniet opgegeven; vLLM gebruikt de standaardwaarde. Bij de NVFP4-MTP-variant zijn de generatieparameters aangepast met--override-generation-config.
2. Prestaties van de kwantisatievarianten
2.1 Qwen3.6-27B-FP8
FP8-kwantisatie slaat de modelgewichten op in een floating-point-formaat met 8 bits. Deze variant gebruikt geen MTP.
Prestatietabel:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
| 1 | 270.57 | 121.87 | 8.13 | 15.75 | 0.06 |
| 2 | 357.77 | 121.13 | 8.13 | 15.74 | 0.06 |
| 4 | 447.17 | 124.23 | 7.89 | 16.23 | 0.06 |
| 8 | 511.45 | 129.14 | 7.57 | 16.91 | 0.06 |
| 16 | 866.95 | 142.24 | 6.76 | 18.93 | 0.05 |
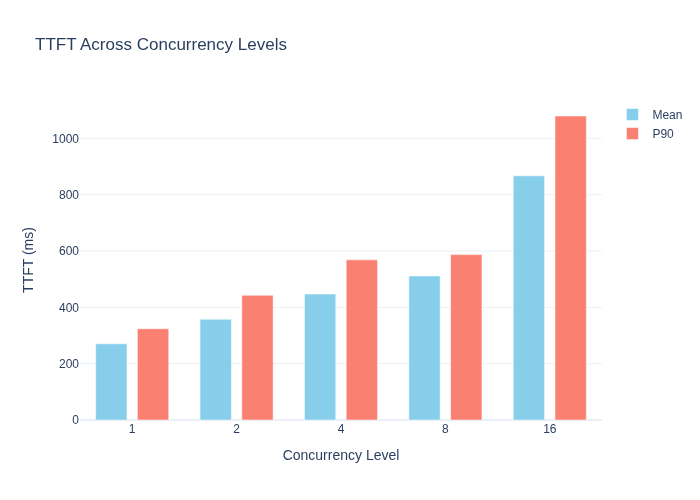
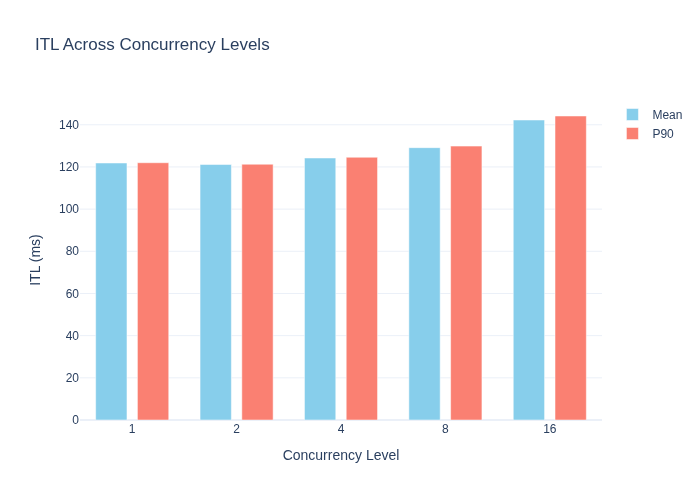
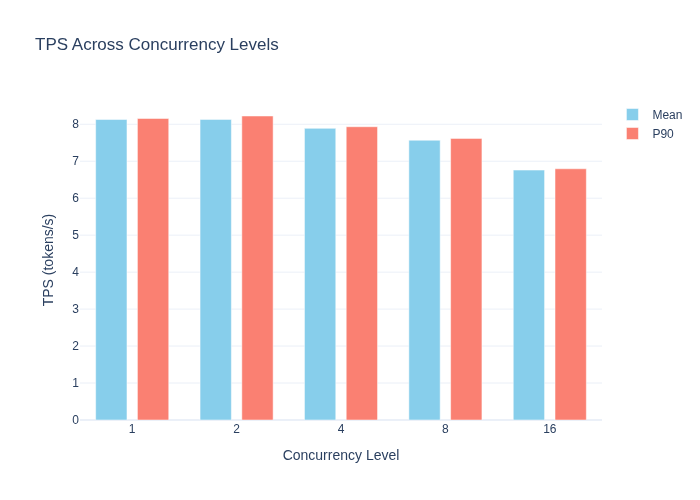
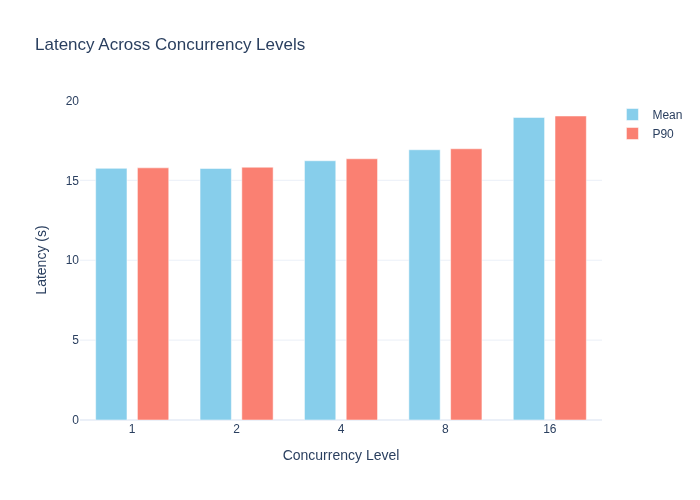
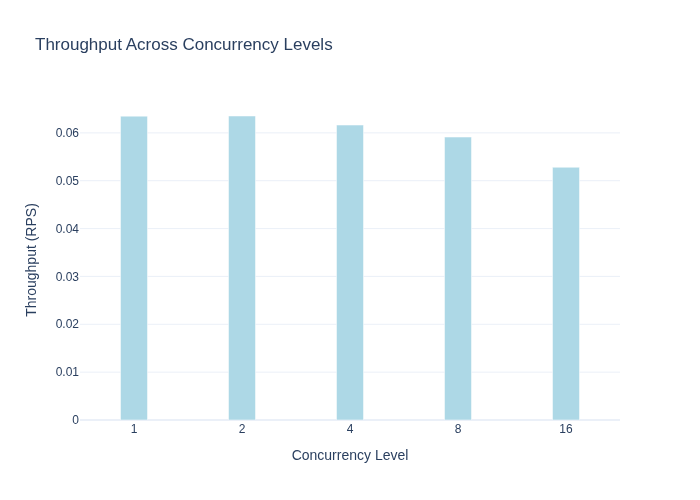
Beoordeling:
Omdat de FP8-variant geen MTP gebruikt, is de tokengeneratiesnelheid beperkt. Dat de ITL rond ~122ms blijft, betekent dat er slechts ~8 tokens per seconde kunnen worden gegenereerd. Naarmate de gelijktijdigheid toeneemt, stijgt de ITL licht (122ms → 142ms), maar de daling van de TPS (17%) en de toename van de latentie (20%) blijven relatief beperkt. Dit toont aan dat FP8 de GPU niet volledig kan verzadigen en dat er ongebruikte capaciteit is.
De TTFT daarentegen neemt duidelijk toe met de gelijktijdigheid (271ms → 867ms, +221%). Dit laat zien dat de prefill-fase de rekenresources van de GPU intensief gebruikt en dat er bij gelijktijdige verzoeken wachtrijvorming optreedt.
Waarom gedragen ITL en TTFT zich verschillend? Dat de GPU in de twee fasen met twee verschillende knelpunten te maken heeft, verklaart dit: de decode-fase is geheugengebonden (memory-bound) — per stap wordt slechts 1 token gegenereerd en de dominante bewerking is het laden van gewichten uit het GPU-geheugen; de rekeneenheden hebben ongebruikte capaciteit. De prefill-fase is rekengebonden (compute-bound) — alle invoertokens worden in één keer verwerkt, wat intensieve matrixvermenigvuldigingen vereist, en de SM-eenheden van de GPU werken op volle capaciteit. Daarom wordt decode bij toenemende gelijktijdigheid slechts licht beïnvloed, terwijl bij prefill ernstige wachtrijvorming optreedt (zie paragraaf 6.3 voor een gedetailleerde analyse).
2.2 Qwen3.6-27B-FP8-MTP
Combinatie van FP8-kwantisatie + MTP. Dankzij MTP worden per decode-stap meerdere tokens gegenereerd.
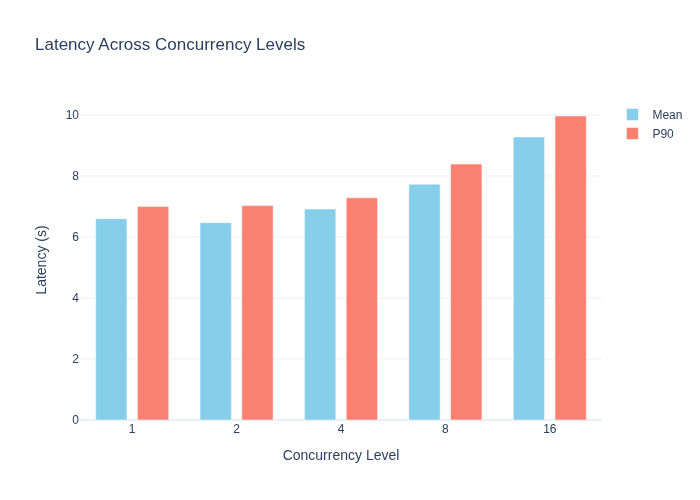
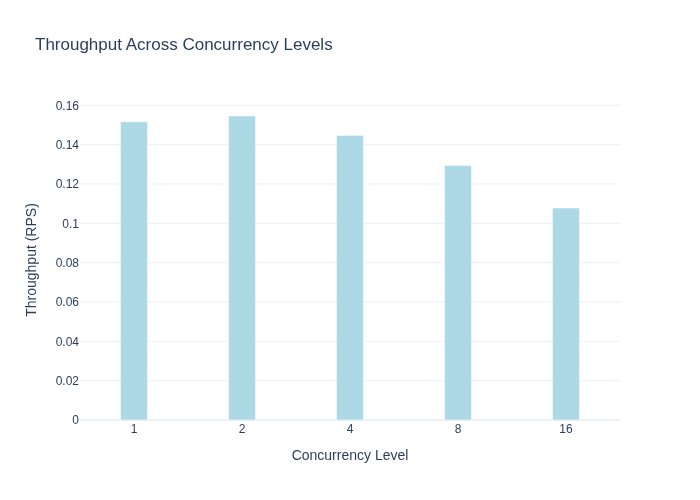
Prestatietabel:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
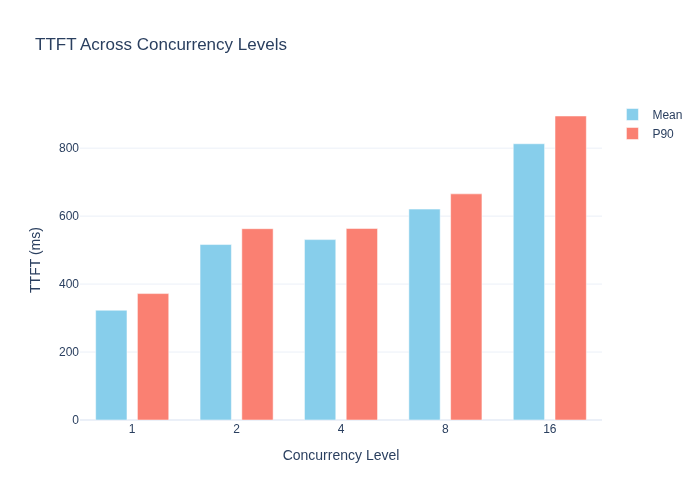
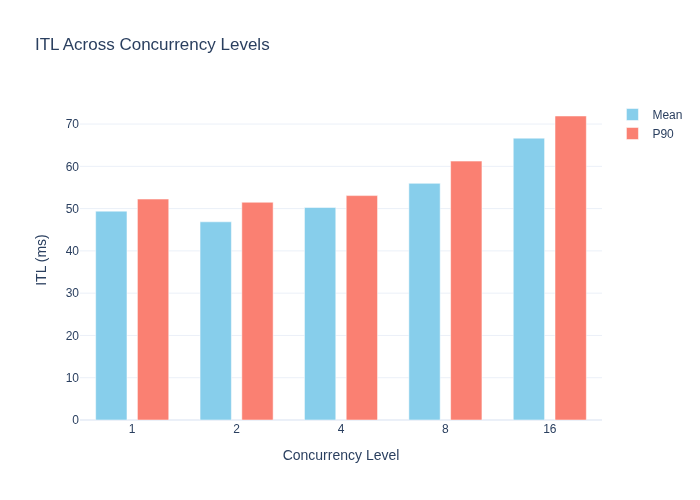
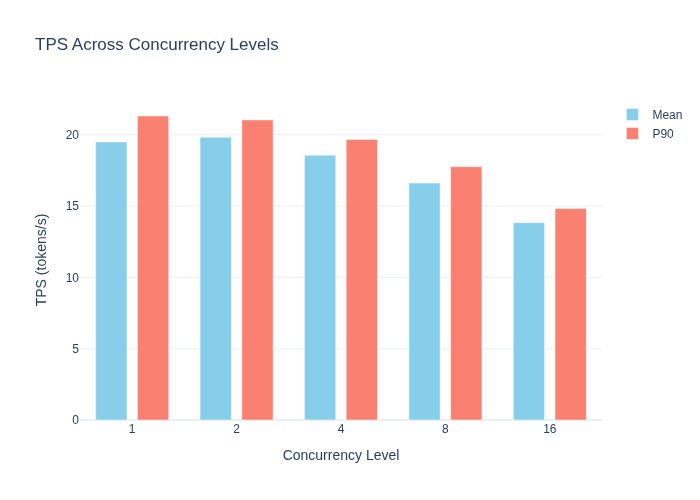
| 1 | 322.95 | 49.40 | 19.50 | 6.60 | 0.15 |
| 2 | 516.27 | 46.87 | 19.83 | 6.47 | 0.15 |
| 4 | 530.80 | 50.26 | 18.56 | 6.92 | 0.14 |
| 8 | 620.59 | 55.97 | 16.62 | 7.73 | 0.13 |
| 16 | 812.93 | 66.66 | 13.84 | 9.28 | 0.11 |
Beoordeling:
Het effect van MTP is opvallend: de ITL daalde van 122ms naar 49ms (~60% lager) en de TPS steeg van 8.13 naar 19.50 (~140% hoger). De totale latentie daalde van 15.75s naar 6.60s (~58% lager). Dit bevestigt dat MTP de decode-fase drastisch versnelt.
De gevoeligheid voor een toename van de gelijktijdigheid is echter groter: de TPS daalt 29% (tegenover 17% bij FP8 zonder MTP), de latentie neemt 40% toe (tegenover 20% bij FP8 zonder MTP). Het lijkt erop dat een snel model de GPU effectiever gebruikt en dat de concurrentie om resources onder extra belasting sterker wordt.
De TTFT heeft een hogere beginwaarde dan de FP8-variant zonder MTP (323ms tegenover 271ms). Dit wijst erop dat MTP extra rekenbelasting in de prefill-fase kan meebrengen. De duidelijke toename van de TTFT met de gelijktijdigheid komt voort uit het rekengebonden karakter van de prefill-fase (zie de uitleg over het prefill/decode-knelpunt in paragraaf 2.1).
2.3 Qwen3.6-27B-AWQ-MTP
Combinatie van AWQ-kwantisatie + MTP. AWQ comprimeert de gewichten naar 4-bit en bespaart geheugenbandbreedte.
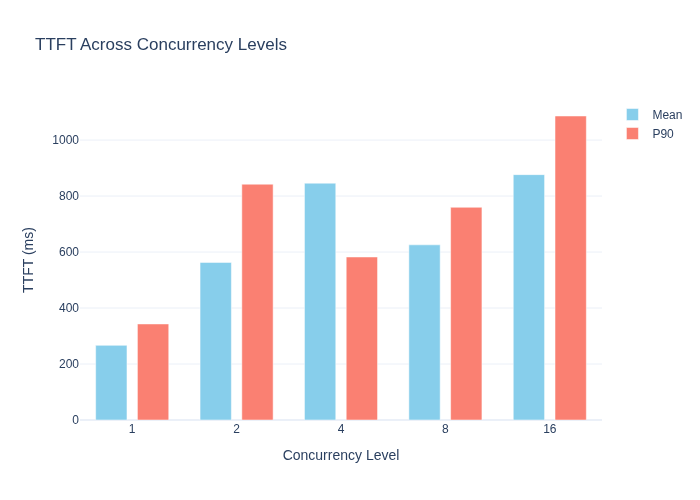
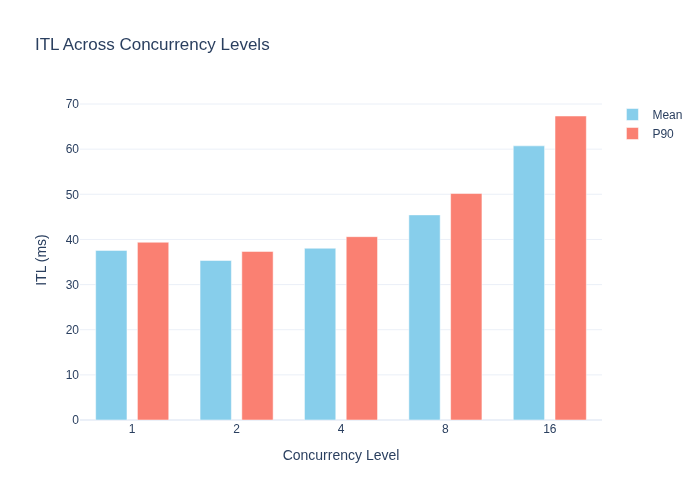
Prestatietabel:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
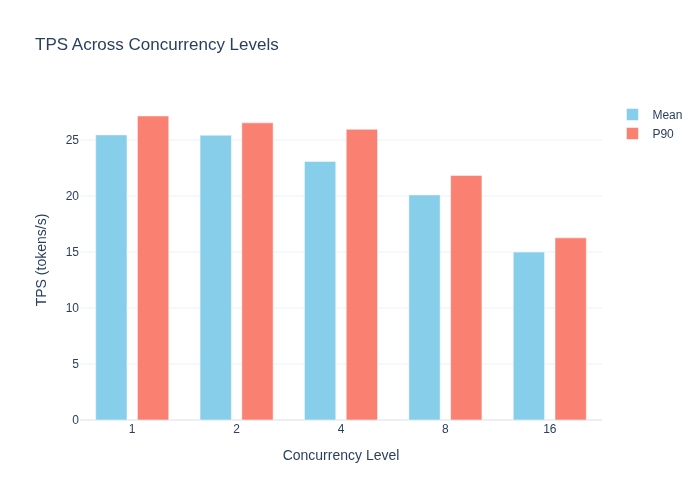
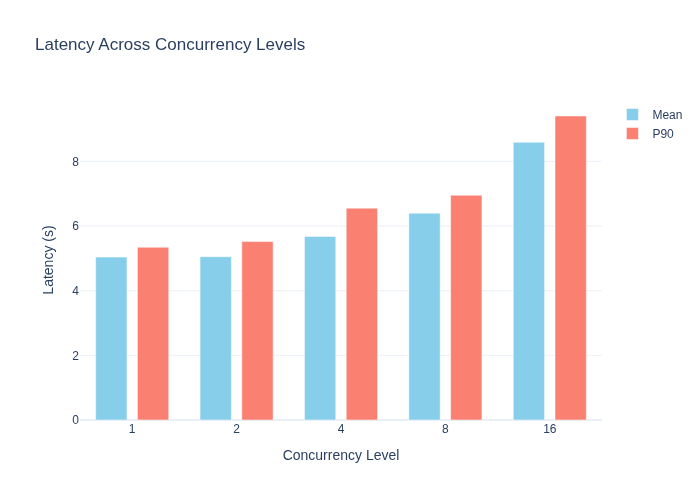
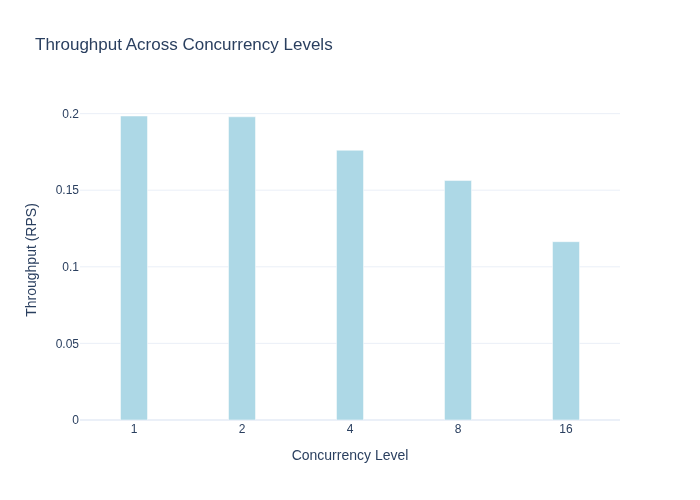
| 1 | 266.65 | 37.57 | 25.45 | 5.04 | 0.20 |
| 2 | 562.95 | 35.34 | 25.42 | 5.05 | 0.20 |
| 4 | 845.97 | 38.05 | 23.08 | 5.68 | 0.18 |
| 8 | 625.74 | 45.44 | 20.09 | 6.40 | 0.16 |
| 16 | 876.55 | 60.73 | 14.99 | 8.59 | 0.12 |
Beoordeling:
AWQ-MTP levert de hoogste prestaties van alle varianten. Bij Concurrency=1 is het de duidelijke koploper met een TPS van 25.45 tok/s, een ITL van 37.57ms en een latentie van 5.04s. Wanneer de geheugenbandbreedtebesparing van AWQ wordt gecombineerd met de generatie van meerdere tokens door MTP, wordt de decode-fase drastisch versneld.
Deze variant is echter het gevoeligst voor een toename van de gelijktijdigheid: de TPS daalt 41% (25.45 → 14.99), de ITL neemt 62% toe (37.57ms → 60.73ms), de latentie neemt 70% toe (5.04s → 8.59s). Dit wijst erop dat de GPU al bij lage belasting sterk wordt benut en dat extra belasting tot concurrentie om resources leidt.
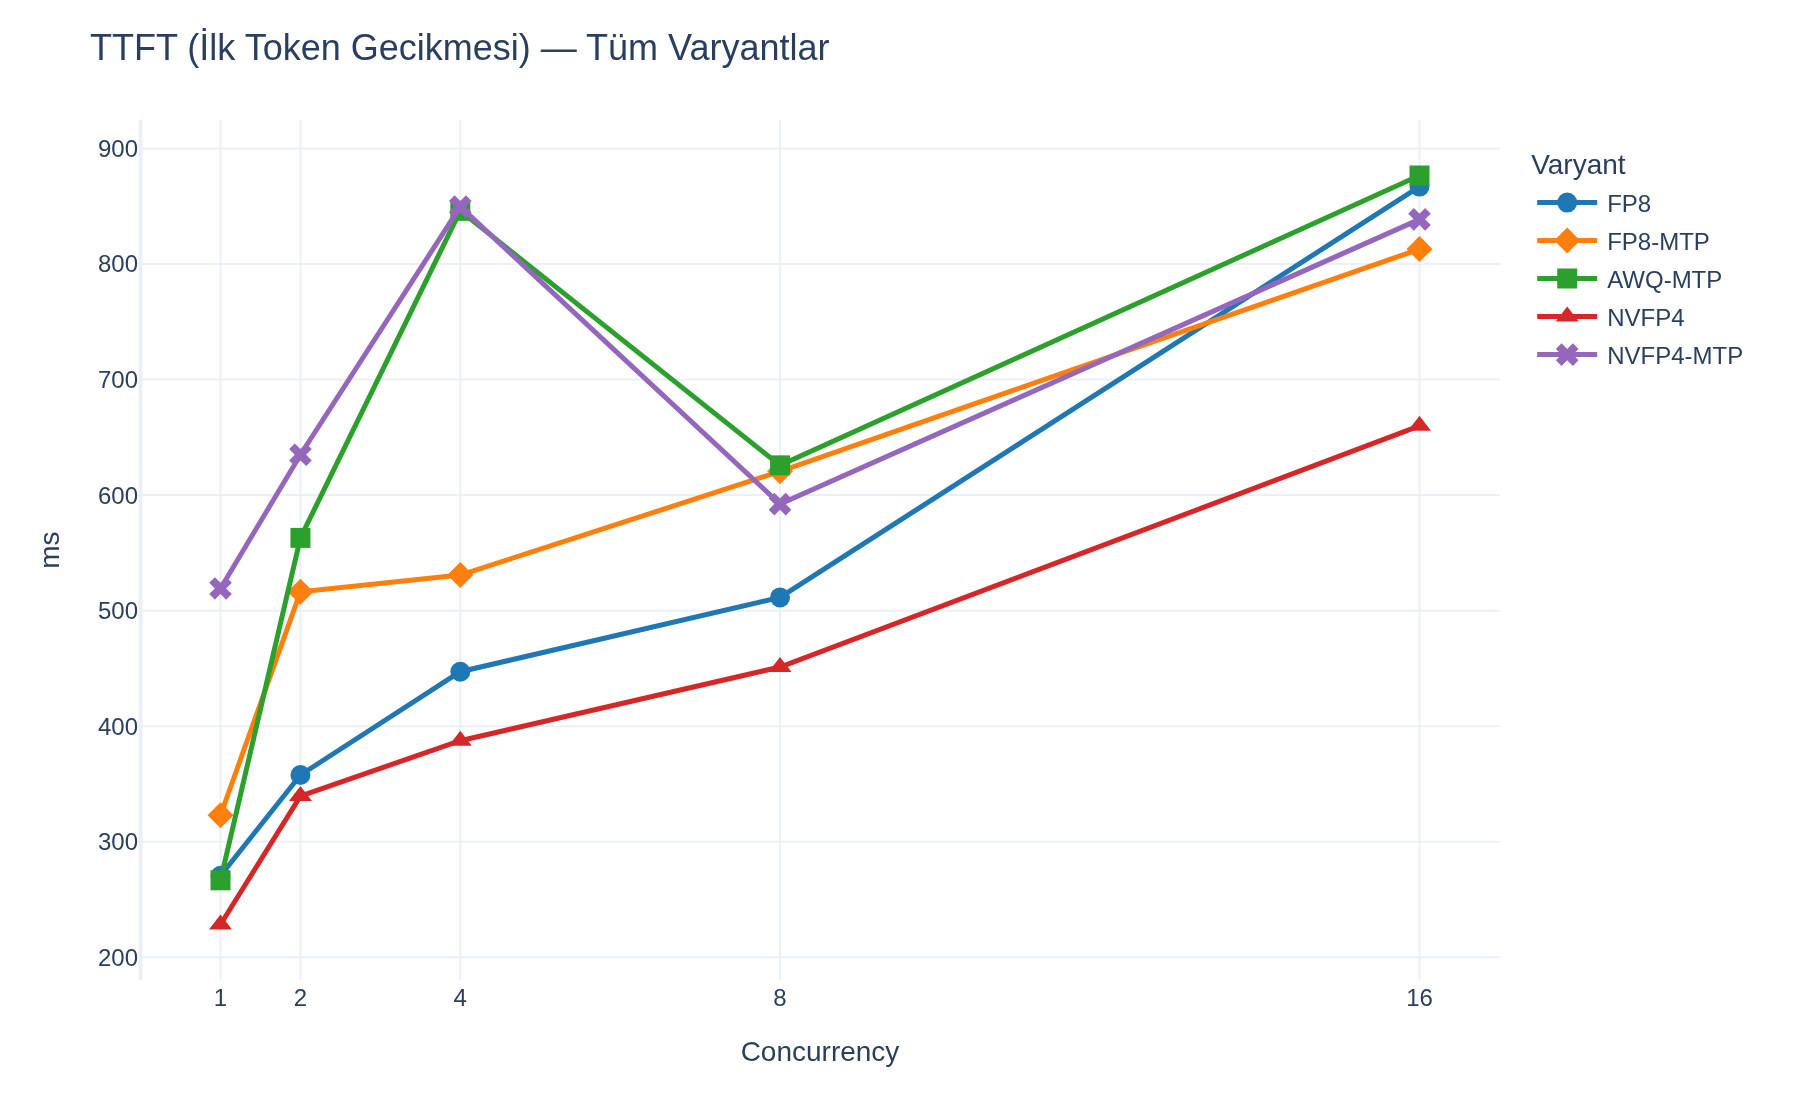
De TTFT-waarden volgen een onregelmatig verloop (267ms, 563ms, 846ms, 626ms, 877ms). De stijging naar 846ms bij Concurrency=4 en de daling naar 626ms bij C=8 wijzen erop dat de waarde wordt beïnvloed door systeemomstandigheden of schommelingen in de scheduling tijdens de test. Over het geheel genomen komt de toename van de TTFT met de gelijktijdigheid voort uit het rekengebonden karakter van de prefill-fase (zie de uitleg over het prefill/decode-knelpunt in paragraaf 2.1).
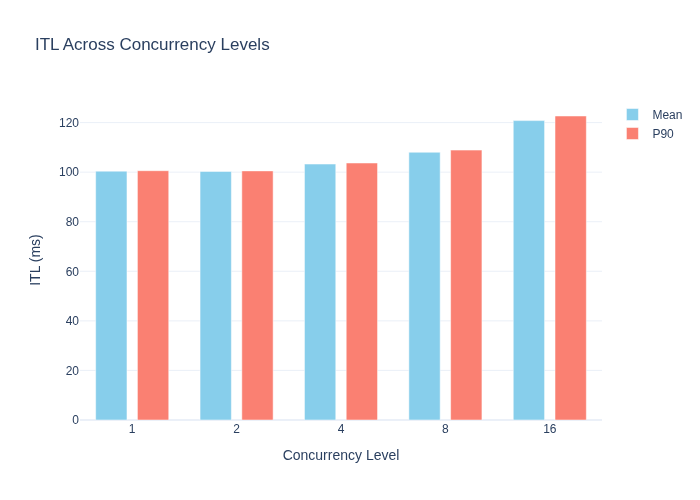
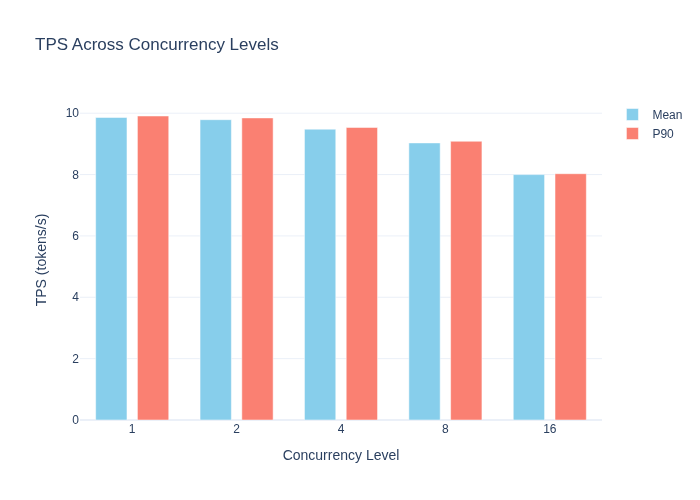
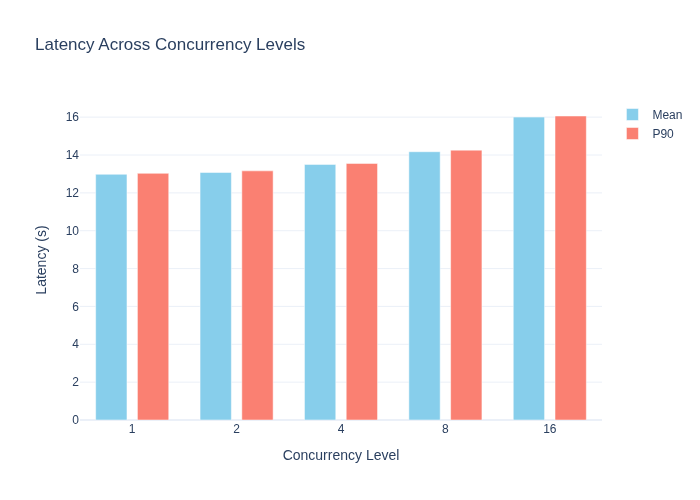
2.4 Qwen3.6-27B-NVFP4
Het eigen 4-bitformaat van NVIDIA. Wordt geleverd met ondersteuning voor versnelling op hardwareniveau; MTP is niet gebruikt.
Prestatietabel:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
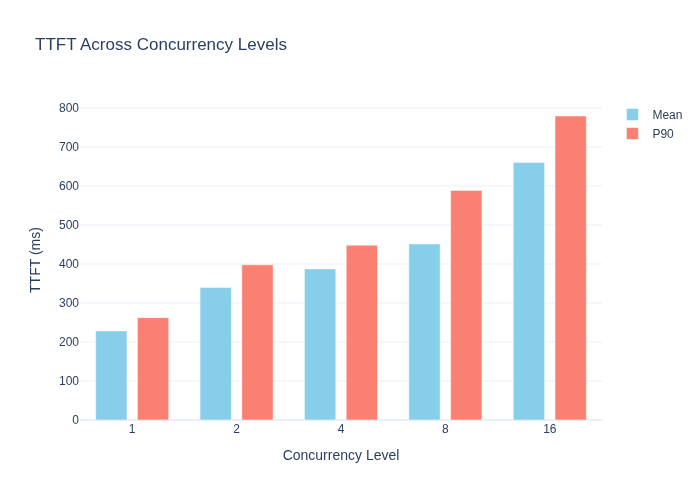
| 1 | 228.42 | 100.40 | 9.86 | 12.98 | 0.08 |
| 2 | 339.55 | 100.29 | 9.79 | 13.08 | 0.08 |
| 4 | 387.42 | 103.28 | 9.48 | 13.50 | 0.07 |
| 8 | 451.22 | 108.04 | 9.03 | 14.17 | 0.07 |
| 16 | 659.95 | 120.80 | 8.00 | 16.00 | 0.06 |
Beoordeling:
NVFP4 presteert consequent beter dan de FP8-variant. ITL ~100ms (tegenover ~122ms bij FP8), TPS ~9.86 tok/s (tegenover ~8.13 bij FP8), latentie ~13s (tegenover ~15.75s bij FP8). Het geheugenbandbreedtevoordeel van 4-bitcompressie overtreft, in combinatie met hardwareversnelling, FP8.
De TTFT-waarden van NVFP4 zijn de laagste van alle varianten (228ms @ C=1). Dit toont aan dat NVFP4 in de prefill-fase profiteert van hardwareversnelling.
De gevoeligheid voor gelijktijdigheid is vergelijkbaar met die van FP8: de TPS daalt 19%, de ITL neemt 20% toe, de latentie neemt 23% toe. Omdat beide modellen zonder MTP de GPU niet volledig kunnen verzadigen, heeft de toename van de gelijktijdigheid een relatief mild effect — het verschil in knelpunt, met een geringe invloed op de ITL (decode geheugengebonden) en een grote invloed op de TTFT (prefill rekengebonden), geldt ook hier (zie de uitleg in paragraaf 2.1).
2.5 Qwen3.6-27B-NVFP4-MTP
Combinatie van NVFP4-kwantisatie + MTP. 4-bitcompressie en multi-token prediction worden samen gebruikt.
Prestatietabel:
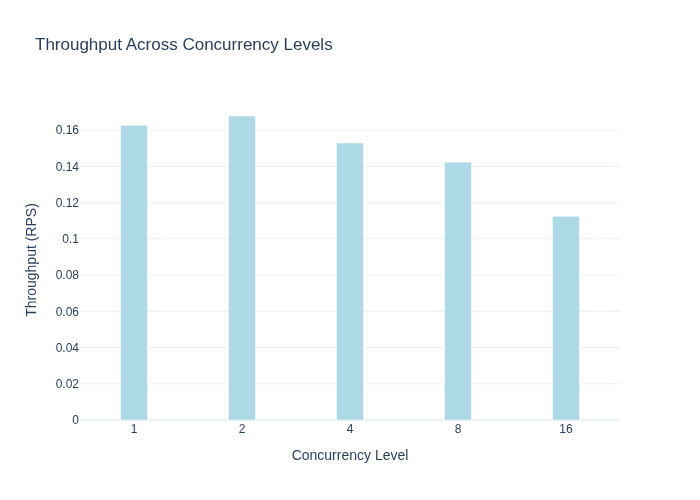
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
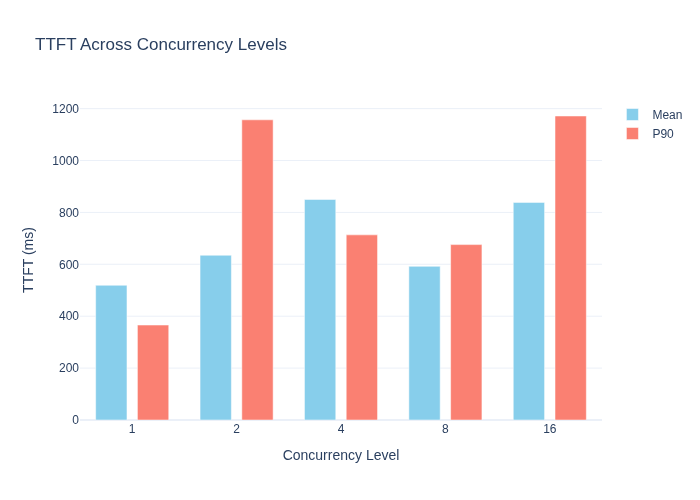
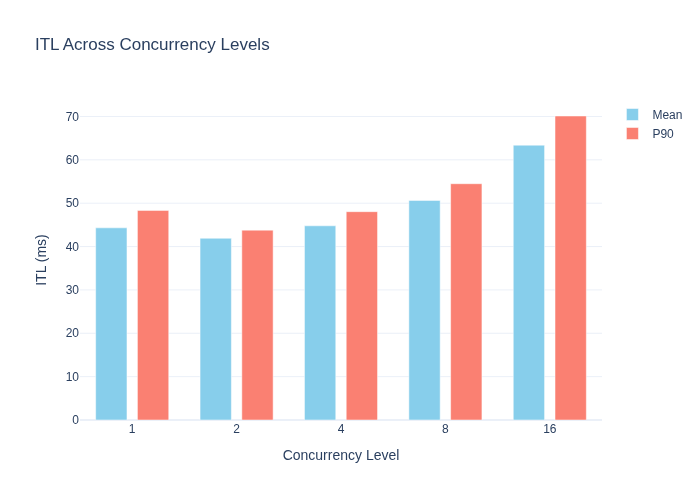
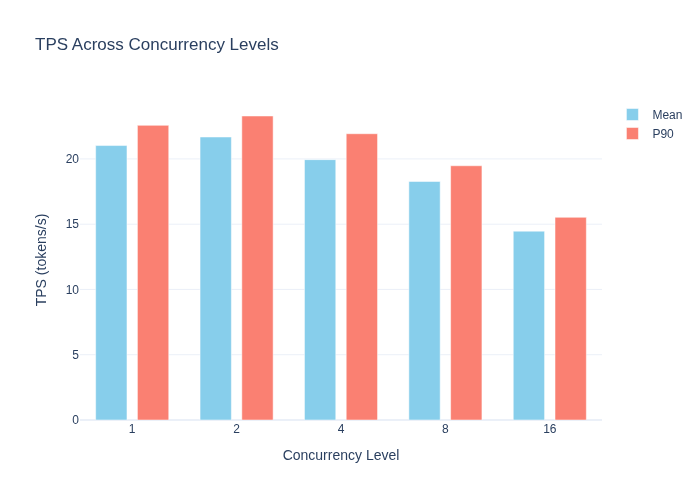
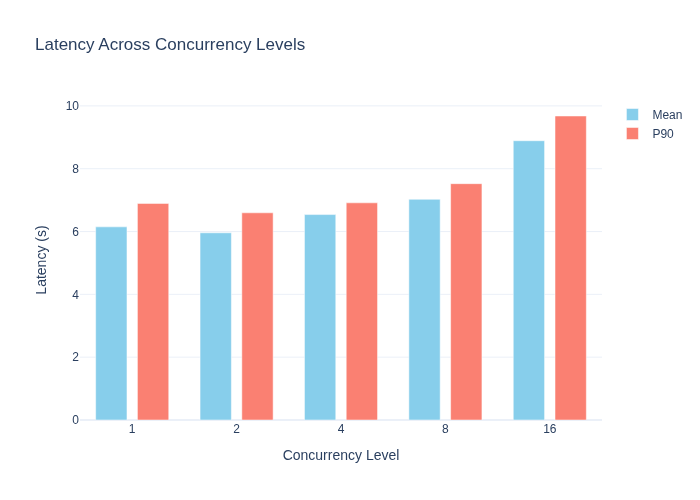
| 1 | 519.21 | 44.32 | 21.02 | 6.15 | 0.16 |
| 2 | 634.90 | 41.92 | 21.68 | 5.96 | 0.17 |
| 4 | 849.66 | 44.79 | 19.94 | 6.54 | 0.15 |
| 8 | 592.18 | 50.64 | 18.27 | 7.03 | 0.14 |
| 16 | 838.59 | 63.38 | 14.47 | 8.89 | 0.11 |
Beoordeling:
NVFP4-MTP levert prestaties die dicht bij die van FP8-MTP liggen. Bij Concurrency=1 is de TPS 21.02 tok/s (FP8-MTP: 19.50), de ITL 44.32ms (FP8-MTP: 49.40ms) en de latentie 6.15s (FP8-MTP: 6.60s). Wanneer het geheugenbandbreedtevoordeel van NVFP4 wordt gecombineerd met MTP, levert dat een kleine extra snelheidswinst op.
Wat de TTFT betreft, heeft NVFP4-MTP bij Concurrency=1 met 519ms de hoogste waarde van alle varianten. Dit duidelijke verschil wijst erop dat de NVFP4+MTP-configuratie een extra rekenbelasting in de prefill-fase veroorzaakt. Bij deze variant wacht de gebruiker het langst op het eerste token. Door hardwarebeperkingen van SM121 veroorzaakt de combinatie MTP+NVFP4 extra belasting in de prefill (zie paragraaf 6.4.3 voor details).
De gevoeligheid voor gelijktijdigheid is vergelijkbaar met die van FP8-MTP: de TPS daalt 31%, de ITL neemt 43% toe, de latentie neemt 45% toe. De duidelijke toename van de ITL met de gelijktijdigheid komt doordat de concurrentie om geheugenbandbreedte toeneemt naarmate de GPU in de decode-fase verzadiging nadert; de toename van de TTFT komt voort uit het rekengebonden karakter van prefill (zie de uitleg in paragraaf 2.1). De lichte stijging van de TPS bij Concurrency=2 (21.02 → 21.68) en de daling van de latentie (6.15s → 5.96s) zijn opmerkelijk; dit kan wijzen op een mogelijk batching-effect bij C=2. Het verschil (~3% TPS) valt echter binnen de ruismarges van een kleine steekproef; voor een definitieve bewering over een “sweet spot” zijn meer metingen nodig (zie paragraaf 1.7, Beperking).
3. Vergelijking van de kwantisatieformaten
TTFT-vergelijking (alle varianten):
3.1 Zonder MTP: FP8 vs NVFP4
Vergelijking van de twee varianten zonder MTP over de gelijktijdigheidsniveaus:
Vergelijking van de TPS (tokens/s):
| Gelijktijdigheid | FP8 | NVFP4 | Verschil |
|---|---|---|---|
| 1 | 8.13 | 9.86 | +21.3% |
| 2 | 8.13 | 9.79 | +20.4% |
| 4 | 7.89 | 9.48 | +20.2% |
| 8 | 7.57 | 9.03 | +19.3% |
| 16 | 6.76 | 8.00 | +18.3% |
Vergelijking van de ITL (ms):
| Gelijktijdigheid | FP8 | NVFP4 | Verschil |
|---|---|---|---|
| 1 | 121.87 | 100.40 | -17.6% |
| 2 | 121.13 | 100.29 | -17.2% |
| 4 | 124.23 | 103.28 | -16.9% |
| 8 | 129.14 | 108.04 | -16.3% |
| 16 | 142.24 | 120.80 | -15.1% |
Vergelijking van de latentie (s):
| Gelijktijdigheid | FP8 | NVFP4 | Verschil |
|---|---|---|---|
| 1 | 15.75 | 12.98 | -17.6% |
| 2 | 15.74 | 13.08 | -16.9% |
| 4 | 16.23 | 13.50 | -16.8% |
| 8 | 16.91 | 14.17 | -16.2% |
| 16 | 18.93 | 16.00 | -15.5% |
Beoordeling:
NVFP4 is op alle metrieken consequent beter dan FP8. De belangrijkste reden voor dit voordeel is dat de 4-bitcompressie van NVFP4 de benodigde geheugenbandbreedte halveert. De decode-fase van een LLM is een geheugengebonden workload; NVFP4 verplaatst minder data en kan de rekeneenheden van de GPU daardoor efficiënter voeden.
De voorsprong wordt iets kleiner naarmate de gelijktijdigheid toeneemt (van 21.3% naar 18.3% in TPS). Dit wijst erop dat het geheugenbandbreedtevoordeel afneemt naarmate onder hoge belasting de grens van de rekenresources van de GPU in zicht komt.
3.2 Met MTP: FP8-MTP vs AWQ-MTP vs NVFP4-MTP
Vergelijking van de drie varianten met MTP:
Vergelijking bij Concurrency=1:
| Metriek | FP8-MTP | AWQ-MTP | NVFP4-MTP |
|---|---|---|---|
| TPS (tok/s) | 19.50 | 25.45 | 21.02 |
| ITL (ms) | 49.40 | 37.57 | 44.32 |
| Latentie (s) | 6.60 | 5.04 | 6.15 |
| TTFT (ms) | 322.95 | 266.65 | 519.21 |
| Doorvoer (RPS) | 0.15 | 0.20 | 0.16 |
Vergelijking bij Concurrency=16:
| Metriek | FP8-MTP | AWQ-MTP | NVFP4-MTP |
|---|---|---|---|
| TPS (tok/s) | 13.84 | 14.99 | 14.47 |
| ITL (ms) | 66.66 | 60.73 | 63.38 |
| Latentie (s) | 9.28 | 8.59 | 8.89 |
| TTFT (ms) | 812.93 | 876.55 | 838.59 |
| Doorvoer (RPS) | 0.11 | 0.12 | 0.11 |
Beoordeling:
AWQ-MTP is bij lage gelijktijdigheid de duidelijke koploper. In TPS is het 30% sneller dan FP8-MTP en 21% sneller dan NVFP4-MTP. Bij hoge gelijktijdigheid (C=16) wordt het verschil echter aanzienlijk kleiner: de TPS-voorsprong van AWQ-MTP daalt tot 8% ten opzichte van FP8-MTP en 3% ten opzichte van NVFP4-MTP.
Dit toont aan dat het geheugenbandbreedtevoordeel van AWQ het effectiefst is bij lage belasting en dat de rekenresources het knelpunt worden naarmate de belasting toeneemt. Bij hoge gelijktijdigheid gaan alle varianten vergelijkbare prestaties vertonen.
Hoewel NVFP4-MTP prestaties levert die dicht bij die van FP8-MTP liggen, heeft het de slechtste TTFT-waarden. Met dit nadeel moet rekening worden gehouden in scenario’s waarin de latentie tot het eerste token cruciaal is (bijv. chatbots).
4. Diepgaande analyse van het MTP-effect
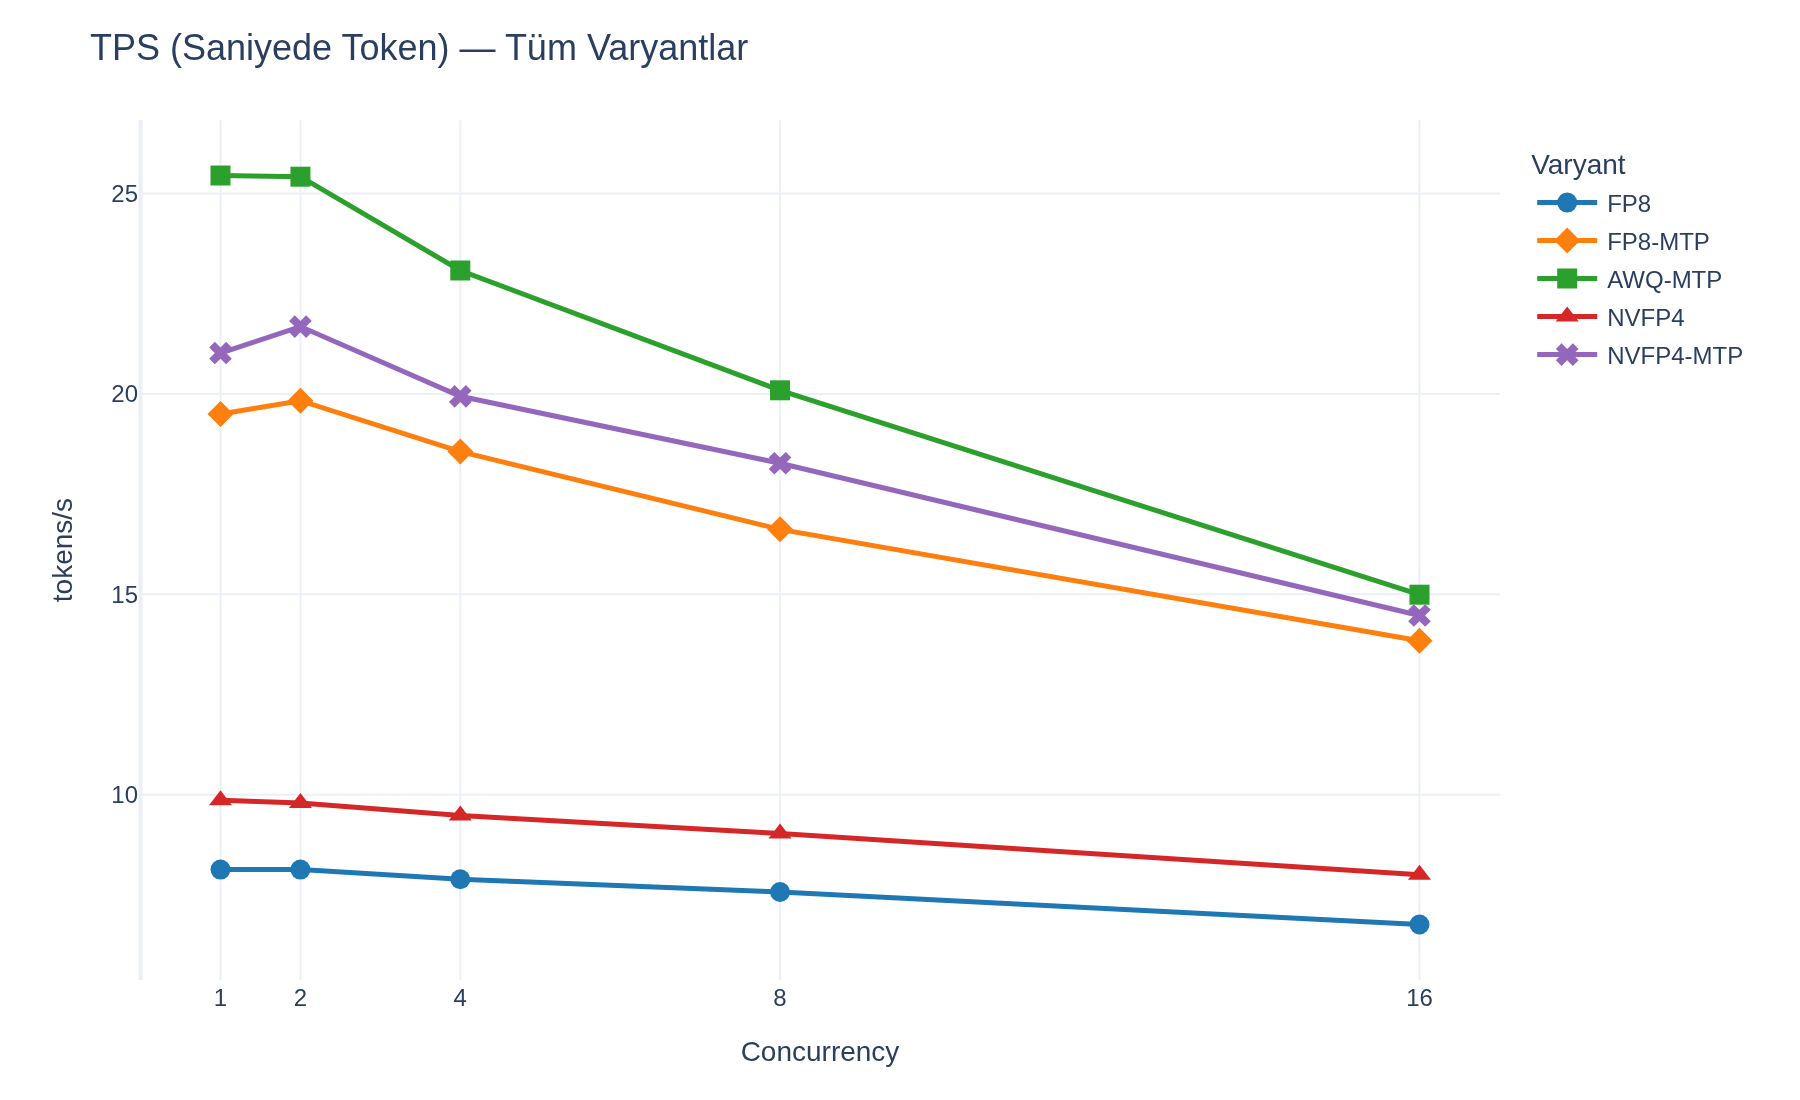
TPS-vergelijking (alle varianten):
4.1 Effect van de overstap FP8 → FP8-MTP
| Metriek | FP8 (C=1) | FP8-MTP (C=1) | Verandering |
|---|---|---|---|
| TPS | 8.13 tok/s | 19.50 tok/s | +139.7% |
| ITL | 121.87 ms | 49.40 ms | -59.5% |
| Latentie | 15.75 s | 6.60 s | -58.1% |
| TTFT | 270.57 ms | 322.95 ms | +19.4% |
| Doorvoer | 0.06 RPS | 0.15 RPS | +150.0% |
Het effect van MTP op FP8 is op alle gelijktijdigheidsniveaus consistent:
| Gelijktijdigheid | TPS-toename | ITL-afname | Latentie-afname |
|---|---|---|---|
| 1 | +139.7% | -59.5% | -58.1% |
| 2 | +143.5% | -61.3% | -58.8% |
| 4 | +135.2% | -59.6% | -57.4% |
| 8 | +119.4% | -56.6% | -54.3% |
| 16 | +104.7% | -53.1% | -51.0% |
Belangrijkste bevinding: De snelheidswinst van MTP neemt af naarmate de gelijktijdigheid toeneemt. De TPS-toename daalt van 140% naar 105%. Dit wijst erop dat de extra rekenbelasting van MTP onder hoge belasting tot concurrentie om resources leidt.
4.2 Effect van de overstap NVFP4 → NVFP4-MTP
| Metriek | NVFP4 (C=1) | NVFP4-MTP (C=1) | Verandering |
|---|---|---|---|
| TPS | 9.86 tok/s | 21.02 tok/s | +113.2% |
| ITL | 100.40 ms | 44.32 ms | -55.9% |
| Latentie | 12.98 s | 6.15 s | -52.6% |
| TTFT | 228.42 ms | 519.21 ms | +127.3% |
| Doorvoer | 0.08 RPS | 0.16 RPS | +100.0% |
| Gelijktijdigheid | TPS-toename | ITL-afname | Latentie-afname |
|---|---|---|---|
| 1 | +113.2% | -55.9% | -52.6% |
| 2 | +121.3% | -58.2% | -54.4% |
| 4 | +110.3% | -56.7% | -51.6% |
| 8 | +102.3% | -53.1% | -50.4% |
| 16 | +80.9% | -47.5% | -44.4% |
Belangrijkste bevinding: Het negatieve effect van MTP op de TTFT bij NVFP4 is opvallend. De TTFT steeg van 228ms naar 519ms (127% hoger). Dit wijst erop dat de NVFP4+MTP-configuratie een aanzienlijke extra belasting in de prefill-fase veroorzaakt. De gebruiker zal een aanzienlijke vertraging ervaren bij het wachten op het eerste token.
Daarnaast is de snelheidswinst van MTP bij NVFP4 op alle gelijktijdigheidsniveaus lager dan bij FP8 (TPS-toename 113% tegenover 140%). Dit suggereert dat de hardwareversnelling van NVFP4 mogelijk niet volledig compatibel is met MTP.
4.3 MTP-versnellingsfactor vs gelijktijdigheid
De TPS-verhouding met MTP / zonder MTP laat zien hoe het voordeel van MTP onder belasting verandert:
| Gelijktijdigheid | FP8 MTP-verhouding | NVFP4 MTP-verhouding |
|---|---|---|
| 1 | 2.40x | 2.13x |
| 2 | 2.44x | 2.21x |
| 4 | 2.35x | 2.10x |
| 8 | 2.19x | 2.02x |
| 16 | 2.05x | 1.81x |
Beoordeling:
In beide kwantisatieformaten neemt de MTP-versnellingsfactor af naarmate de gelijktijdigheid toeneemt. Bij FP8 daalt die van 2.40x naar 2.05x, bij NVFP4 van 2.13x naar 1.81x. Dit bewijst dat MTP het grootste voordeel biedt bij lage belasting en dat het rendement onder hoge belasting afneemt.
De MTP-verhouding is bij NVFP4 op alle niveaus lager dan bij FP8. Dat komt doordat de hardwareversnelling van NVFP4 zonder MTP al efficiënter is, zodat de marginale bijdrage van MTP kleiner is.
5. Analyse van het effect van gelijktijdigheid
5.1 Daling van de TPS (tokengeneratiesnelheid)
Naarmate de gelijktijdigheid toeneemt, daalt de TPS bij alle varianten:
| Variant | C=1 | C=2 | C=4 | C=8 | C=16 | Totale daling |
|---|---|---|---|---|---|---|
| FP8 | 8.13 | 8.13 | 7.89 | 7.57 | 6.76 | -17% |
| FP8-MTP | 19.50 | 19.83 | 18.56 | 16.62 | 13.84 | -29% |
| AWQ-MTP | 25.45 | 25.42 | 23.08 | 20.09 | 14.99 | -41% |
| NVFP4 | 9.86 | 9.79 | 9.48 | 9.03 | 8.00 | -19% |
| NVFP4-MTP | 21.02 | 21.68 | 19.94 | 18.27 | 14.47 | -31% |
Analyse:
- Modellen zonder MTP (FP8, NVFP4) vertonen een lage daling (17-19%). Omdat deze modellen de GPU niet op volle capaciteit kunnen benutten, kan de toegenomen gelijktijdigheid de GPU verder belasten zonder dat de individuele TPS veel wordt beïnvloed.
- Modellen met MTP (FP8-MTP, AWQ-MTP, NVFP4-MTP) vertonen een grotere daling (29-41%). Vooral AWQ-MTP heeft met een daling van 41% het hoogste percentage. Dit bevestigt dat snelle modellen de GPU beter verzadigen en dat extra belasting tot concurrentie om resources leidt.
- De daling is bij FP8-MTP en NVFP4-MTP vergelijkbaar (29% tegenover 31%), wat erop wijst dat de GPU in beide formaten in vergelijkbare mate verzadigd raakt.
5.2 Toename van de ITL (inter-token-latentie)
| Variant | C=1 | C=16 | Toename |
|---|---|---|---|
| FP8 | 121.87 ms | 142.24 ms | +17% |
| FP8-MTP | 49.40 ms | 66.66 ms | +35% |
| AWQ-MTP | 37.57 ms | 60.73 ms | +62% |
| NVFP4 | 100.40 ms | 120.80 ms | +20% |
| NVFP4-MTP | 44.32 ms | 63.38 ms | +43% |
Analyse:
De toename van de ITL is een directe indicator van concurrentie om geheugenbandbreedte. Bij modellen met MTP is de toename van de ITL duidelijk groter:
- 62% toename bij AWQ-MTP: het laden van 4-bitgewichten vraagt veel bandbreedte; met MTP vermenigvuldigt deze vraag zich doordat meerdere tokens worden gegenereerd.
- Slechts 17% toename bij FP8: de geheugenbandbreedte van de GPU heeft nog capaciteit over.
5.3 Toename van de TTFT (latentie tot het eerste token)
De TTFT is de metriek die het sterkst wordt beïnvloed door de toename van de gelijktijdigheid:
| Variant | C=1 | C=16 | Toename |
|---|---|---|---|
| FP8 | 270.57 ms | 866.95 ms | +220% |
| FP8-MTP | 322.95 ms | 812.93 ms | +152% |
| AWQ-MTP | 266.65 ms | 876.55 ms | +229% |
| NVFP4 | 228.42 ms | 659.95 ms | +189% |
| NVFP4-MTP | 519.21 ms | 838.59 ms | +61% |
Analyse:
- De 2-3x toename van de TTFT toont aan dat de prefill-fase de rekenresources van de GPU intensief gebruikt en dat er bij gelijktijdige verzoeken ernstige wachtrijvorming optreedt.
- De toename van slechts 61% bij NVFP4-MTP is opmerkelijk. Deze variant heeft echter al de hoogste begin-TTFT (519ms); in absolute termen is die bij C=16 839ms, dicht bij de andere varianten. (De 61% hier is het effect van de gelijktijdigheid C=1→C=16; de 127% in paragraaf 4.2 is het effect van het toevoegen van MTP bij een vaste C=1 — de twee percentages horen bij verschillende vergelijkingen.)
- De prefill-fase vereist intensieve matrixvermenigvuldigingen, waaronder het opbouwen van de KV-cache. Deze fase wordt eerder begrensd door rekenkracht dan door geheugenbandbreedte, en het delen van de rekeneenheden van de GPU veroorzaakt vertraging.
Praktische gevolgen: Vanuit het perspectief van de gebruiker kan de “tijd tot het antwoord begint binnen te komen” bij toenemende gelijktijdigheid tot 3x zo lang worden. Dit heeft een direct negatief effect op de gebruikerservaring in interactieve chatscenario’s.
5.4 Toename van de totale latentie
| Variant | C=1 | C=16 | Toename |
|---|---|---|---|
| FP8 | 15.75 s | 18.93 s | +20% |
| FP8-MTP | 6.60 s | 9.28 s | +40% |
| AWQ-MTP | 5.04 s | 8.59 s | +70% |
| NVFP4 | 12.98 s | 16.00 s | +23% |
| NVFP4-MTP | 6.15 s | 8.89 s | +45% |
Analyse:
De totale latentie is een combinatie van TTFT en decode-tijd. Ondanks de grote toename van de TTFT is de toename van de totale latentie kleiner, omdat de decode-tijd (ITL × aantal tokens) de dominante component is.
De toename van de totale latentie blijft bij modellen zonder MTP beperkt (20-23%). Bij modellen met MTP ligt die tussen 40-70%. AWQ-MTP heeft met een toename van 70% het hoogste percentage.
5.5 Curve van de totale doorvoer (RPS)
| Variant | C=1 | C=2 | C=4 | C=8 | C=16 |
|---|---|---|---|---|---|
| FP8 | 0.06 | 0.06 | 0.06 | 0.06 | 0.05 |
| FP8-MTP | 0.15 | 0.15 | 0.14 | 0.13 | 0.11 |
| AWQ-MTP | 0.20 | 0.20 | 0.18 | 0.16 | 0.12 |
| NVFP4 | 0.08 | 0.08 | 0.07 | 0.07 | 0.06 |
| NVFP4-MTP | 0.16 | 0.17 | 0.15 | 0.14 | 0.11 |
Analyse:
De bovenstaande waarde “Throughput (RPS)” is een metriek per verzoek (1 / average_latency; zie paragraaf 1.5). Die is per definitie onafhankelijk van de gelijktijdigheid; dat de waarde vlak lijkt, bewijst dus niet dat de GPU niet schaalt — de metriek kan structureel niet toenemen met de gelijktijdigheid.
De werkelijke totale capaciteit van het systeem wordt gemeten als Concurrency / average_latency (totale RPS) of TPS × Concurrency (totaal aantal gelijktijdig gegenereerde tokens/s). Hieronder staat de systeembrede RPS:
| Variant | C=1 | C=2 | C=4 | C=8 | C=16 |
|---|---|---|---|---|---|
| FP8 | 0.06 | 0.13 | 0.25 | 0.47 | 0.85 |
| FP8-MTP | 0.15 | 0.31 | 0.58 | 1.04 | 1.72 |
| AWQ-MTP | 0.20 | 0.40 | 0.70 | 1.25 | 1.86 |
| NVFP4 | 0.08 | 0.15 | 0.30 | 0.56 | 1.00 |
| NVFP4-MTP | 0.16 | 0.34 | 0.61 | 1.14 | 1.80 |
Zoals te zien is, neemt de systeembrede RPS duidelijk toe met de gelijktijdigheid (bijv. FP8-MTP: 0.15 bij C=1 → 1.72 bij C=16, ~11x; FP8: ~13x). Dit is consistent met de tabel TPS × Concurrency in paragraaf 6.1.
Juiste conclusie: Het verhogen van de gelijktijdigheid op één GPU verhoogt de totale werkcapaciteit aanzienlijk; in ruil daarvoor dalen de latentie en de TPS per individueel verzoek enigszins. Gelijktijdigheid is dus een afweging tussen latentie en totale doorvoer. Hoewel de schalingsefficiëntie onder belasting afneemt (83% voor FP8 bij C=16, 59% voor AWQ-MTP; zie paragraaf 6.1), blijft de totale capaciteit toenemen.
6. Analyse van schaalbaarheid en GPU-efficiëntie
6.1 Ideale lineaire schaling vs werkelijke prestaties
Als de GPU perfect zou kunnen schalen, zou gelijktijdigheid × TPS naar verwachting constant blijven. Dat wil zeggen: bij C=2 zou de TPS niet mogen halveren en bij C=4 niet mogen dalen tot een kwart.
TPS × Concurrency (totale tokengeneratiecapaciteit):
| Gelijktijdigheid | FP8 | FP8-MTP | AWQ-MTP | NVFP4 | NVFP4-MTP |
|---|---|---|---|---|---|
| 1 | 8.1 | 19.5 | 25.5 | 9.9 | 21.0 |
| 2 | 16.3 | 39.7 | 50.8 | 19.6 | 43.4 |
| 4 | 31.6 | 74.2 | 92.3 | 37.9 | 79.8 |
| 8 | 60.6 | 133.0 | 160.7 | 72.2 | 146.2 |
| 16 | 108.2 | 221.4 | 239.8 | 128.0 | 231.5 |
Opmerking: Deze tabel is de maat voor de werkelijke totale capaciteit van het systeem en groeit met de gelijktijdigheid (bijv. FP8: 8.1 → 108.2 tok/s, ~13x). Dit is niet in tegenspraak met de vlakke curve “Throughput (RPS)” in paragraaf 5.5; omdat de metriek daar per verzoek is (
1/latency), ligt die per definitie vast. Deze tabel is de juiste indicator voor de totale capaciteit.
Ideale schaling (TPS bij C=1 × gelijktijdigheid):
| Gelijktijdigheid | FP8 (ideaal) | FP8 (werkelijk) | Efficiëntie |
|---|---|---|---|
| 1 | 8.1 | 8.1 | 100% |
| 2 | 16.3 | 16.3 | 100% |
| 4 | 32.5 | 31.6 | 97.2% |
| 8 | 65.0 | 60.6 | 93.2% |
| 16 | 130.0 | 108.2 | 83.2% |
| Gelijktijdigheid | AWQ-MTP (ideaal) | AWQ-MTP (werkelijk) | Efficiëntie |
|---|---|---|---|
| 1 | 25.5 | 25.5 | 100% |
| 2 | 50.9 | 50.8 | 99.8% |
| 4 | 101.8 | 92.3 | 90.7% |
| 8 | 203.6 | 160.7 | 78.9% |
| 16 | 407.2 | 239.8 | 58.9% |
Beoordeling:
- FP8 schaalt relatief goed, zelfs bij concurrency=16 nog met een efficiëntie van 83.2%. Dat komt doordat de GPU door de lage individuele TPS nog niet op volle capaciteit werkt.
- AWQ-MTP zakt bij C=16 terug tot een efficiëntie van 58.9%. Omdat de GPU intensief wordt gebruikt, leidt extra belasting direct tot concurrentie om resources.
- Deze gegevens laten zien dat elke variant een eigen “optimaal gelijktijdigheidspunt” heeft.
6.2 Verzadigingskaart van de GPU
Analyse die laat zien in welke mate elke variant de GPU op verschillende gelijktijdigheidsniveaus verzadigt:
Verhouding van de individuele TPS tot C=1 (verzadigingsindex):
| Gelijktijdigheid | FP8 | FP8-MTP | AWQ-MTP | NVFP4 | NVFP4-MTP |
|---|---|---|---|---|---|
| 1 | 100% | 100% | 100% | 100% | 100% |
| 2 | 100% | 102% | 100% | 99% | 103% |
| 4 | 97% | 95% | 91% | 96% | 95% |
| 8 | 93% | 85% | 79% | 92% | 87% |
| 16 | 83% | 71% | 59% | 81% | 69% |
Hoe leest u deze tabel?
De verzadigingsindex is de verhouding tussen de snelheid die een verzoek onder gelijktijdige belasting ziet en de snelheid die het zou zien als het alleen op de GPU zou draaien:
Saturation Index = (Individual TPS at level C) / (Individual TPS at C=1) × 100Concreet voorbeeld (FP8, C=16): Totale capaciteit 108.2 tok/s (tabel in paragraaf 6.1) ÷ 16 verzoeken ≈ 6.8 tok/s per verzoek. Omdat de individuele snelheid bij C=1 8.1 tok/s is, geldt 6.8 / 8.1 ≈ 83%.
100% betekent dat de prestaties van C=1 behouden blijven — verzoeken vertragen elkaar niet en er is nog ongebruikte capaciteit op de GPU. Een daling geeft aan dat verzoeken zijn gaan concurreren om dezelfde resources (vooral geheugenbandbreedte), dat wil zeggen dat de GPU verzadiging nadert. Waarden als 102-103% bij C=2 zijn meetruis.
Belangrijke nuance: Een lage index betekent niet dat het een “slechte variant” is; terwijl de index daalt, blijft de totale capaciteit toenemen (bijv. hoewel AWQ-MTP bij C=16 terugzakt tot 59%, is de totale uitvoer van 239.8 tok/s meer dan het dubbele van die van FP8). Het praktische nut van de index is dit: als de SLA van de dienst een minimumsnelheid per gebruiker vereist, kan het redelijke gelijktijdigheidsplafond voor elke variant uit deze tabel worden afgelezen. Deze index is wiskundig identiek aan de kolom “Efficiëntie” in paragraaf 6.1; waar 6.1 de berekening voor twee varianten uitwerkt, brengt deze tabel alle vijf varianten samen in één kaart.
Beoordeling:
- AWQ-MTP zakt terug tot 79% bij C=8 en 59% bij C=16. De GPU heeft verzadiging bereikt en extra belasting veroorzaakt ernstig prestatieverlies.
- FP8 en NVFP4 zitten zelfs bij C=16 nog op 81-83%. Er is nog rekencapaciteit op de GPU; het knelpunt ligt bij de geheugenbandbreedte.
- Varianten met MTP hebben op alle niveaus een lagere verzadigingsindex, omdat ze de GPU efficiënter gebruiken en er minder ongebruikte capaciteit overblijft voor extra belasting.
6.3 Knelpunt vaststellen: prefill vs decode
Analyse van het knelpunt op basis van het gedrag van de twee hoofdfasen onder gelijktijdigheid:
| Fase | Metriek | Verandering C=1→C=16 | Type knelpunt |
|---|---|---|---|
| Prefill | TTFT | 2-3x toename | Rekengebonden |
| Decode | ITL | 17-62% toename | Gebonden aan geheugenbandbreedte |
Beoordeling:
- De prefill-fase is rekengebonden: alle invoertokens worden in één keer verwerkt, wat intensieve matrixvermenigvuldigingen vereist. Gelijktijdige verzoeken moeten de SM-eenheden (Streaming Multiprocessor) van de GPU delen.
- De decode-fase is gebonden aan geheugenbandbreedte: per stap wordt slechts één token gegenereerd (of enkele met MTP); de dominante bewerking is het laden van gewichten uit het GPU-geheugen. Sterker gecomprimeerde formaten (AWQ, NVFP4) verlichten dit knelpunt doordat ze minder data verplaatsen.
Praktische gevolgen:
- In scenario’s met lange prompts (samenvatten van lange documenten enz.) zal het prefill-knelpunt domineren
- In scenario’s met korte prompts maar lange antwoorden (codegeneratie, creatief schrijven) zal het decode-knelpunt domineren
- AWQ-MTP is de configuratie die het bandbreedteknelpunt van decode het best oplost
6.4 Hardwarebeperkingen van DGX Spark (SM121) en NVFP4-prestaties
NVFP4 halveert met 4-bitcompressie de benodigde geheugenbandbreedte ten opzichte van FP8. Omdat de decode-fase geheugengebonden is, belooft dit theoretisch een versnelling van ~2x. Zoals in paragraaf 3.1 te zien is, is NVFP4 echter slechts 21-18% sneller dan FP8. Deze paragraaf onderzoekt vanuit hardware- en softwareperspectief waarom NVFP4 zijn theoretische versnelling niet kan waarmaken.
6.4.1 Vergelijking van de architecturen SM121 en SM100
DGX Spark bevat de GB10-SoC, waarin de NVIDIA Grace-CPU (ARM64) en de Blackwell-GPU in dezelfde package zitten. Het systeem gebruikt 128 GB LPDDR5x (273 GB/s) unified memory dat door CPU en GPU wordt gedeeld; er is geen afzonderlijk VRAM. De GPU is gebaseerd op de SM 12.1-architectuur (compute capability) en bevat 48 SM’s en 6,144 CUDA-cores. Volgens de gangbare telling zijn er 4 tensor cores per SM (≈192 in totaal); anders dan de 5e generatie tcgen05 + TMEM-infrastructuur van de datacenter-Blackwell (SM100) werken ze echter alleen via het mma.sync-pad op warp-niveau.
De datacenter-GPU’s van Blackwell (B200, GB200) zijn gebaseerd op de SM 10.0-architectuur (compute capability). Hoewel beide architecturen “Blackwell” worden genoemd, verschilt hun tensor-core-infrastructuur aanzienlijk:
| Kenmerk | SM100 (B200, CC 10.0) | SM121 (DGX Spark/GB10, CC 12.1) | Bron |
|---|---|---|---|
FP4 mma.sync (e2m1) |
— | ✅ Ondersteund | PTX ISA §9.7.15.5.14 [1] |
tcgen05.mma (TC-pad 5e generatie) |
✅ Ondersteund | ❌ Niet ondersteund | PTX ISA §9.7.17.7.1 [2] |
| Tensor Memory (TMEM) | 256 KB | Geen | PTX ISA §9.7.17.1 [3] |
| CTA Pairs / Cooperative MMA | ✅ Ondersteund | ❌ Niet ondersteund | PTX ISA §9.7.17.5.1 [4] |
| SMEM / SM (max) | 228 KB | 128 KB | Blackwell Tuning Guide [5] |
| SMEM / thread block (max) | 227 KB | 99 KB | Blackwell Tuning Guide [5] |
| Aantal SM’s | 148 (actief; 160 fysiek) | 48 | deviceQuery / TechPowerUp [5] |
| Tensor cores / SM | 4 (5e generatie, tcgen05) |
4 (mma.sync op warp-niveau) |
CUDA PG / TechPowerUp [5] |
| FP4-piek (met sparsity) | ~9 PFLOP | ~1 PFLOP | NVIDIA-specificatie |
| Geheugenbandbreedte | ~8 TB/s (HBM3e) | 273 GB/s (LPDDR5x) | NVIDIA-specificatie |
DGX Spark (SM121) heeft Blackwell-FP4-tensor-cores en de instructie mma.sync.aligned.m16n8k64.f32.e2m1.e2m1 draait op hardwareniveau. SM121 behoort tot de familie compute_120f, die CC 12.0 en 12.1 omvat [1], [6]. Anders dan bij de datacenter-GPU’s van Blackwell (SM100) is de volledige tensor-core-infrastructuur van de 5e generatie op SM121 echter niet beschikbaar: de instructieset tcgen05.mma [2], Tensor Memory [3] en CTA Pairs/Cooperative MMA [4] worden op SM121 niet ondersteund.
6.4.2 Waarom kan NVFP4 de theoretische versnelling niet waarmaken?
De redenen waarom NVFP4 op SM121 zijn theoretische potentieel niet bereikt, liggen zowel bij de hardware als bij de software:
1. Ontbreken van TMEM en druk op SMEM:
Op SM100 stelt 256KB TMEM FP4-kernels in staat tussenresultaten buiten SMEM te houden. Op SM121 is er geen TMEM; alle tussendata moeten passen in de 99KB SMEM per blok. Het block-scaled formaat van NVFP4 vereist dat E2M1-gewichten en FP8-blokschalen tegelijk in SMEM worden gehouden. De standaardtilegroottes van CUTLASS voor FP4, ontworpen voor SM100, overschrijden de SMEM-grens van 99KB per blok van SM121; metingen uit de community bevestigen dat de tilegroottes moeten worden verkleind om binnen dit budget te passen (tile-sweep van BTankut: 256×128 ≈154 TFLOPS voor prefill/grote batch en 128×128 ≈147 TFLOPS voor decode/kleine batch zijn de beste resultaten [10]). Deze verkleining leidt tot een lagere rekenintensiteit (arithmetic intensity) en een eerdere confrontatie met de grens van de geheugenbandbreedte.
2. Ontbreken van tcgen05.mma:
tcgen05.mma is de PTX-instructie die FP4-matrixvermenigvuldigingen het efficiëntst dispatcht [2]. Op SM121 kan alleen mma.sync.aligned.m16n8k64.f32.e2m1.e2m1 worden gebruikt; CUTLASS moet via het abstractiepad van de CuTe-API gaan.
3. Ontbreken van CTA Pairs / Cooperative MMA:
Op SM100 kunnen twee SM’s samen één MMA-bewerking uitvoeren [4]. Op SM121 is dit samenwerkingsmechanisme niet beschikbaar.
4. Minder SM’s en een zwakker tensor-core-pad:
Waar SM100 (B200) 148 actieve SM’s heeft, bevat DGX Spark (SM121) slechts 48 SM’s (~3x verschil). Bovendien ontbreekt op SM121 de 5e generatie tcgen05 + TMEM-tensor-core-infrastructuur van SM100; SM121 valt terug op het mma.sync-pad op warp-niveau [5]. Samen beperken deze twee factoren de piekrekencapaciteit voor FP4 tot ~1 PFLOP (SM121) tegenover ~9 PFLOP (SM100) (zie bijlage A.1-4).
5. Geheugenbandbreedte:
273 GB/s LPDDR5x (SM121) tegenover ~8 TB/s HBM3e (SM100). Omdat de decode-fase geheugengebonden is, bespaart de 4-bitcompressie van NVFP4 op beide platforms bandbreedte; de lage bandbreedte van DGX Spark zorgt er echter voor dat de rekenversnelling tegen de bandbreedtegrens aanloopt en dat het rekenvoordeel van NVFP4 verloren gaat.
6. Overhead van E2M1-activatiekwantisatie:
In de W4A4-modus (gewichten en activaties 4-bit) vereist NVFP4 dat activaties tijdens runtime van BF16 naar E2M1 worden omgezet. Op SM121 kan de PTX-instructie cvt.rn.satfinite.e2m1x2.f32 worden gebruikt met de juiste compileervlaggen (sm_121a); het CMake-proces van vLLM v0.22.0 geeft deze vlaggen echter niet correct door (zie paragraaf 6.4.4).
6.4.3 Waarom is MTP + NVFP4 problematisch?
De NVFP4+MTP-configuratie heeft, zoals in paragraaf 2.5 besproken, de hoogste TTFT-waarde (519ms). De redenen:
- MTP brengt per decode-stap extra rekenbelasting mee (generatie van meerdere tokens + verificatie)
- De SMEM-beperkingen van NVFP4 maken het moeilijker om de extra rekenbelasting die MTP toevoegt op te vangen
- De prefill-fase is rekengebonden (paragraaf 6.3); terwijl de combinatie NVFP4+MTP de belasting in deze fase verhoogt, kan door het ontbreken van tcgen05 en de SMEM-beperkingen geen extra rekencapaciteit worden geleverd
- Resultaat: 127% toename van de TTFT (NVFP4 zonder MTP 228ms → NVFP4-MTP 519ms)
6.4.4 Tekortkomingen aan de softwarekant
Naast de hardwarebeperkingen is ook de softwareondersteuning voor NVFP4 op SM121 onvolledig. Deze tekortkomingen versterken de impact van de hardwarebeperkingen:
| Probleem | Beschrijving | Status |
|---|---|---|
Verwijdering van het CMake-suffix sm_121a |
vLLM compileert als sm_121a → sm_120, E2M1-PTX uitgeschakeld |
Opgelost met PR #37725 [7] |
| Fout in de SM121-capability-gate | De controle cuda_device_capability >= 110 maakt SM121 (121) ongeldig |
Opgelost met PR #38126 [8] |
| Software-E2M1-conversie ontbreekt | Als cvt.rn.satfinite.e2m1x2.f32 niet correct wordt gecompileerd, is er geen software-fallback |
Upstream opgenomen met PR #35947 [9] |
| CUTLASS-tilegroottes niet geoptimaliseerd voor SM121 | Standaardtiles ontworpen voor de 228KB SMEM van SM100 | Oplossing uit de community beschikbaar (BTankut) [10] |
| Grouped-GEMM-kernel voor MoE ontbreekt | Geen kernel die is geoptimaliseerd voor SM121 | FlashInfer PR #2650 in behandeling [11] |
| Beperking MTP + NVFP4 | In vLLM wordt de MTP-head in bepaalde NVFP4+MTP-paden niet geladen (geen algemeen verbod, afhankelijk van het pad) | Oplosbaar met een workaround die de MTP-head in BF16 houdt / Avarok-patch [12] |
Bron: vLLM Issue #37141 — Upstream DGX Spark improvements from Avarok-Cybersecurity/dgx-vllm
De softwareondersteuning voor NVFP4 op SM121 is nog niet volwassen; oplossingen uit de community kunnen de NVFP4-prestaties echter aanzienlijk verbeteren. Avarok-Cybersecurity biedt een geoptimaliseerde Docker-image met een Marlin W4A16-backend en software-E2M1-conversie [12]. BTankut levert verbeteringen met CUTLASS-tile-tuning en SM121-patches voor admissible_archs [10]. Er wordt gewerkt aan het upstream opnemen van deze ontwikkelingen in vLLM [vLLM Issue #37141]. Het ontbreken van tcgen05, TMEM en CTA Pairs vormt echter een hardwarematig plafond dat softwareverbeteringen niet kunnen doorbreken.
Alle metingen in dit rapport zijn uitgevoerd met de standaardimage vllm/vllm-openai:v0.22.0-ubuntu2404, zonder dat de genoemde community-patches zijn toegepast. De NVFP4- en NVFP4-MTP-resultaten hier weerspiegelen daarom de huidige upstream-toestand; met de patches toegepast kunnen verbeteringen worden verwacht (zie bijlage A.3 voor kwantitatieve schattingen).
6.4.5 Referenties
[1] NVIDIA, PTX ISA v9.3, Section 9.7.15.5.14 — Multiply-and-Accumulate Instruction: mma. “.e2m1 alternate floating point type mma operation requires sm_120a and is supported on sm_120f from PTX ISA version 8.8.” https://docs.nvidia.com/cuda/parallel-thread-execution/index.html#warp-level-matrix-instructions-mma
[2] NVIDIA, PTX ISA v9.3, Section 9.7.17.7.1 — tcgen05 Memory Alloc/Manage Instructions. Ondersteunde architecturen: sm_100a, sm_101a, sm_100f, sm_110f. SM120/SM121 staan niet in de lijst. https://docs.nvidia.com/cuda/parallel-thread-execution/index.html#tcgen05-memory-alloc-manage-instructions
[3] NVIDIA, PTX ISA v9.3, Section 9.7.17.1 — Tensor Memory. “On architecture sm_100a/sm_100f, the 5th generation TensorCore’s Tensor Memory has a two-dimensional structure of 512 columns and 128 rows per CTA, each cell 32-bits.” Geen TMEM-definitie voor SM120/SM121. https://docs.nvidia.com/cuda/parallel-thread-execution/index.html#tensor-memory
[4] NVIDIA, PTX ISA v9.3, Section 9.7.17.5.1 — CTA Pair. “Any 2 CTAs within the cluster whose %cluster_ctarank differs by the last bit only is said to form a CTA pair.” CTA Pairs maken deel uit van de tcgen05-instructiefamilie; niet geldig op architecturen die tcgen05 niet ondersteunen. https://docs.nvidia.com/cuda/parallel-thread-execution/index.html#tcgen05-cta-pair
[5] NVIDIA, Blackwell Tuning Guide — SMEM-limieten: CC 10.0 = 228 KB/SM, 227 KB/blok; CC 12.0/12.1 = 128 KB/SM, 99 KB/blok. Zie ook CUDA C++ Programming Guide Section 20.9/20.10. Aantallen SM’s en tensor cores van de B200 (148 actieve SM’s, 592 tensor cores; 160 fysieke SM’s) uit de TechPowerUp-database voor de B200; de waarde van 48 SM’s voor DGX Spark is bevestigd met de uitvoer van deviceQuery. https://docs.nvidia.com/cuda/blackwell-tuning-guide/index.html · https://docs.nvidia.com/cuda/cuda-c-programming-guide/index.html
[6] NVIDIA, CUDA C++ Programming Guide, Table 25 — Family-Specific Compatibility. “compute_120f: Compatible with Compute Capability 12.0, 12.1.” https://docs.nvidia.com/cuda/cuda-c-programming-guide/index.html#feature-availability
[7] RobTand, vLLM PR #37725 — Preserve CUDA arch suffix (a/f) for SM12x — fixes NVFP4 NaN on desktop Blackwell. https://github.com/vllm-project/vllm/pull/37725
[8] johnnynunez, vLLM PR #38126 — Fix DGX Spark logic. https://github.com/vllm-project/vllm/pull/38126
[9] blake-snc, vLLM PR #35947 — Software E2M1 conversion for SM12x NVFP4 activation quantization. https://github.com/vllm-project/vllm/pull/35947
[10] NVIDIA Developer Forums, FP4 on DGX Spark — Why It Doesn’t Scale Like You’d Expect. Resultaten van de CUTLASS-tile-tuning door BTankut. https://forums.developer.nvidia.com/t/fp4-on-dgx-spark-why-it-doesnt-scale-like-youd-expect/360142
[11] kahyunnam, FlashInfer PR #2650 — Enable sm120f compilation. https://github.com/flashinfer-ai/flashinfer/pull/2650
[12] Avarok-Cybersecurity, dgx-vllm GitHub. NVFP4-verbeteringen voor DGX Spark. https://github.com/Avarok-Cybersecurity/dgx-vllm
7. Staartlatentie en stabiliteit
7.1 p90/p50-verhoudingen
De p90/p50-verhouding geeft aan hoe dik de staart van de latentieverdeling is. Ligt de verhouding dicht bij 1.0, dan is de verdeling smal en voorspelbaar; is die hoog, dan worden sommige verzoeken veel langzamer voltooid dan verwacht.
p90/p50-verhoudingen van de ITL:
| Variant | C=1 | C=4 | C=8 | C=16 |
|---|---|---|---|---|
| FP8 | 1.00 | 1.00 | 1.01 | 1.02 |
| FP8-MTP | 1.05 | 1.06 | 1.10 | 1.08 |
| AWQ-MTP | 1.05 | 1.08 | 1.11 | 1.11 |
| NVFP4 | 1.00 | 1.00 | 1.01 | 1.02 |
| NVFP4-MTP | 1.12 | 1.08 | 1.08 | 1.12 |
p90/p50-verhoudingen van de TTFT:
| Variant | C=1 | C=4 | C=8 | C=16 |
|---|---|---|---|---|
| FP8 | 1.20 | 1.28 | 1.08 | 1.19 |
| FP8-MTP | 1.02 | 1.05 | 1.08 | 1.13 |
| AWQ-MTP | 1.35 | 1.15 | 1.24 | 1.29 |
| NVFP4 | 1.13 | 1.15 | 1.29 | 1.11 |
| NVFP4-MTP | 1.02 | 1.42 | 1.15 | 1.56 |
p90/p50-verhoudingen van de TPS:
| Variant | C=1 | C=4 | C=8 | C=16 |
|---|---|---|---|---|
| FP8 | 1.00 | 1.01 | 1.01 | 1.01 |
| FP8-MTP | 1.11 | 1.06 | 1.07 | 1.07 |
| AWQ-MTP | 1.07 | 1.10 | 1.08 | 1.09 |
| NVFP4 | 1.01 | 1.01 | 1.01 | 1.00 |
| NVFP4-MTP | 1.03 | 1.08 | 1.06 | 1.07 |
Beoordeling:
- Stabiliteit van de ITL: Modellen zonder MTP (FP8, NVFP4) hebben een vrijwel perfecte stabiliteit (p90/p50 ≈ 1.00-1.02). Bij modellen met MTP ligt de verhouding tussen 1.05-1.12. Dit wijst erop dat MTP schommelingen veroorzaakt in de acceptatieverhouding van de tokengeneratie.
- Stabiliteit van de TTFT: De grootste schommeling wordt waargenomen bij NVFP4-MTP (1.56 bij C=16). Dit wijst erop dat de NVFP4+MTP-configuratie onvoorspelbaar gedrag vertoont in de prefill-fase. Ook AWQ-MTP vertoont grote schommelingen (1.29-1.35).
- Stabiliteit van de TPS: Die ligt bij alle varianten op een acceptabel niveau (1.00-1.11). Omdat de TPS de inverse van de ITL is, worden vergelijkbare verhoudingen verwacht; het meetgemiddelde is echter stabieler.
7.2 Welke variant is het best voorspelbaar?
Rangschikking (van best tot minst voorspelbaar):
- NVFP4 — Uitstekende stabiliteit in ITL en TPS, gemiddeld in TTFT
- FP8 — Dicht bij NVFP4, lage schommeling op alle metrieken
- FP8-MTP — Gemiddeld in ITL en TPS, goede stabiliteit in TTFT
- AWQ-MTP — Gemiddeld in ITL, grote schommeling in TTFT
- NVFP4-MTP — Grootste schommeling in ITL, grootste schommeling in TTFT
7.3 Schommeling van de latentie onder belasting
De belangrijkste reden voor de grotere schommeling bij modellen met MTP is de werking van MTP:
- Per stap worden meerdere tokens gegenereerd, maar een deel daarvan wordt verworpen
- Het verwerpingspercentage varieert afhankelijk van de context en de toestand van het model
- In stappen met een hoog verwerpingspercentage daalt de effectieve TPS en neemt de ITL toe
- Hierdoor stijgt de p90/p50-verhouding
De grote TTFT-schommeling die vooral bij NVFP4-MTP wordt waargenomen (p90/p50 = 1.56 @ C=16) suggereert dat deze configuratie een risico kan vormen voor kritieke toepassingen; deze waarde kan echter zijn beïnvloed door de beperkte steekproefgrootte (zie paragraaf 1.7, Beperking) en moet vóór een SLA-beslissing worden bevestigd met een groter aantal verzoeken. In systemen met SLA-eisen (bijv. “99% van de verzoeken moet binnen 1 seconde antwoorden”) moet met deze schommeling rekening worden gehouden.
8. Optimaal werkpunt en aanbevelingen
8.1 Handleiding voor de keuze van een variant
| Scenario | Aanbevolen variant | Gelijktijdigheid | Motivatie |
|---|---|---|---|
| Interactieve chatbot | AWQ-MTP | 1-2 | Laagste latentie (5.04s), hoogste TPS (25.45). De gebruiker krijgt snel antwoord. |
| Codeassistent (autocomplete) | AWQ-MTP | 1-2 | Lage TTFT (267ms) + hoge TPS. Directe suggesties zijn cruciaal tijdens het programmeren. |
| API-dienst (lage belasting) | AWQ-MTP | 1-4 | Zelfs bij C=4 zijn een TPS van 23 tok/s en een latentie van 5.68s acceptabel. |
| API-dienst (hoge belasting) | NVFP4-MTP | 8-16 | De totale doorvoer neemt toe met de gelijktijdigheid (systeembreed 231 tok/s bij C=16); NVFP4-MTP biedt onder hoge belasting een doorvoer die dicht bij die van AWQ-MTP ligt, met een evenwichtigere schaling. |
| Batchverwerking | NVFP4-MTP of FP8-MTP | 8-16 | Bij batchverwerking telt het totale aantal tokens/s; bij C=16 halen varianten met MTP ~221-232 tok/s, ongeveer het dubbele van die zonder MTP (~108-128) (zie paragraaf 6.1). |
| Systeem met SLA-eisen | FP8 of NVFP4 | 1-4 | Laagste schommeling. p90/p50 ≈ 1.0. Voorspelbare prestaties zijn cruciaal. |
| Latentie tot het eerste token cruciaal | NVFP4 | 1-2 | Laagste TTFT (228ms). De gebruiker ziet direct een antwoord. |
| Omgeving met beperkt geheugen | NVFP4-MTP | 1-4 | 4-bitcompressie + MTP levert de kleinste geheugenvoetafdruk + hoge snelheid. (Op DGX Spark wordt het geheugen gedeeld tussen CPU en GPU; een kleine voetafdruk laat ruimte voor andere workloads.) |
8.2 Optimale gelijktijdigheidsniveaus
Voor elke variant het optimale evenwichtspunt tussen de prestaties per individueel verzoek en de totale doorvoer:
De optimale gelijktijdigheid hangt af van waarvoor u optimaliseert; er is geen enkele “juiste” waarde:
| Variant | Optimale C voor latentie | Optimale C voor doorvoer | Opmerking |
|---|---|---|---|
| FP8 | 1-2 | 8-16 | Schalingsefficiëntie 83% bij C=16; systeembrede RPS 0.06 → 0.85. |
| FP8-MTP | 1-2 | 8-16 | Systeembrede RPS 1.72 bij C=16 (~11x). |
| AWQ-MTP | 1-2 | 4-8 | Hoogste snelheid per verzoek; de schalingsefficiëntie daalt snel bij C≥8 (59%). |
| NVFP4 | 1-2 | 8-16 | Stabielste variant; systeembrede RPS 1.00 bij C=16. |
| NVFP4-MTP | 1-2 | 8-16 | TPS/latentie verbetert licht bij C=2 (verschil binnen de ruismarge; zie paragraaf 1.7); systeembrede RPS 1.80 bij C=16. |
Algemene regel:
- Latentiekritisch / één gebruiker (chatbot, codeassistent): C=1-2. Het individuele verzoek krijgt hier het snelste antwoord.
- Doorvoerkritisch / dienst voor meerdere gebruikers (API, batch): C=8-16. De systeembrede capaciteit (totale RPS en tokens/s) neemt met de gelijktijdigheid ~9-13x toe (zie paragrafen 5.5 en 6.1); in ruil daarvoor dalen de latentie/TPS per verzoek enigszins.
Zoals in paragraaf 5.5 uitgelegd, komt de indruk dat “gelijktijdigheid de totale capaciteit niet verhoogt” voort uit een verkeerde lezing van de metriek “Throughput (RPS)” per verzoek van de meettool (1/latency). In werkelijkheid raakt de GPU met één enkel verzoek niet verzadigd; batching verhoogt de systeemdoorvoer aanzienlijk. De schalingsefficiëntie daalt echter onder belasting (83% voor FP8 bij C=16, 59% voor AWQ-MTP), zodat het rendement niet onbeperkt is — daarom moet ook in doorvoerkritische scenario’s bij zeer hoge gelijktijdigheid worden gelet op de toename van de staartlatentie.
8.3 Aanbevelingen voor de keuze van de kwantisatie
Waarom is AWQ-MTP de prestatiewinnaar?
AWQ kwantiseert de gewichten naar 4-bit en houdt de activaties op volledige precisie. Dit brengt de besparing op geheugenbandbreedte in evenwicht met de nauwkeurigheid van het model. In combinatie met MTP:
- Wordt de druk op de geheugenbandbreedte in de decode-fase verlicht (kleinere gewichten)
- Genereert MTP meerdere tokens, waarvan de meeste worden geaccepteerd
- Nettoresultaat: de ITL daalt 69%, de TPS stijgt 213% (ten opzichte van de FP8-baseline)
Benadrukt moet worden dat deze aanwijzing als “winnaar” uitsluitend op snelheidsmetrieken is gebaseerd; het meten van de nauwkeurigheid valt buiten het bestek van dit werk en moet vóór een productiebeslissing afzonderlijk worden uitgevoerd.
Maar de risico’s van AWQ:
- 4-bitkwantisatie kan tot verlies van modelnauwkeurigheid leiden. Deze benchmark omvat geen nauwkeurigheidsmeting; de modelkwaliteit moet voor zowel AWQ als NVFP4 afzonderlijk worden beoordeeld. (De NVFP4-variant is gekalibreerd op UltraChat met een budget van ~2M tokens; zie paragraaf 1.3.)
- De prestatiedaling is steiler bij hoge gelijktijdigheid (41%)
- De TTFT-schommeling is groter
Wanneer verdient NVFP4-MTP de voorkeur?
- Als u volledig wilt profiteren van hardwareversnelling op NVIDIA Blackwell-GPU’s
- In omgevingen met beperkt geheugen (kleinste geheugenvoetafdruk)
- Bij hoge belasting (C=8-16)
Vooruitblik: De superioriteit van AWQ-MTP in dit rapport is een momentopname van ongepatchte standaard-vLLM v0.22.0. Naarmate de softwarecorrecties uit paragraaf 6.4.4 upstream worden opgenomen, wordt verwacht dat NVFP4-MTP gelijk komt met AWQ-MTP en het bij hoge gelijktijdigheid overtreft (zie bijlage A.3 voor een kwantitatieve analyse). Als op DGX Spark installaties met een lange levensduur worden gepland, moet NVFP4, het hardware-native formaat, als strategische keuze worden overwogen.
9. Conclusie
9.1 Samenvatting van de belangrijkste bevindingen
-
MTP levert een drastische versnelling op: De TPS stijgt 140% bij FP8 en 113% bij NVFP4. De latentie daalt met meer dan de helft. MTP is op DGX Spark de effectiefste techniek om de prestaties ingrijpend te verbeteren.
-
AWQ-MTP is de snelste variant: 25.45 tok/s (C=1), 37.57ms ITL, 5.04s latentie. De combinatie van besparing op geheugenbandbreedte + MTP levert in de decode-fase een uniek snelheidsvoordeel op. (Opmerking: deze beoordeling is uitsluitend op snelheid gebaseerd; de nauwkeurigheid is niet gemeten.)
-
NVFP4 is consequent beter dan FP8: In de vergelijking zonder MTP is de TPS 21% hoger, de ITL 18% lager en de latentie 18% lager. Het bandbreedtevoordeel van 4-bitcompressie is duidelijk.
-
Gelijktijdigheid is een afweging tussen latentie en doorvoer: Het verhogen van de gelijktijdigheid vermindert de prestaties per individueel verzoek enigszins (latentie, TPS per verzoek); het verhoogt echter de systeembrede totale capaciteit aanzienlijk (totaal aantal tokens/s en RPS ~13x bij FP8, ~9-11x bij varianten met MTP). Opmerking: omdat de metriek “Throughput (RPS)” van de meettool per verzoek is (
1/latency), is die per definitie onafhankelijk van de gelijktijdigheid; de systeemcapaciteit wordt gemeten alsTPS × Concurrency(zie paragrafen 5.5, 6.1). De schalingsefficiëntie neemt onder belasting wel af (59-83% bij C=16). -
De TTFT is de gevoeligste metriek: Die stijgt 2-3x bij toenemende gelijktijdigheid. De prefill-fase is rekengebonden en bij gelijktijdige verzoeken ontstaan ernstige vertragingen.
-
Het voordeel van MTP neemt onder belasting af: De TPS-versnellingsfactor daalt bij FP8 van 2.40x (C=1) naar 2.05x (C=16). Bij NVFP4 daalt die van 2.13x naar 1.81x.
-
Modellen zonder MTP zijn stabieler: De p90/p50-verhoudingen zijn ~1.00 in ITL en ~1.15 in TTFT. Bij modellen met MTP: ITL ~1.05-1.12, TTFT ~1.02-1.56.
-
De huidige achterstand van NVFP4 is niet blijvend: Alle metingen zijn uitgevoerd met standaard-vLLM v0.22.0 zonder toegepaste community-patches. Wanneer de softwarecorrecties uit paragraaf 6.4.4 worden toegepast, wordt verwacht dat NVFP4-MTP AWQ-MTP inhaalt en het onder hoge belasting overtreft — zelfs bij C=16 is het verschil vandaag slechts ~3.5% (zie bijlage A.3).
Bijlage A: Kwantitatieve impact van de hardwaretekortkomingen van SM121
Paragraaf 6.4 legt vanuit hardware- en softwareperspectief uit waarom NVFP4 op SM121 zijn theoretische potentieel niet kan bereiken. De concrete prestatie-impact van elke tekortkoming is daar echter niet kwantitatief gegeven. Deze bijlage maakt de impact van elk van de genoemde tekortkomingen op de NVFP4-prestaties concreet.
A.1 Concrete prestatie-impact van de hardwaretekortkomingen
1. Ontbreken van TMEM → noodzaak om tiles te verkleinen
Op SM100 is 256KB TMEM + 228KB SMEM = in totaal 484KB ruimte voor tussendata beschikbaar. Op SM121 is er geen TMEM; alle tussendata moeten passen in de 99KB SMEM per blok. De standaardtilegroottes van CUTLASS voor FP4, ontworpen voor SM100, overschrijden dit budget van 99KB (bevestigd door metingen uit de community [10]), zodat de tilegrootte moet worden verkleind:
- Kleinere tile = lagere rekenintensiteit (verhouding rekenwerk/bandbreedte)
- Lage rekenintensiteit = eerdere confrontatie met de grens van de geheugenbandbreedte
- Resultaat: de bandbreedtebesparing die de 4-bitcompressie van NVFP4 oplevert, kan niet worden benut omdat de rekeneenheden niet voldoende worden gevoed
2. Ontbreken van tcgen05.mma → geen efficiënt dispatchmechanisme
tcgen05.mma is de PTX-instructie op SM100 die een FP4-GEMM in één instructie direct naar de tensor core dispatcht. Op SM121 kan alleen mma.sync.aligned.m16n8k64.f32.e2m1.e2m1 worden gebruikt. CUTLASS moet via de abstractielaag van de CuTe-API gaan:
- Meer overhead voor registerbeheer
- Meer overhead voor SMEM-beheer
- Minder optimale scheduling (handmatige pipelining op softwareniveau in plaats van de automatische pipelining op hardwareniveau van tcgen05)
3. Ontbreken van CTA Pairs / Cooperative MMA → samenwerking tussen SM’s onmogelijk
Op SM100 kunnen twee SM’s samen één MMA-bewerking uitvoeren (CTA Pair). Dit is een cruciale mogelijkheid voor grote tilegroottes: matrixvermenigvuldigingen die te groot zijn om door één SM alleen te worden verwerkt, kunnen over twee SM’s worden verdeeld. Op SM121 moet elke SM geïsoleerd werken:
- Grote matrixvermenigvuldigingen moeten in kleinere stukken worden opgedeeld
- Overhead door het opdelen: afzonderlijk laden van SMEM en afzonderlijke synchronisatie voor elk stuk
- Werk dat op SM100 met één CTA Pair wordt gedaan, gebeurt op SM121 met meerdere onafhankelijke CTA’s → extra coördinatiekosten
4. Minder SM’s en ontbreken van de tensor-core-infrastructuur van de 5e generatie → ~9x verschil in totale FP4-rekencapaciteit
| Architectuur | Aantal SM’s | Tensor cores / SM | Totaal aantal tensor cores | Tensor-core-pad | FP4-piek (met sparsity) |
|---|---|---|---|---|---|
| SM100 (B200) | 148 (actief) | 4 | 592 | 5e generatie tcgen05 + TMEM |
~9 PFLOP |
| SM121 (DGX Spark) | 48 | 4 | ~192 | mma.sync op warp-niveau |
~1 PFLOP |
Het verschil is niet het vaak genoemde “1 vs 4 tensor cores per SM” — volgens de gangbare telling hebben beide architecturen 4 tensor cores per SM. Het werkelijke verschil komt uit twee bronnen: (a) het aantal SM’s (148 actief tegenover 48, ~3x) en (b) de generatie/het programmeermodel van de tensor cores — SM100 heeft de 5e generatie tcgen05 + TMEM-infrastructuur die met één instructie dispatcht, terwijl SM121 alleen het mma.sync-pad op warp-niveau heeft. Samen leiden deze twee factoren tot een FP4-piekrekenkracht van ~1 PFLOP (SM121) tegenover ~9 PFLOP (SM100), een verschil van ongeveer een orde van grootte (≈9x). Dit verschil treft vooral de prefill-fase (rekengebonden); het hangt direct samen met de hoge TTFT (519ms) die bij NVFP4-MTP is waargenomen.
5. Geheugenbandbreedte → 273 GB/s vs ~8 TB/s
| Architectuur | Geheugentype | Bandbreedte |
|---|---|---|
| SM100 (B200) | HBM3e | ~8 TB/s |
| SM121 (DGX Spark) | LPDDR5x | 273 GB/s |
Het verschil in bandbreedte is ~29x. De 4-bitcompressie van NVFP4 bespaart op beide platforms bandbreedte; de lage bandbreedte van DGX Spark zorgt er echter voor dat de rekenversnelling tegen de bandbreedtegrens aanloopt. Met andere woorden: NVFP4 verplaatst minder data dan FP8 (4-bit tegenover 8-bit), maar de bandbreedte van 273 GB/s is al zo laag dat het rekenvoordeel van NVFP4 onder de bandbreedtegrens verloren gaat.
6. Overhead van E2M1-activatiekwantisatie
In de W4A4-modus (gewichten en activaties 4-bit) vereist NVFP4 dat activaties tijdens runtime van BF16 naar E2M1 worden omgezet. Op SM121 kan de PTX-instructie cvt.rn.satfinite.e2m1x2.f32 worden gebruikt met de juiste compileervlaggen (sm_121a); het CMake-proces van vLLM v0.22.0 geeft deze vlaggen echter niet correct door (paragraaf 6.4.4). Als de hardware-instructie is uitgeschakeld, is softwareconversie nodig; deze extra rekenbelasting vertraagt zowel de prefill- als de decode-fase.
A.2 Analyse van theoretische vs gerealiseerde versnelling
NVFP4 halveert de benodigde geheugenbandbreedte ten opzichte van FP8 door de gewichten naar 4-bit te comprimeren. Omdat de decode-fase geheugengebonden is, belooft dit theoretisch een versnelling van ~2x. De werkelijke prestaties:
| Platform | TPS-verhouding NVFP4 / FP8 | Verwacht | Gerealiseerd | Verlies |
|---|---|---|---|---|
| SM121 (DGX Spark) [dit rapport] | ~1.21x | ~2.0x | ~1.21x | ~40% |
Op SM121 realiseert NVFP4 slechts ~60% van de theoretische versnelling van ~2x (gemeten ~1.21x; verlies ~40%). In deze studie is geen vergelijkende meting op datacenter-Blackwell (SM100) uitgevoerd; de SM121-specifieke hardwaretekortkomingen die in paragraaf 6.4 zijn gedocumenteerd (het ontbreken van TMEM, tcgen05 en CTA Pairs, en de SMEM-beperking) wijzen er echter op dat een aanzienlijk deel van het verlies platformspecifiek is. De uitsplitsing van het verlies wordt in de onderstaande tabel als schatting gegeven.
Uitsplitsing van het verlies:
| Bron | Geschatte bijdrage | Beschrijving |
|---|---|---|
| Lage bandbreedte (273 GB/s) | ~15% | De rekenversnelling van NVFP4 loopt tegen de bandbreedtegrens aan |
| SMEM-beperking + verkleining van tiles | ~8% | Lage rekenintensiteit vermindert het bandbreedtevoordeel |
| Minder SM’s (48 vs 148) | ~5% | Beperkt de totale FP4-capaciteit; treft prefill direct, decode indirect |
| Ontbreken van tcgen05 + TMEM + CTA Pairs | ~5% | Inefficiënte dispatch + isolatie van SM’s (terugval op het mma.sync-pad op warp-niveau) |
| Software-E2M1-conversie | ~3-5% | Extra rekenbelasting bij onjuiste compilatie |
| Totaal | ~36-38% | Consistent met een verlies van ≈40% |
Opmerking: De bovenstaande percentages zijn schattingen en vertegenwoordigen onderling samenhangende interacties die moeilijk te isoleren zijn. Het totaal is geen eenvoudige som van de afzonderlijke bijdragen, maar weerspiegelt hun gecombineerde effecten.
A.3 Haalbaar plafond met softwareverbeteringen
Als de in paragraaf 6.4.4 genoemde softwarecorrecties (CMake-suffixfout, capability-gate-fout, software-E2M1-conversie, CUTLASS-tile-tuning, Marlin W4A16-backend) worden toegepast:
| Scenario | TPS-verhouding NVFP4 / FP8 | Verbetering |
|---|---|---|
| Huidig (vLLM v0.22.0, niet gecorrigeerd) | ~1.21x | — |
| Na toepassing van de softwarecorrecties (geschat) | ~1.30-1.40x | ~+8-19% |
| Theoretisch plafond (hardwaregrens) | ~1.30-1.40x | — |
Softwareverbeteringen kunnen de versnellingsfactor van NVFP4 ten opzichte van FP8 verhogen van ~1.21x naar ~1.30-1.40x. Het ontbreken van tcgen05, TMEM en CTA Pairs vormt echter een hardwarematig plafond dat softwareverbeteringen niet kunnen doorbreken. Een versnelling van NVFP4 ten opzichte van FP8 van meer dan ~1.4x is op SM121 door deze hardwaretekortkomingen niet mogelijk.
Vergelijking met AWQ-MTP — verwachting na de softwarecorrecties:
De verhouding van AWQ-MTP, de snelheidswinnaar in dit rapport, tot FP8-MTP is ~1.31x (25.45 / 19.50 tok/s). Omdat de voorspelde band van ~1.30-1.40x voor NVFP4 na de softwarecorrecties deze waarde omvat en overschrijdt, wordt verwacht dat NVFP4-MTP, wanneer alle correcties zijn toegepast, AWQ-MTP inhaalt en het waarschijnlijk met een kleine marge overtreft (schatting: 19.50 × 1.30-1.40 ≈ 25.4-27.3 tok/s tegenover AWQ-MTP 25.45 tok/s).
Drie factoren ondersteunen deze verwachting:
- Bij hoge gelijktijdigheid is het verschil al gedicht: Bij C=16 is de totale capaciteit van NVFP4-MTP 231.5 tegenover AWQ-MTP 239.8 tok/s — zelfs ongepatcht is het verschil slechts ~3.5% (paragraaf 6.1). Omdat de verzadigingsindex van AWQ-MTP steiler daalt (59% tegenover NVFP4-MTP 69% bij C=16, paragraaf 6.2), is NVFP4-MTP de meest waarschijnlijke kandidaat om onder belasting de leiding te nemen.
- De bekende bugs in het NVFP4+MTP-pad zijn direct softwaregerelateerd: Wanneer het TTFT-probleem van 519ms en de beperking bij het laden van de MTP-head (paragraaf 6.4.3-6.4.4) zijn opgelost, ontstaat voor NVFP4-MTP een verbeterruimte die aan de AWQ-kant geen tegenhanger heeft.
- Voordeel van het hardware-native pad: AWQ (W4A16) zet de gewichten vóór de berekening met de Marlin-kernel om naar BF16; NVFP4 gebruikt de native FP4-tensor-core-instructie van Blackwell (
mma.synce2m1). Naarmate de kernelsoftware volwassener wordt, neigt het verschil te groeien in het voordeel van het hardware-native formaat.
Toch geldt het hardwareplafond uit A.2 ook hier: op SM121 moet deze omslag worden verwacht op het niveau van gelijkstand of een voordeel van enkele procenten, niet als een grote sprong. Bovendien is deze vergelijking uitsluitend op snelheid gebaseerd; het nauwkeurigheidsgedrag van de twee formaten moet afzonderlijk worden beoordeeld (paragraaf 8.3).
Begeleidende whitepaper: Het vervolgrapport Schaling van Qwen3.6-27B op een DGX Spark-cluster breidt dit werk uit naar configuraties met meerdere nodes (TP1/TP2/TP4) met een nieuwere nightly-image van vLLM. De TP1-resultaten (één node) daarin voor hetzelfde NVFP4-model wijken af van de hier gemeten NVFP4-baseline; zie §1.5 van dat rapport voor een vergelijking van de twee runtimes naast elkaar.
Bijlage B: Grafieken per variant
Alle grafieken zijn beschikbaar in de mappen van de betreffende varianten:
| Variant | Map |
|---|---|
| FP8 | Qwen3.6-27B-FP8/ |
| FP8-MTP | Qwen3.6-27B-FP8-MTP/ |
| AWQ-MTP | Qwen3.6-27B-AWQ-MTP/ |
| NVFP4 | Qwen3.6-27B-NVFP4/ |
| NVFP4-MTP | Qwen3.6-27B-NVFP4-MTP/ |
Elke map bevat 5 PNG-grafieken (TTFT, ITL, TPS, latentie, doorvoer), 5 interactieve HTML-grafieken en 1 CSV-gegevensbestand.
Over ons — Aetherix
Aetherix B.V. is een in Nederland gevestigde leverancier van NVIDIA Jetson™-hardware voor edge AI. Het bedrijf is gespecialiseerd in Jetson-platforms voor robotica, automatisering en embedded systemen, en levert in heel Europa vanuit zijn distributiecentrum in Nederland.
Alle metingen in dit rapport zijn uitgevoerd met de opensourcetool CordatusAI/llm-benchmark, op een NVIDIA DGX Spark (GB10)-systeem.
| Web | aetherix.com |
| info@aetherix.com | |
| Contact | aetherix.com/contact |
| Adres | Oude Apeldoornseweg 41, A1.08, 7333 NR Apeldoorn, Nederland |
Rapportdatum: juli 2026
Testplatform: NVIDIA DGX Spark (GB10) · Model: Qwen3.6-27B
Opgesteld door: Aetherix B.V.