Publicatiedatum: juni 2026 Reikwijdte: Een integrale beslisgids die begint bij de vraag waarom een lokale LLM nodig is en voor wie, en doorloopt tot en met de keuze van hardware → model → software. Opmerking: Dit vakgebied verandert zelfs op korte termijn zeer sterk. De productnamen, prijzen en benchmarkresultaten hieronder gelden per juni 2026; wat blijft, zijn niet de namen, maar de categorieën en de beslislogica. Aan de hardwarekant wordt bewust alleen NVIDIA behandeld — de belangrijkste reden is het CUDA-ecosysteem (zie paragraaf 4.1).
Inhoudsopgave
- Managementsamenvatting
- 1. Inleiding
- 2. Waarom een lokale LLM? (Motivatie)
- 3. Wie heeft het nodig? (Doelgroepen en scenario’s)
- 4. Hardwarekeuze (NVIDIA)
- 4.1. Waarom NVIDIA? In één woord: CUDA
- 4.2. Eerste beslissing: training of inferentie?
- 4.3. De doorslaggevende maatstaf: VRAM (en het totale geheugenbudget)
- 4.4. Hoe inferentie werkt en metrieken voor de servicekwaliteit
- 4.5. Hardwareklassen (Aetherix-catalogus)
- 4.6. Multi-GPU
- 4.7. Alleen CPU + RAM
- 4.8. Koppeling van scenario aan hardware
- 4.9. Operationele kosten en totale eigendomskosten (TCO)
- 5. Modelkeuze
- 5.1. Wat kunt u met een lokale LLM doen? (toepassingen van inferentie)
- 5.2. Criteria voor de modelkeuze
- 5.3. Actuele families van open-weight modellen (medio 2026)
- 5.4. Balans tussen parametergrootte en prestaties
- 5.5. Kwantisatie
- 5.6. Keuze per taak (inclusief Turks)
- 5.7. Licentie (commercieel gebruik)
- 5.8. Waar vergelijkt u modellen in 2026?
- 5.9. Stel uw eigen evaluatieset (benchmarkset) samen
- 6. Softwarekeuze
- 6.A. Inferentie-engines (backend)
- 6.B. Alles-in-één desktopapplicaties
- 6.C. Self-hosted AI-werkruimtes van de nieuwe generatie
- 6.D. Klassieke web-UI’s en RAG-oplossingen
- 6.E. API-gateways / routering (gateway & router)
- 6.F. Tools voor fine-tuning & training (opensource)
- 6.G. Code-assistenten & agents (opensource)
- 7. Voorbeeldscenario’s voor deployment
- 8. Risico’s en aandachtspunten
- 9. Conclusie en aanbevelingen
- Woordenlijst (begrippen)
- Bronnen
Managementsamenvatting
- Lokale LLM betekent dat u het model op uw eigen hardware draait: data verlaten het apparaat nooit, internet is niet nodig en er zijn geen kosten per gebruik. De sterkste reden is dataprivacy en datasoevereiniteit (overheid, zorg, juridisch, financiën, defensie).
- De enige harde beperking is VRAM. Werkelijke behoefte = modelgewichten (weights) + KV-cache + activaties + ~20% reserve (headroom); modelgrootte en contextlengte bepalen de hardwareklasse (zie 4.3).
- Hardware (alleen NVIDIA — reden: CUDA): aan de edge Jetson → op het werkstation RTX PRO Blackwell (16–96 GB) → in het datacenter L40S / H100·H200 NVL → op grote schaal DGX Spark / B200·B300. De eerste vraag: training of inferentie (inference)?
- Model: voor de meeste workloads is 7–14B dense of ~30B MoE de optimale balans; voor commercieel gebruik zijn families met een Apache 2.0- / MIT-licentie (Qwen, DeepSeek, GLM) de veiligste basis. Bepaal eerst wat u gaat doen (5.1) en de selectiecriteria (5.2).
- Software: eenvoudige start met Ollama / LM Studio; productie met vLLM / TensorRT-LLM; voor agents + geheugen AI-werkruimtes; bij meerdere gebruikers zet u een gateway (LiteLLM e.d.) vooraan.
- Beslismethode: begin klein, meet op uw eigen evaluatieset (5.9) en schaal op naarmate de behoeften duidelijker worden. Vergeet bij de kosten de TCO niet (de GPU-kosten zijn slechts 30–40% van het totaal).
1. Inleiding
Een LLM (Large Language Model) is een AI-model dat is getraind op zeer grote hoeveelheden tekstdata en dat natuurlijke taal kan begrijpen en genereren. De meesten van ons gebruiken deze modellen via de cloud: diensten als ChatGPT, Claude en Gemini draaien het model op hun eigen servers, en wij benaderen het via internet.
Lokale LLM betekent dat u het model op uw eigen hardware draait — een laptop, een desktopwerkstation of een bedrijfsserver. Data verlaten het apparaat nooit, een internetverbinding is niet nodig en er zijn geen kosten per gebruik.
Het belangrijkste verschil tussen de twee benaderingen:
| Cloud-LLM | Lokale LLM | |
|---|---|---|
| Waar data worden verwerkt | Op de server van de aanbieder | Op uw eigen hardware |
| Kostenmodel | Gebruik/abonnement (doorlopend) | Hardware (eenmalig) + elektriciteit |
| Internet | Vereist | Niet vereist |
| Privacy | Vertrouwen op de aanbieder | Volledige controle |
| Toegang tot modellen | Beperkt tot wat de aanbieder biedt | Vrije keuze uit honderden open modellen |
| Aanpassing | Beperkt | Volledig (fine-tuning, RAG, eigen data) |
Het doel van deze handleiding is een actueel en bruikbaar antwoord te geven op de vraag: “Is een lokale LLM geschikt voor mij / mijn organisatie, en zo ja, welke combinatie van hardware, model en software moet ik kiezen?”
Over Aetherix
Aetherix B.V. is een in Nederland gevestigde leverancier van NVIDIA Jetson™-hardware voor edge AI, gespecialiseerd in Jetson-platforms voor robotica, automatisering en embedded systemen.
- Hardware: NVIDIA Jetson-developerkits, AI-kits, carrierboards en accessoires; NVIDIA DGX Spark-systemen; NVIDIA RTX PRO grafische kaarten.
- Expertise: een team met jarenlange praktijkervaring met Jetson en professionele GPU’s, en NVIDIA-systemen die zijn geselecteerd voor AI in de praktijk.
- Actief in de EU: conforme facturering, btw-validatie en transparante logistiek, met verzending door heel Europa vanuit Nederland.
De hardwareaanbevelingen in deze handleiding zijn gebaseerd op dit portfolio.
2. Waarom een lokale LLM? (Motivatie)
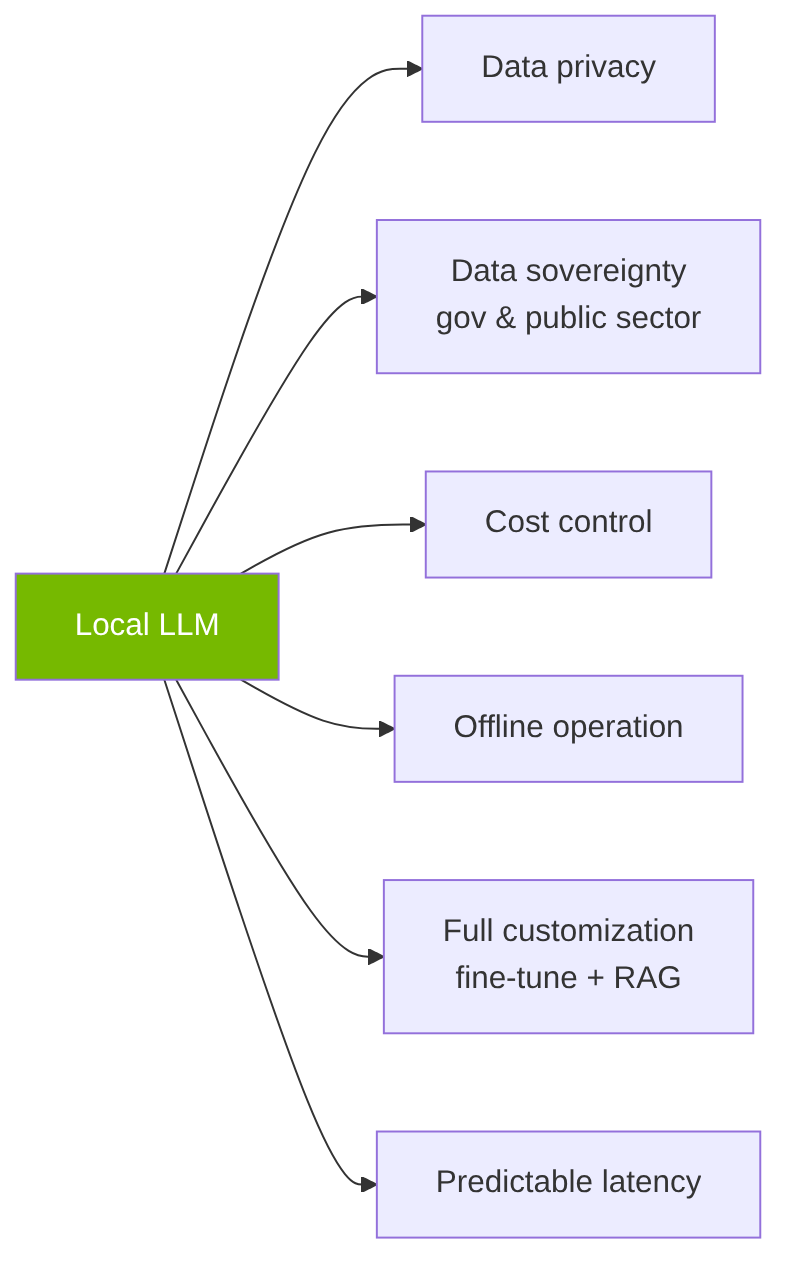
Figuur: Belangrijkste voordelen van een lokale LLM
Voordelen
Dataprivacy en -beveiliging. Dit is de sterkste reden. In sectoren als juridisch, zorg, financiën en defensie verlaten data het apparaat nooit; naleving van de regelgeving voor gegevensbescherming wordt aanzienlijk eenvoudiger. Gevoelige klantgegevens, contracten of patiëntendossiers worden niet naar de server van een derde partij gestuurd.
Datasoevereiniteit — overheid en publieke instellingen. Voor overheidsinstanties, kritieke infrastructuur en publieke instellingen is dit een van de meest doorslaggevende redenen: met een lokale LLM kan bedrijfs- of gerubriceerde informatie onder geen enkele omstandigheid naar buitenlandse servers of servers van derden lekken. Data worden volledig binnen de grenzen van de instelling, op haar eigen hardware, verwerkt; dit voldoet rechtstreeks aan de eisen van datasoevereiniteit en nationale veiligheid. Dat het zelfs op volledig geïsoleerde (air-gapped) en gerubriceerde netwerken kan draaien, is voor deze instellingen een cruciaal voordeel.
Kosten. Bij intensief en continu gebruik komt een eenmalige hardware-investering uiteindelijk onder de operationele kosten van cloudalternatieven uit; voor teams die grote aantallen aanroepen doen, bestaan de marginale kosten van een lokale opstelling vrijwel alleen uit elektriciteit.
Offline werking. Het werkt in omgevingen zonder internet (in het veld, op beveiligde netwerken, op air-gapped/geïsoleerde systemen).
Aanpassing. U kunt fine-tunen op uw eigen data, het model met RAG aan uw eigen documenten koppelen en het gedrag van het systeem volledig beheersen. Open-weight modellen leggen niet de beperkingen op die gesloten diensten afdwingen.
Voorspelbare latentie (latency). De snelheid hangt af van uw hardware; u bent niet afhankelijk van drukte bij de aanbieder, quotalimieten of storingen.
Aandachtspunten
- De juiste hardware kiezen. Uw beoogde modelgrootte vereist de juiste VRAM-/hardwareklasse; voor de zwaarste workloads en de grootste modellen zijn kaarten met meer geheugen of multi-GPU-plannen nodig (zie paragraaf 4).
- Initiële investering. Hardware is een eenmalige investering; bij de juiste dimensionering verdient die zich op de lange termijn terug.
- Technische kennis. Installatie, de keuze van kwantisatie (quantization) en het beheer van drivers/CUDA vergen een leercurve. (Tools van de nieuwe generatie hebben dit aanzienlijk eenvoudiger gemaakt.)
- Onderhoudslast. Updates, modelwisselingen en hardwareonderhoud zijn de verantwoordelijkheid van de instelling.
Samenvatting: Waar zorgen over privacy en datasoevereiniteit spelen, bij intensief gebruik of wanneer aanpassing nodig is, is een lokale LLM een sterke en duurzame keuze. Met de juiste combinatie van hardware, model en software kan de schaal naar behoefte van klein naar groot worden aangepast.
3. Wie heeft het nodig? (Doelgroepen en scenario’s)
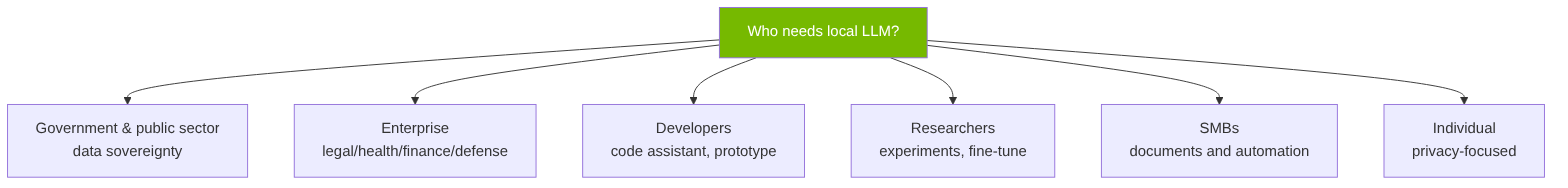
Figuur: Wie heeft een lokale LLM nodig?
Overheid en publieke instellingen. Ministeries, overheidsinstanties, kritieke infrastructuur en defensie — data binnen het land en binnen de grenzen van de eigen instelling houden en voorkomen dat ze naar buiten lekken, is een vereiste van datasoevereiniteit en nationale veiligheid. Voor deze instellingen is een lokale LLM vaak de enige geschikte optie.
Bedrijven (gevoelige data). Advocatenkantoren, ziekenhuizen/zorgaanbieders, financiële instellingen en de defensie-industrie — wanneer het intern houden van data een wettelijke of contractuele verplichting is, is een lokale LLM vrijwel de enige optie.
Ontwikkelaars. Onbeperkt prototypen zonder API-kosten; IDE-integratie als code-assistent; workflows met veel geautomatiseerde tests/aanroepen.
Onderzoekers en academici. Het bestuderen van modelgedrag, experimenten uitvoeren, fine-tuningstudies en wetenschappelijk werk dat volledige controle over het model vereist.
Mkb. Kleine en middelgrote ondernemingen die klantenservice, documentverwerking en interne automatisering willen opzetten zonder klantgegevens bloot te stellen.
Individuele/privacybewuste gebruikers. Persoonlijke assistent, beheer van notities/e-mail, hobbygebruik; wie zijn data aan geen enkel bedrijf wil geven.
Voor wie een kleine schaal volstaat: Bij uitsluitend incidenteel en licht gebruik is een instapkaart of een bestaand werkstation vaak voldoende; naarmate de behoeften groeien, kan de hardware stapsgewijs worden opgeschaald (zie paragraaf 4).
4. Hardwarekeuze (NVIDIA)
4.1. Waarom NVIDIA? In één woord: CUDA
De belangrijkste reden om voor lokale LLM-hardware voor NVIDIA te kiezen, is CUDA. CUDA is het softwareplatform dat NVIDIA biedt voor parallel rekenen op GPU’s, en het is de de-factostandaard van de AI-wereld geworden. De praktische gevolgen:
- Compatibiliteit met het ecosysteem. Vrijwel alle LLM-tools en -bibliotheken — PyTorch, TensorFlow, vLLM, TensorRT-LLM, llama.cpp, Ollama — worden primair op CUDA ontwikkeld en draaien het best op NVIDIA-hardware. Nieuw uitgebrachte modellen, kwantisatieformaten en optimalisaties verschijnen als eerste voor CUDA.
- Volwassenheid en verbreiding. CUDA wordt al meer dan tien jaar ontwikkeld; het biedt uitgebreide documentatie, ondersteuning vanuit de community en een overvloed aan kant-en-klare oplossingen. Loopt u tegen een probleem aan, dan bestaat de oplossing hoogstwaarschijnlijk al.
- Probleemloze installatie. Een “werkt direct uit de doos”-ervaring; het risico op incompatibiliteit van drivers, bibliotheken en toolchain wordt tot een minimum beperkt.
Daarom wordt in deze hele handleiding aan de hardwarekant alleen NVIDIA behandeld; alternatieve platforms hebben dit niveau van volwassenheid en ecosysteembreedte nog niet bereikt. Waar in de klassieke IT CPU + RAM + opslag vaak volstaat, bepaalt bij LLM’s de GPU-keuze rechtstreeks of het model überhaupt kan draaien: VRAM bepaalt de modelgrootte die kan draaien, geheugenbandbreedte (memory bandwidth) bepaalt de snelheid van tokengeneratie en FLOPS bepalen de snelheid van training en inferentie. Verkeerde GPU = het model draait helemaal niet of zeer traag.
4.2. Eerste beslissing: training of inferentie?
Dit is de belangrijkste vraag die de hardwarevereisten bepaalt. Het antwoord op “Wordt er getraind?” bepaalt vanaf het begin de schaal van de hardware die u nodig hebt.
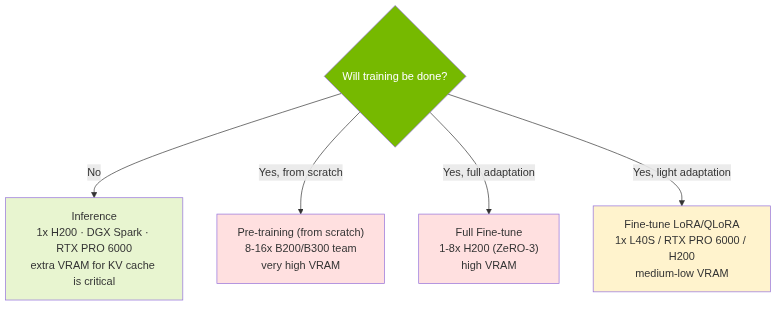
Figuur: Eerste beslissing: training of inferentie?
Voor de meeste organisaties is inferentie het startpunt — een kant-en-klaar open model op uw eigen server draaien. Training/aanpassing komt pas in beeld wanneer het model aan uw eigen data moet worden aangepast, en kent vier niveaus:
| Pre-training (vanaf nul) | Full fine-tune | Fine-tune (LoRA) | Fine-tune (QLoRA) | Inferentie | |
|---|---|---|---|---|---|
| VRAM-behoefte | Zeer hoog (~16× params) | Hoog (~12–14× params) | Gemiddeld (~2–3× params) | Laag (~0.6–1× params) | Model + KV-cache |
| 7B-model | 8× B200 (1 team) | 1× H200 (~85–100 GB) | 1× L40S / RTX PRO 6000 | 1× L40S | 1× L40S / RTX PRO 6000 |
| 70B-model | 8–16× B300 (1–2 teams) | 4–8× H200 (ZeRO-3) | 2–4× H200 | 1× DGX Spark / 1× H200 | 1× H200 (INT8) / 1× DGX Spark (INT8) — voor FP16 2× H200 (zie 4.8) |
| Duur | Weken–maanden | Dagen–1 week | Uren | Uren | — |
| Databehoefte | Biljoenen tokens | Miljoenen voorbeelden | Duizenden voorbeelden | Duizenden voorbeelden | — |
| Kosten | Zeer hoog | Hoog | Gemiddeld | Laag | Gemiddeld |
- Pre-training (vanaf nul): Het zwaarste scenario; alleen voor instellingen die hun eigen basismodel trainen. Vereist een B200/B300-cluster. Opmerking: De getallen “8×/16×” in de tabel zijn niet de werkelijke rekenbehoefte, maar de minimale verkoopeenheid van B200/B300 (een team van 8 GPU’s — zie 4.5/D). De werkelijke VRAM-behoefte is ruwweg 16× de modelgrootte (FP16-gewichten + gradiënten + toestanden van de Adam-optimizer): volledige training van 7B ≈ 120–150 GB, 70B ≈ 1 TB+ (plus activaties). Volledige training van 7B vraagt dus veel minder geheugen dan één team van 8 GPU’s biedt; ook als niet het hele team wordt gebruikt, is dit de kleinste verkoopeenheid.
- Full fine-tune: Werkt alle parameters van een voorgetraind model bij op uw eigen data. De VRAM-behoefte ligt dicht bij die van pre-training (~12–14× params — iets lager dankzij gradient checkpointing en doorgaans kortere sequenties), maar duur en data zijn veel minder. Geschikt voor diepgaande domeinaanpassing (specialistische gebieden zoals Turks, medisch, juridisch); komt in beeld wanneer LoRA tekortschiet. Risico — catastrofaal vergeten (catastrophic forgetting): Het bijwerken van alle parameters kan de algemene vaardigheden die tijdens pre-training zijn geleerd (andere talen, algemene kennis, redeneren) aantasten of overschrijven. LoRA/QLoRA beperkt dit risico grotendeels — de gewichten van het basismodel blijven bevroren en alleen kleine adapterlagen worden getraind; domeinaanpassing wordt toegevoegd terwijl de algemene vaardigheden behouden blijven. In de praktijk doen de meeste organisaties er goed aan met LoRA/QLoRA te beginnen. Kiest u voor volledige fine-tuning, beperk het risico dan met: een lage learning rate, datamenging (domeindata + algemene data samen), regularisatie (KL/L2) en een beperkt aantal epochs. (Opensourcetools: zie 6.F.)
- LoRA / QLoRA fine-tune: De praktische manier om een bestaand model aan uw eigen data aan te passen. Niet het hele model wordt getraind, alleen kleine extra lagen. Geheugenberekening: Bij LoRA zijn de basisgewichten bevroren, dus dragen alleen de FP16-gewichten (~2× params) + activaties met gradient checkpointing + kleine adaptergradiënten/Adam-toestanden bij → ~2–3× params; bij QLoRA worden de basisgewichten gekwantiseerd naar 4-bit NF4 (~0.5× params), plus activaties en een kleine adapteroverhead → ~0.6–1× params. Een 70B-model fine-tunen is zelfs met één DGX Spark mogelijk (met QLoRA — bij LoRA op FP16-basis zijn de 70B-gewichten alleen al ~140 GB en passen ze dus niet in 128 GB). (Opensourcetools: zie 6.F.)
- Inferentie: Alleen het model draaien. Hier is het extra VRAM dat voor de KV-cache wordt toegewezen cruciaal (zie 4.3); naarmate het aantal gelijktijdige gebruikers (concurrent users) groeit, neemt deze belasting toe.
4.3. De doorslaggevende maatstaf: VRAM (en het totale geheugenbudget)
Bij een lokale LLM is de enige harde beperking VRAM (het geheugen van de grafische kaart). Passen de modelgewichten + KV-cache niet in het GPU-geheugen, dan loopt het over naar het systeem-RAM (~10x trager) of draait het model helemaal niet.
Vuistregel (alleen gewichten):
- FP16 (16-bit): ~2 GB VRAM / miljard parameters
- 8-bit (Q8): de helft daarvan (~1 GB / miljard)
- 4-bit (Q4, bijv. Q4_K_M): een kwart (~0.5 GB / miljard). Q4_K_M geldt als de optimale balans tussen kwaliteit en geheugen, omdat het ~92–95% van de volledige precisie behoudt en het geheugen ~4× verkleint.
Geschat VRAM per modelgrootte (gewichten; tel daar KV-cache + reserve bij op):
| Model | FP16 | 8-bit | 4-bit (Q4_K_M) |
|---|---|---|---|
| 7B / 8B | ~14–16 GB | ~8 GB | ~5 GB |
| 14B | ~28 GB | ~15 GB | ~9–10 GB |
| 32B | ~64 GB | ~34 GB | ~18–20 GB |
| 70B | ~140 GB | ~70 GB | ~38–48 GB |
Invloed van KV-cache / contextlengte (vaak over het hoofd gezien). De KV-cache groeit lineair met de contextlengte en het aantal gelijktijdige verzoeken; bij lange contexten kan hij zelfs groter worden dan de modelgewichten. Voorbeeld: Llama 3.1 70B kan bij één verzoek met 128K context alleen al ~40 GB KV-cache verbruiken — en deze waarde gaat er al van uit dat het model GQA (Grouped-Query Attention) gebruikt; een klassieke (MHA-)architectuur zonder GQA zou voor hetzelfde scenario ~8× meer nodig hebben. Oplossing: de KV-cache kwantiseren naar FP8/INT8 halveert het geheugen ongeveer.
Totaal VRAM-budget. De werkelijke behoefte bestaat niet alleen uit de gewichten:
Totaal VRAM = modelgewichten + KV-cache + activaties + overhead
| Component | Berekening | Voorbeeld |
|---|---|---|
| Modelgewichten | parameters × bytes/param | 7B FP16 = 14 GB · 70B FP16 = 140 GB |
| Max. context (max_len) | bepaalt rechtstreeks de grootte van de KV-cache | 4K → 128K tokens = ~32× verschil in KV-cache |
| KV-cache | 2 × lagen × kv_heads × head_dim × max_len × batch × 2 bytes | 70B (GQA, 8 KV-heads), 4096 tokens, batch 32 ≈ 20–40 GB |
| Activaties | batch × max_len × hidden_dim × lagen | Groot bij training, klein bij inferentie |
| Overhead | ~10–20% extra | Fragmentatie, tijdelijke buffers |
Opmerking bij de formule: In GQA-modellen is
kv_headseen klein deel van het totale aantal attention-heads (bijv. Llama 3.1 70B: 64 heads → 8 KV-heads); het voorbeeld van 20–40 GB in de tabel is daarom laag. In een klassieke (MHA-)architectuur zonder GQA geldtkv_heads = aantal heads, en vraagt hetzelfde scenario ~8× meer geheugen.
Regel: Houd altijd ~20% extra VRAM als reserve aan. Om de berekening te vereenvoudigen kunt u de gratis tool gebruiken: Cordatus VRAM Calculator — https://app.cordatus.ai/#/vram-calculator
4.4. Hoe inferentie werkt en metrieken voor de servicekwaliteit
Inferentie in twee fasen — waarom zijn er twee afzonderlijke knelpunten? Een LLM-verzoek wordt in twee fasen verwerkt:
- Prefill (verwerking van de prompt): Alle tokens in de invoerprompt worden in één keer (parallel) verwerkt; zware matrixvermenigvuldigingen overheersen → rekengebonden (compute-bound; afhankelijk van FLOPS). Deze fase bepaalt de TTFT — een lange prompt = een lange TTFT.
- Decode (tokengeneratie): Het antwoord wordt token voor token, sequentieel gegenereerd; omdat elk token afhangt van het vorige (autoregressief), is dit binnen één verzoek niet te paralleliseren. Bij elke stap worden alle modelgewichten opnieuw uit het geheugen gelezen, maar de rekenlast is relatief klein → geheugengebonden (memory-bound; afhankelijk van de geheugenbandbreedte). Deze fase bepaalt de TPS. De generatie gaat door totdat een EOS-token (end-of-sequence) wordt geproduceerd of de maximale tokenlimiet is bereikt.
Daarom zijn twee verschillende hardware-eigenschappen van belang: FLOPS voor prefill/TTFT en geheugenbandbreedte voor decode/TPS. Hoewel decode binnen één verzoek niet paralleliseert, verdeelt batching het lezen van de gewichten over veel verzoeken, waardoor de totale doorvoer (throughput) toeneemt.
De hardwarekeuze wordt niet alleen bepaald door “past het model”, maar ook door “welke gebruikerservaring streven we na”. Vier kernmetrieken:
- TTFT (Time to First Token): Hoe lang na het versturen van de prompt komt het eerste token binnen? Rekengebonden — afhankelijk van FLOPS.
- TPS (Tokens Per Second): Hoeveel tokens worden er per seconde gegenereerd? Heeft rechtstreeks invloed op de gebruikerservaring. Geheugengebonden — afhankelijk van de geheugenbandbreedte.
- Doorvoer: Hoeveel verzoeken worden er per tijdseenheid verwerkt? Neemt toe naarmate de batch groeit.
- Batchgrootte — de fundamentele afweging: Grote batch → hoge doorvoer maar hoge latentie; kleine batch → lage latentie maar lage doorvoer. Het optimale punt vinden is cruciaal.
Praktische conclusie: wilt u snelle antwoorden voor één gebruiker, dan zijn hoge bandbreedte (TPS) en FLOPS (TTFT) van belang; wilt u hoge doorvoer voor meerdere gebruikers, dan moet u de batch opschalen en dus ook het VRAM (KV-cache).
Technieken die het systeem versnellen (2026). Er bestaan diverse methoden op de softwarelaag om deze twee fasen te versnellen; de meeste worden ondersteund door vLLM / SGLang / TensorRT-LLM en werken doorgaans zonder het model te wijzigen:
- Speculatieve decodering (speculative decoding): Een klein “draft”-model stelt meerdere tokens voor, en het grote model verifieert ze in één pass → 2–3× versnelling bij decode. De huidige sterkste aanpak is EAGLE-3 / EAGLE 3.1 (een lichte voorspellingskop die aan de binnenste lagen van het model is gekoppeld en geen apart draftmodel vereist) en de parallelle variant P-EAGLE.
- MTP (Multi-Token Prediction): Het model voorspelt meerdere tokens in één stap (bijv. de DeepSeek-architectuur); wordt zowel bij training als als draft bij speculatieve decodering gebruikt.
- Disaggregated prefill (scheiding van prefill en decode): Verdeelt de rekengebonden prefill en de geheugengebonden decode over aparte GPU-pools; elke fase schaalt volgens haar eigen knelpunt, wat latentie en doorvoer tegelijk verbetert (bijv. NVIDIA Dynamo).
- Continuous / in-flight batching: Voegt verzoeken dynamisch toe aan en verwijdert ze uit de batch, zodat de GPU bezig blijft → hoge doorvoer.
- Chunked prefill & prefix caching: Splitst een lange prefill op en wisselt die af met decode om de TTFT te verlagen; de KV-cache wordt hergebruikt voor gemeenschappelijke prefixen (systeemprompt) (PagedAttention / RadixAttention — zie 6.A).
- Kwantisatie van de KV-cache (FP8/INT8): Verlaagt de geheugenbelasting van decode (zie 4.3).
Met de juiste inferentie-engine en configuratie kunnen deze technieken in productieomgevingen een verschil van 2–4× in snelheid/doorvoer opleveren — de softwareconfiguratie is net zo belangrijk als de hardware.
4.5. Hardwareklassen (Aetherix-catalogus)
We hebben de hardwareaanbevelingen in deze handleiding beperkt tot de NVIDIA-producten die wij als Aetherix leveren. Consumentenkaarten uit de GeForce-reeks (RTX 3090/4090/5090) voeren wij niet; in plaats daarvan leveren wij professionele werkstations (RTX PRO Blackwell), datacenter-GPU’s, DGX-systemen en Jetson-edgemodules. De doorslaggevende maatstaf is ook hier VRAM; de klassen hieronder zijn ingedeeld naar VRAM en toepassing.
Waarom raden we consumenten-GPU’s (gaming-GPU’s) niet aan? Een RTX 4090/5090 draait op hobby- of individueel niveau zeker LLM’s; voor zakelijk gebruik, productie en 24/7-gebruik is de professionele/datacenterklasse echter nodig, om de volgende concrete redenen:
- Laag VRAM-plafond. De beste consumentenkaart (RTX 5090) blijft steken op ~32 GB; onvoldoende voor grote modellen, lange contexten en de KV-cache. De RTX PRO 6000 biedt 96 GB en de H200 141 GB.
- Geen ECC-geheugen. Consumentenkaarten missen foutcorrigerend (ECC-)geheugen; bij langdurig/continu gebruik bestaat het risico op stille geheugenfouten. Professionele kaarten en datacenterkaarten zijn voorzien van ECC.
- Beperking door driver/licentie. De licentie van NVIDIA’s GeForce-driver beperkt het gebruik in datacenters; een zakelijke/DC-deployment vereist officieel professionele kaarten of datacenterkaarten.
- Beperkte multi-GPU-schaalbaarheid. NVLink is van nieuwe consumentenkaarten verwijderd; snelle verbindingen tussen GPU’s en serverdichtheid zijn voorbehouden aan de professionele/DC-reeks (zie 4.6).
- Koeling & vormfactor. Consumentenkaarten zijn niet geschikt voor de luchtstroom in servers en zijn niet ontworpen voor langdurige volle belasting; datacenterkaarten werken met passieve koeling die in het serverchassis is geïntegreerd (zie 4.9).
- Garantie & duurzaamheid. Professionele kaarten worden geleverd met zakelijke garantie, een lange levensduur en stabiele driverondersteuning; consumentenkaarten bieden deze garanties niet voor productieworkloads.
Kortom: consumentenkaarten “werken”, maar voor een betrouwbare, schaalbare en conforme zakelijke infrastructuur voor lokale LLM’s is de professionele/datacenterklasse de juiste keuze. De Aetherix-catalogus is daarom tot deze klassen beperkt.
Opmerking over prijzen: Deze producten worden doorgaans op offerte-/projectbasis aangeboden en de prijzen variëren; in deze handleiding vermelden we bewust geen prijzen. Neem voor actuele prijzen en beschikbaarheid contact met ons op. De vermogenswaarden (W) hieronder zijn de referentie-TDP’s van NVIDIA.
A) Jetson — lokale AI aan de edge / embedded / in robotica. Voor het draaien van kleine/middelgrote modellen in het veld of op het apparaat zelf, zonder dat internet nodig is. Gebruikt unified memory (CPU en GPU delen dezelfde pool).
- Jetson Orin Nano (4 GB / 8 GB) — instapniveau; kleine modellen van de 1–4B-klasse, assistenten voor beeld en spraak. Zeer laag vermogen.
- Jetson AGX Orin (64 GB) — serieus werk aan de edge; met 64 GB unified memory middelgrote modellen en multimodale workloads.
- Jetson AGX Thor / T5000 (128 GB-klasse, Blackwell-generatie) — het vlaggenschip van de volgende generatie voor physical AI en robotica; grote modellen en gelijktijdige workloads aan de edge. De optie met het “meeste geheugen” aan de edgekant.
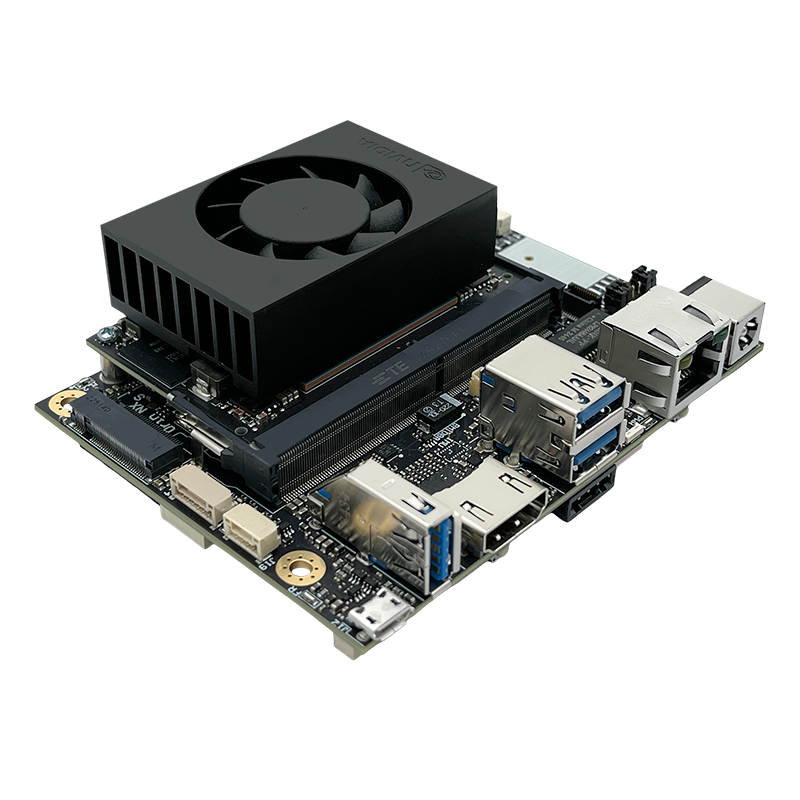
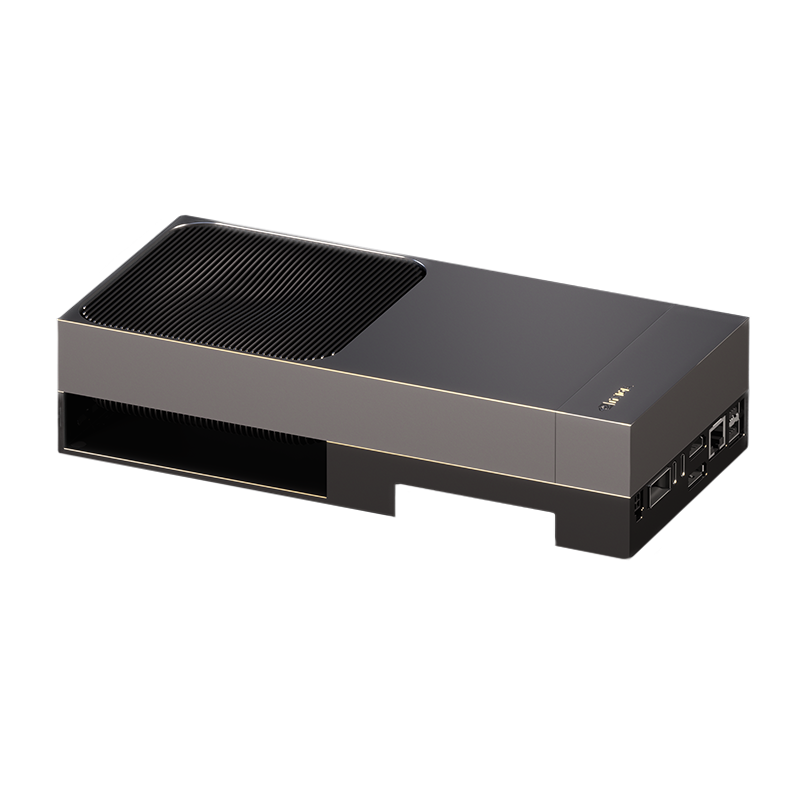
Jetson Orin Nano AI-kit en Jetson AGX Thor Developer Kit
B) RTX PRO Blackwell — werkstation-/server-GPU (de hoofdklasse voor lokale LLM’s). ECC-GDDR7, past in een desktopwerkstation of server. Deze reeks vervangt de consumentenkaarten.
- RTX PRO 2000 Blackwell — 16 GB. Instap; ruim voldoende voor 7B–14B (Q4). Zeer laag vermogen (~70 W), geschikt voor een kleine vormfactor.
- RTX PRO 4000 Blackwell — 24 GB (ook in een SFF-/compacte variant). Optimale instap: 14B ruim, 32B in Q4. ~140 W.
- RTX PRO 4500 Blackwell — 32 GB. Draait 32B ruim; 70B past niet op deze kaart (zie PRO 6000). ~200 W.
- RTX PRO 5000 Blackwell — 48 GB. 32B ruim met lange context; 70B in Q4 alleen met korte context, op de grens (70B Q4 ≈ 38–48 GB — zie 4.3; voor 70B met ruimte gebruikt u de PRO 6000). ~300 W.
- RTX PRO 6000 Blackwell — 96 GB (drie uitvoeringen: Workstation, Max-Q Workstation, Server). Op één kaart 70B in FP16/8-bit of zeer grote contexten. Workstation/Server ~600 W; Max-Q met ~300 W is de efficiënte keuze voor omgevingen met beperkingen in vermogen/warmte. Het “single-card”-vlaggenschip voor lokale LLM’s.
Als kant-en-klaar werkstation (Aetherix): We leveren deze GPU’s niet alleen als losse kaarten, maar ook als vooraf geïnstalleerde en geteste complete werkstations (RTX PRO 4000 / 4500 / 5000 / 6000 Workstation en Max-Q). De systemen worden geleverd met een CPU uit de Intel Core i9-14900KF-klasse; Ubuntu + een geoptimaliseerde NVIDIA-softwarestack vooraf geïnstalleerd, na het doorstaan van prestatie- en temperatuurtests, en met 2 jaar garantie — dat wil zeggen “werkt direct uit de doos” voor lokale LLM’s. Details: aetherix.com/product-category/graphics-cards.
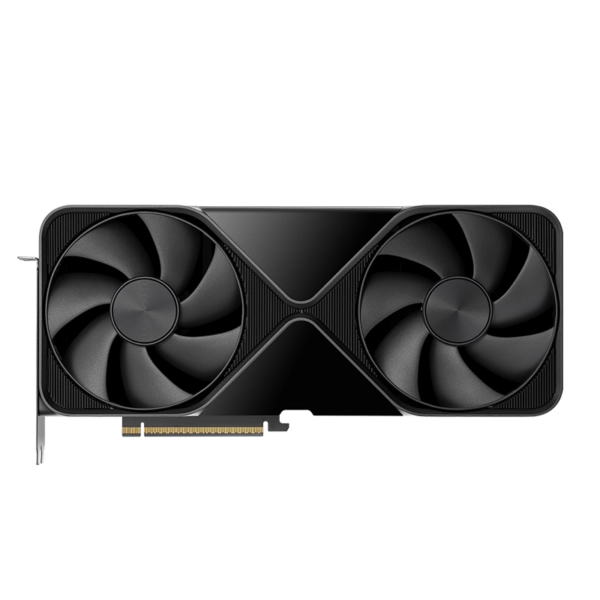
NVIDIA RTX PRO 6000 Blackwell Workstation Edition — 96 GB
C) Datacenter-GPU’s (één / enkele) — productiedienst met hoog volume en meerdere gebruikers. Passief gekoelde kaarten voor montage in servers; voor veel gelijktijdige verzoeken met vLLM/TensorRT-LLM. Anders dan de B200/B300 kunnen ze afzonderlijk worden verkocht (of met 2–8 per server).
- NVIDIA L4 — 24 GB. Inferentiekaart met laag vermogen (~72 W); een efficiënte basis voor het serveren van kleine/middelgrote modellen.
- NVIDIA L40 / L40S — 48 GB. Veelzijdig voor inferentie + fine-tuning; serveert middelgrote modellen met hoge doorvoer (één kaart is niet genoeg voor 70B — zie “veelgemaakte fouten”, paragraaf 8; de 70B-klasse vereist een H100/H200 of 2× kaarten).
- NVIDIA H100 NVL — 94 GB en H200 NVL — 141 GB. Het hoogste niveau dat als losse kaart wordt verkocht; grote MoE-modellen, lange context, intensieve gelijktijdigheid. De 141 GB van de H200 biedt de hoogste modelcapaciteit op één kaart.
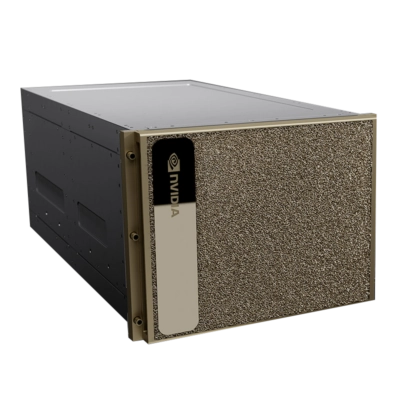
NVIDIA DGX/HGX-serverinfrastructuur van datacenterklasse
D) Blackwell-topklasse — kant-en-klare datacentersystemen (HGX / DGX, team van 8 GPU’s). Voor volledige training en inferentie met veel verkeer (500+ gelijktijdige gebruikers). Deze klasse wordt niet als losse kaarten verkocht; ze komt als een vooraf geïnstalleerde, bekabelde en gekoelde server/rack met 8 GPU’s — budget en infrastructuur moeten daarop worden afgestemd.
- NVIDIA B200 — 192 GB HBM3e, 8 TB/s. Blackwell-generatie; clustertraining en hoge doorvoer.
- NVIDIA B300 — 288 GB HBM3e, 8 TB/s. Blackwell Ultra; voor het trainen en serveren van de grootste modellen (405B+) met NVFP4.
- Kant-en-klare systemen — NVIDIA DGX B200 / DGX B300. Servers van NVIDIA uit de klasse “AI-fabriek” met 8 van de bovenstaande GPU’s; het hoogste niveau voor training + inferentie op bedrijfsschaal. (DGX = het kant-en-klare systeem van NVIDIA; HGX = de vorm waarin hetzelfde blok van 8 GPU’s in servers van OEM’s wordt geïntegreerd.)
E) DGX Spark — desktop-“AI-mini-pc” (een klasse apart).
Belangrijk — let op de naamsverwarring: Hoewel DGX Spark “DGX” in de naam draagt, behoort het niet tot dezelfde familie/klasse als de rackgemonteerde DGX/HGX-servers onder (D) hierboven. Het is een op zichzelf staande, handpalmgrote desktop-mini-pc die u gewoon aansluit. “DGX” is hier alleen NVIDIA’s merknaam voor AI-apparaten voor de desktop; hardwareklasse, geheugenbandbreedte en toepassing verschillen volledig van de B200/B300-datacentersystemen.
- NVIDIA DGX Spark (GB10 Grace-Blackwell) — 128 GB unified memory, 1 PetaFLOP AI, slechts 240 W, 150×150×50 mm / 1.2 kg. Een desktop-“AI-supercomputer”; houdt modellen tot ~200B in het geheugen en kan 70B fine-tunen. Belangrijkste beperking: de geheugenbandbreedte is relatief laag (~273 GB/s) → het genereren van tokens voor één stream is trager dan wanneer hetzelfde model op een H200 draait. De echte kracht: zeer grote modellen compact en met laag vermogen in het geheugen houden, voor lokale ontwikkeling/tests en stapsgewijze groei. Geen vereiste van een team van 8 GPU’s — kan net als een mini-pc stuk voor stuk worden aangeschaft en opgeschaald. Schaalt zonder switch met QSFP-kabels:
- 1× Spark — 128 GB, fine-tune van 70B / inferentie van 200B, 3–5 gelijktijdige gebruikers, lokale tests.
- 2× Spark (ConnectX-7 QSFP, directe verbinding van 200 Gbps) — 256 GB, inferentie van 405B, middelgroot team.
- 3× Spark (ringtopologie) — 384 GB, fine-tune van 405B+ / hoge doorvoer, geen switch nodig.
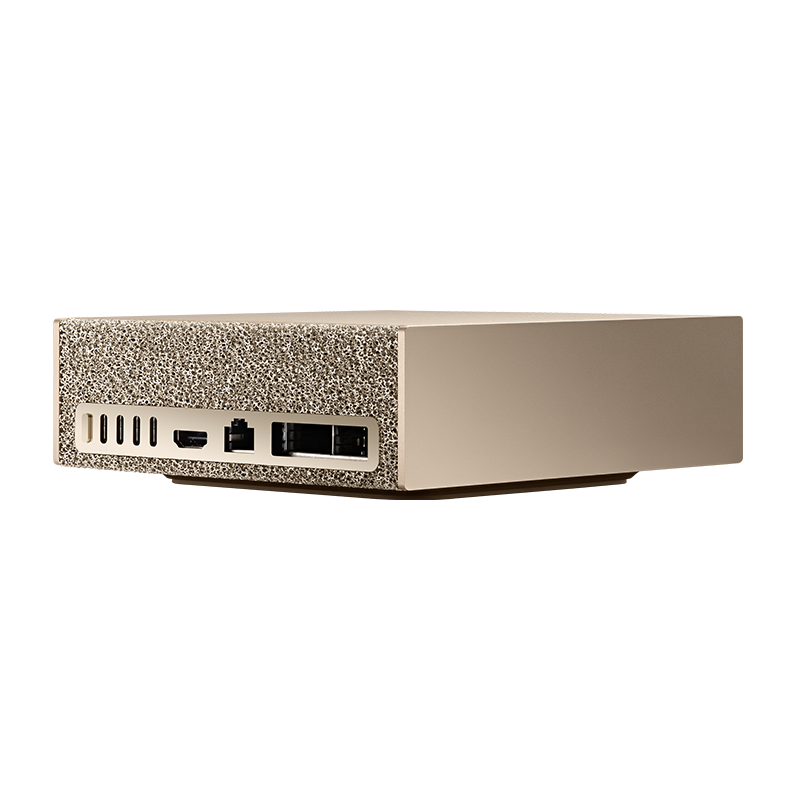
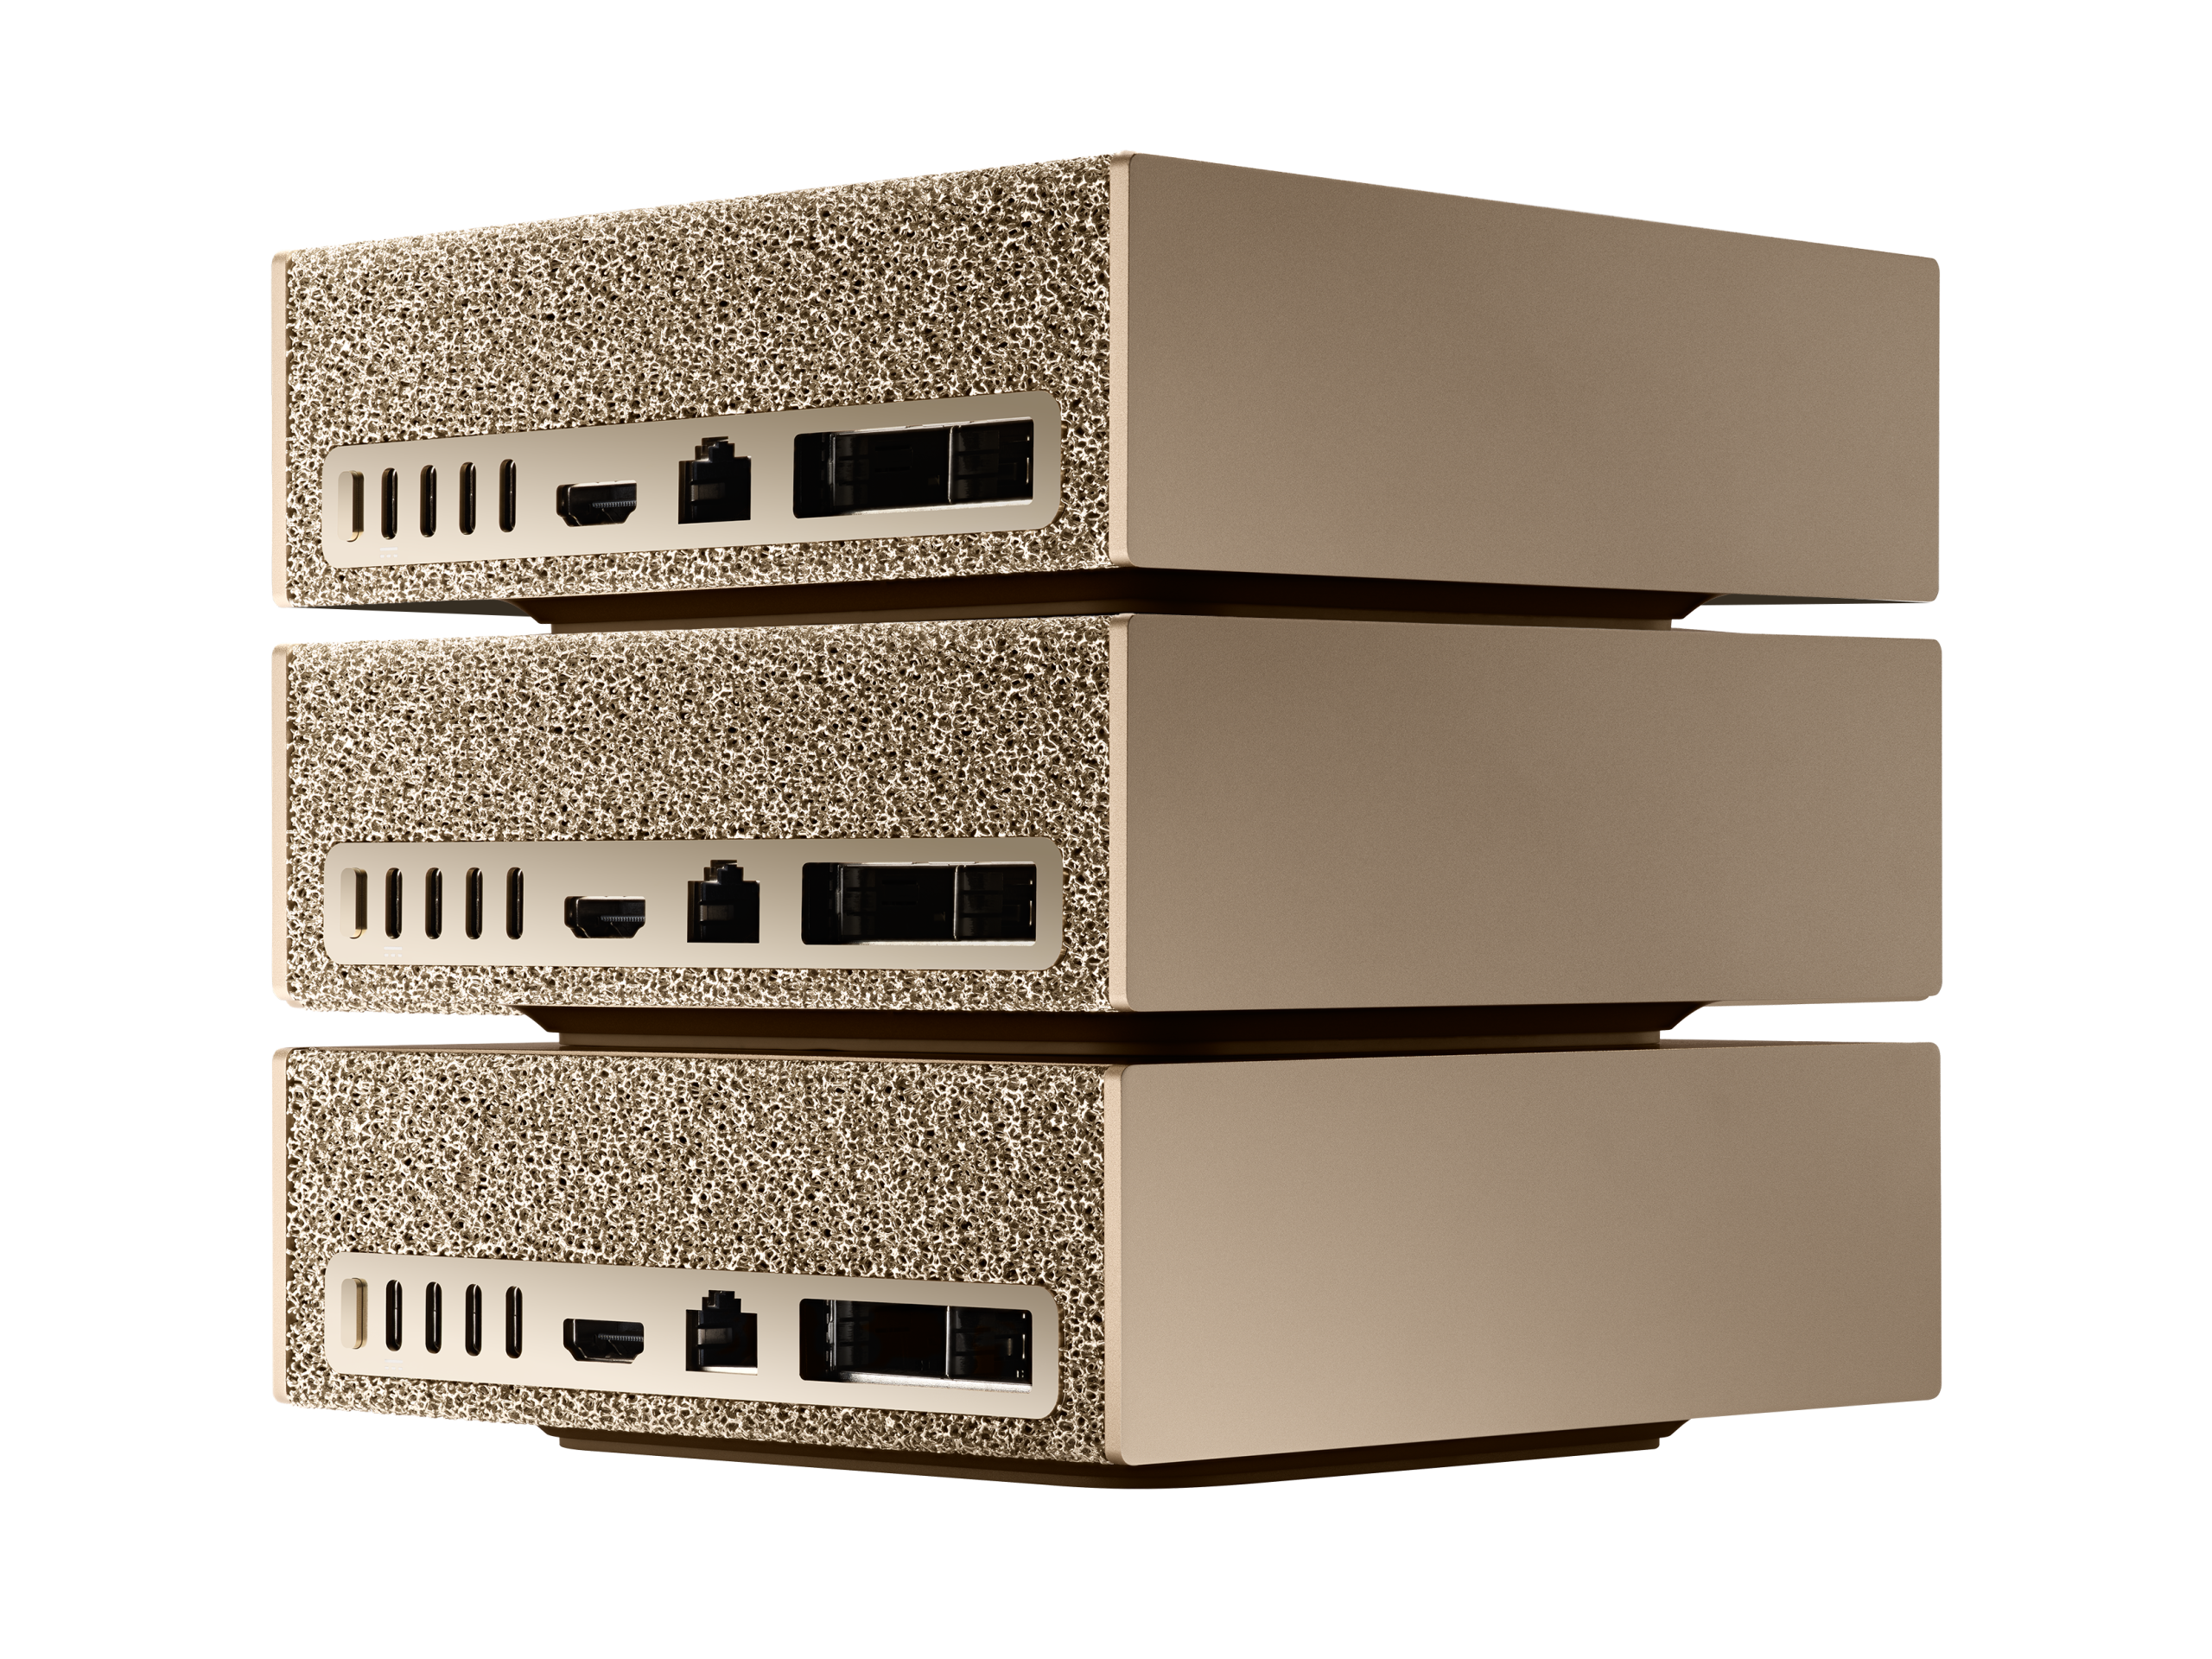
NVIDIA DGX Spark (128 GB, 240 W) en een 3× ringtopologie die een pool van 384 GB oplevert
GPU-vergelijkingsmatrix (2026). De belangrijkste LLM-opties van Aetherix:
| Model | Architectuur | VRAM | FP16/BF16 (sparse) | FP8 (sparse) | FP4 (sparse) | Geheugen-BW | Verkoopeenheid |
|---|---|---|---|---|---|---|---|
| B300 288GB | Blackwell Ultra | 288 GB HBM3e | 4,500 TFLOPS | 9,000 TFLOPS | 30,000 TFLOPS (15 PFLOPS dense) | 8 TB/s | Team van 8 GPU’s |
| B200 192GB | Blackwell | 192 GB HBM3e | 4,500 TFLOPS | 9,000 TFLOPS | 18,000 TFLOPS | 8 TB/s | Team van 8 GPU’s |
| H200 141GB | Hopper | 141 GB HBM3e | 1,979 TFLOPS | 3,958 TFLOPS | — | 4.8 TB/s | Los (2–8/server) |
| DGX Spark (GB10) | Grace Blackwell | 128 GB LPDDR5x (unified) | — | — | 1,000 AI TOPS | 273 GB/s | Los (desktop) |
| RTX PRO 6000 Blackwell | Blackwell | 96 GB GDDR7 | ~1,000 TFLOPS | ~2,000 TFLOPS | 4,000 AI TOPS | 1.79 TB/s | Los (werkstation) |
| L40S 48GB | Ada Lovelace | 48 GB GDDR6 | 362 TFLOPS | 733 TFLOPS | — | 864 GB/s | Los (server) |
De waarden komen uit de officiële datasheets van NVIDIA (2:4-sparsity / “with sparsity”). De echte sprong van de B300 ten opzichte van de B200 zit in het geheugen (192→288 GB) en in NVFP4 (FP4 ~67% hoger: 15 PFLOPS dense / ~30,000 TFLOPS sparse); FP8/FP16 zijn vergelijkbaar met de B200 en de bandbreedte is bij beide 8 TB/s. Voor de RTX PRO 6000 noemt NVIDIA “up to 4 PFLOPS FP4 (4,000 AI TOPS), 2 PFLOPS FP8, 1 PFLOP FP16”.
DGX Spark — voorbeeldsnelheden (decode-benchmark met vLLM). Dankzij unified memory draaien enorme modellen op een op zichzelf staand desktopapparaat:
| Model | Grootte | Kwantisatie | Configuratie | Tok/s (decode) |
|---|---|---|---|---|
| gpt-oss-120b | 120B | MXFP4 | 1× DGX Spark | 54.72 |
| gpt-oss-120b | 120B | MXFP4 | 2× DGX Spark | 101.36 |
| gpt-oss-120b | 120B | MXFP4 | 4× DGX Spark | 106.31 |
| MiniMax-M2.7 | 229B | NVFP4 | 2× DGX Spark | 26.00 |
| Qwen3.5-397B-A17B | 397B | INT4 AutoRound | 3× DGX Spark (ring) | 17.05 |
Professionele kaarten van de vorige generatie (RTX 6000 Ada 48 GB, RTX A6000 48 GB) staan ook in de catalogus; het zijn alternatieven met 48 GB voor situaties waarin budget of beschikbaarheid meespeelt, maar bij nieuwe aankopen verdient de Blackwell-generatie (RTX PRO 5000/6000) de voorkeur.
4.6. Multi-GPU
Wanneer het VRAM van één kaart onvoldoende is voor het beoogde model, worden meerdere kaarten samengevoegd (bijv. 2× RTX PRO 5000 = 96 GB, of 2× RTX PRO 6000 = 192 GB). De reden: 70B+ en grote MoE-modellen met hoge precisie / lange context draaien. Professionele kaarten en datacenterkaarten zijn ontworpen voor multi-GPU-schaling; de workload wordt verdeeld via tensorparallellisme (tensor parallelism) (elke laag wordt over de kaarten opgesplitst, vereist hoge bandbreedte) of pipelineparallellisme (pipeline parallelism) (de lagen worden over de kaarten verdeeld, weinig verkeer tussen de kaarten). vLLM en TensorRT-LLM ondersteunen beide. Bij opstellingen met meerdere nodes mogen knelpunten in de InfiniBand-/Ethernet-bandbreedte en in PCIe niet over het hoofd worden gezien.
4.7. Alleen CPU + RAM
Geschikt voor een instap, kleine/gekwantiseerde modellen en batch-/niet-interactief werk (bijv. het samenvatten van documenten); niet voor vloeiend chatten. Het knelpunt is niet de rekenkracht, maar de geheugenbandbreedte. Een typische desktop-CPU met 8 cores haalt ~5–15 tok/s op een 7B-model; grote modellen zakken naar enkele cijfers. Een model dat in het VRAM past, is ruwweg ~10× sneller dan een model dat naar het RAM is overgelopen. llama.cpp kan een deel van de lagen op de GPU houden en de rest naar het RAM offloaden — goed als tijdelijke oplossing, niet voor productiesnelheid.
4.8. Koppeling van scenario aan hardware
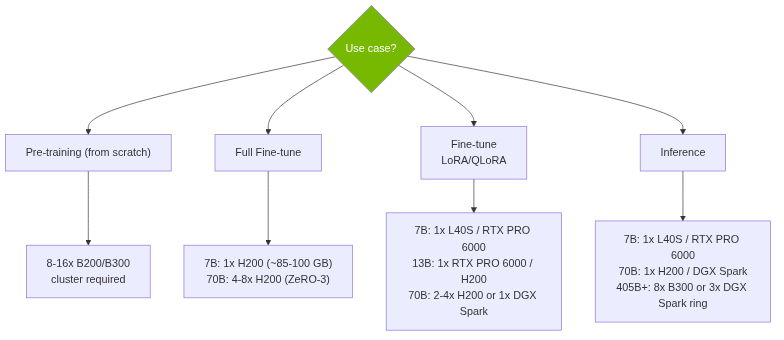
Figuur: Beslisboom voor de GPU-keuze
Algemene koppeling (van edge tot enterprise):
| Behoefte | Doel-VRAM | Aetherix-hardware |
|---|---|---|
| Edge / embedded / robotica | unified 8–128 GB | Jetson Orin Nano (8 GB) → AGX Orin (64 GB) → AGX Thor / T5000 (128 GB) |
| Instapwerkstation (7–14B) | 16–24 GB | RTX PRO 2000 (16 GB) of RTX PRO 4000 (24 GB) |
| Midden (14–32B ruim) | 32–48 GB | RTX PRO 4500 (32 GB) of RTX PRO 5000 (48 GB) |
| Hoog / 70B op één kaart | 96 GB | RTX PRO 6000 (96 GB) — Max-Q-uitvoering bij beperkt vermogen |
| Productiedienst voor meerdere gebruikers | 24–141 GB | L4 / L40S → H100 NVL (94 GB) → H200 NVL (141 GB) |
| Zeer groot model / kant-en-klaar | 128 GB+ | DGX Spark (128 GB) / 2–3× ring, op bedrijfsschaal DGX B300 |
| Fine-tune (LoRA/QLoRA) | laag–gemiddeld | 7B: 1× L40S / RTX PRO 6000 · 70B: 1× DGX Spark (QLoRA) / 2–4× H200 (LoRA) |
| Full fine-tune | ~12–14× params | 7B: 1× H200 (~85–100 GB) · 70B: 4–8× H200 (ZeRO-3, ~1 TB) |
| Pre-training (vanaf nul) | ~16× params | 8× B200 / 8–16× B300 (team van 8 GPU’s — zie 4.5/D) |
Inferentiescenario’s (modelgrootte × gebruikerscapaciteit):
| Model (precisie) | Min. VRAM | Aanbevolen GPU | Gelijktijdige capaciteit |
|---|---|---|---|
| 7B (FP16) | ~14 GB | 1× L40S of RTX PRO 6000 | 50+ |
| 13B (FP16) | ~26 GB | 1× RTX PRO 6000 96GB | 30+ |
| 70B (FP16) | ~140 GB | 2× H200 (één H200 laat geen ruimte voor KV-cache + 20% reserve) | 20–100 |
| 70B (INT8) | ~70 GB | 1× H200 · 1× DGX Spark | 30–100 (H200) · ~3–5 (Spark) |
| 405B (FP16) | ~810 GB | 8× B300 | 10–50 |
| 405B (INT4) | ~200–230 GB | 3× DGX Spark (ring, 384 GB) | ~3–10 (ring) |
| 70B-inferentie (veel verkeer, 500+) | — | 8× B200 (1 team) | cluster nodig voor de doorvoer |
Opmerking: De kolom “Min. VRAM” is de ruwe geheugenvoetafdruk van het model bij de genoemde precisie; daar komen KV-cache + ~20% reserve bij (zie 4.3) — daarom past 70B FP16 niet op één kaart van 141 GB en is 2× H200 nodig. Op DGX Spark (128 GB) en in ringconfiguraties draaien zeer grote modellen gekwantiseerd (INT8/INT4). Omdat de geheugenbandbreedte van DGX Spark relatief laag is (273 GB/s), is het geschikt voor één / enkele gelijktijdige gebruikers (~3–5); hoge gelijktijdigheid vereist H200/B-serie.
4.9. Operationele kosten en totale eigendomskosten (TCO)
- Vermogen (referentie-TDP): RTX PRO 2000 ≈ 70 W · PRO 4000 ≈ 140 W · PRO 4500 ≈ 200 W · PRO 5000 ≈ 300 W · PRO 6000 Workstation/Server ≈ 600 W (Max-Q ≈ 300 W) · L4 ≈ 72 W · L40S ≈ 350 W · H200 NVL ≈ 600 W · DGX Spark slechts 240 W · server met 8× B200 ~15 kW. Jetson-modules zitten in de tientallen watts, zeer laag.
- Voor kantooromgevingen met beperkingen in vermogen/warmte bieden Max-Q-uitvoeringen, kaarten met een lage TDP (PRO 2000/4000, L4) en DGX Spark een duidelijk voordeel.
- Koeling: Werkstationkaarten hebben hun eigen ventilatoren; datacenterkaarten (L40S, H100/H200 NVL) zijn passief en werken alleen in een server/chassis met een goede luchtstroom — ze kunnen niet in een desktopbehuizing worden ingebouwd. Voor multi-GPU en 24/7-productie is koeling van serverklasse verplicht.
- TCO — aankoopprijs ≠ totale kosten. De aankoopprijs van de GPU is slechts 30–40% van de totale eigendomskosten; de overige 60–70% bestaat uit elektriciteit, koeling, netwerk, onderhoud, datacenter en personeel. In grote clusters kunnen de koelkosten de elektriciteitskosten benaderen; bij meerdere nodes moeten ook de kosten van InfiniBand-switches en bekabeling worden meegerekend. Een goed gedimensioneerde oplossing met laag vermogen (bijv. DGX Spark) biedt vaak een lagere TCO.
5. Modelkeuze
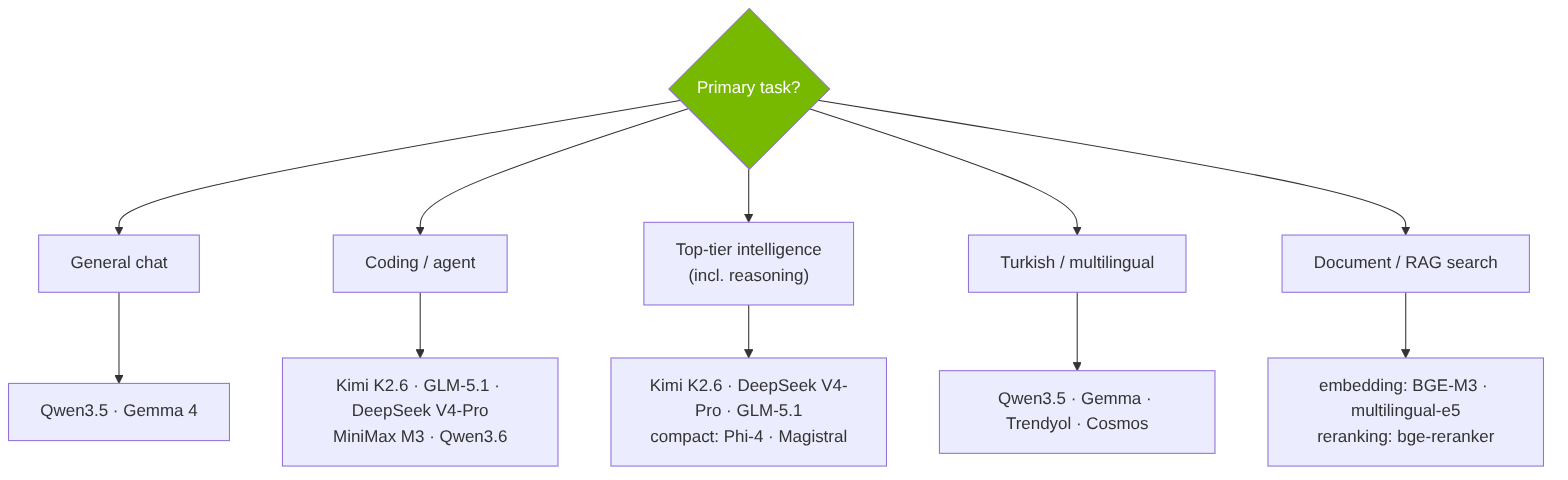
Figuur: Modelkeuze per taak
Balans tussen grootte en kosten: voor de meeste lokale workloads zijn 7–14B dense of ~30B MoE (~3B actief) de optimale balans; de zwaarste taken vereisen 70B+ / grote MoE-modellen.
5.1. Wat kunt u met een lokale LLM doen? (toepassingen van inferentie)
Voordat u een model kiest, moet “welke taak ga ik uitvoeren?” duidelijk zijn — de taak bepaalt zowel het model als de hardware. Voor de meeste organisaties is het startpunt inferentie, niet training (zie 4.2), en RAG is daar slechts één van. Het is praktisch om de toepassingen in twee groepen te verdelen:
Interactief (lage latentie is belangrijk — TPS/TTFT doorslaggevend):
- Chat / assistent — algemene vraag en antwoord, zakelijke/persoonlijke assistent
- RAG / vraag en antwoord over documenten — met uw eigen documenten (slechts één van de toepassingen)
- Codeondersteuning — IDE-assistent, code genereren/uitleggen/reviewen, tests genereren
- Agents & automatisering (agentisch) — tool calling, e-mailtriage, agenda, workflows met meerdere stappen
- Vertaling — gerubriceerde documenten lokaal vertalen zonder ze bloot te stellen
Batch / niet-interactief (batch — latentie irrelevant; kleine/goedkope hardware volstaat, zie 4.7):
- Samenvatten — vergaderingen, contracten, lange rapporten, stapels e-mail
- Informatie-extractie — factuur/contract/formulier → gestructureerde JSON, NER
- Classificatie / routering — triage van verzoeken, sentimentanalyse, contentmoderatie, detectie van persoonsgegevens (PII)
- Semantisch zoeken / aanbevelen / clusteren — met embeddingmodellen
- Synthetische / gelabelde data genereren — datavoorbereiding voor fine-tuning
- Multimodaal — analyse van documenten met OCR, visuele vraag en antwoord, audiotranscriptie + LLM
- Guardrail / controle — de uitvoer van een ander model controleren, PII maskeren
Praktische conclusie: Omdat batchtaken ongevoelig zijn voor latentie, verlagen ze de hardwarevereisten — dezelfde organisatie kan archiefsamenvatting op een kleine kaart en live chat op een grote kaart draaien. Uw taakprofiel bepaalt samen de hardwareklasse in §4 en de modelkeuze hieronder.
5.2. Criteria voor de modelkeuze
Het juiste model is niet “het model met de hoogste benchmarkscore”, maar het model dat het best past bij uw taak + hardware + randvoorwaarden. Weeg de onderstaande criteria naar de prioriteiten van uw taak:
| Criterium | Te stellen vraag |
|---|---|
| Geschiktheid voor de taak | Chat, code, redeneren of extractie? |
| Grootte / VRAM-budget | Past het op de hardware? Bij MoE bepalen de totale parameters het geheugen (alle experts worden in het VRAM geladen); de actieve parameters bepalen alleen de snelheid |
| Contextlengte | Hoeveel tokens zijn nodig? (Bepaalt de belasting van de KV-cache — zie 4.3) |
| Prestaties in het Turks / de doeltaal | Niet de algemene score, maar Turkse benchmarks (zie 5.6) |
| Licentie | Is commercieel gebruik toegestaan? (zie 5.7) |
| Architectuur | Dense vs MoE — afweging tussen snelheid en geheugen |
| Kwantiseerbaarheid | Is het kwaliteitsverlies van Q4/AWQ acceptabel? Zijn GGUF/AWQ beschikbaar? |
| Betrouwbaarheid van tool calling / JSON | Cruciaal voor agents & gestructureerde uitvoer (kleine modellen hebben hier moeite mee) |
| Multimodaliteit | Zijn beeld/audio nodig? |
| Fine-tunebaarheid | Zijn het basismodel + ecosysteem (Unsloth/Axolotl) beschikbaar? |
| Ecosysteem / onderhoud | Zijn er kant-en-klare quants, varianten en actieve ontwikkeling? |
De criteria worden per taak gewogen: bij een code-assistent springen tool calling + SWE-bench eruit; bij de verwerking van overheids-/juridische documenten zijn prestaties in het Turks + licentie + nauwkeurigheid van bronvermeldingen doorslaggevend. Valideer de keuze met uw eigen gebruik, niet met één enkel “toonaangevend model” (zie 5.9).
5.3. Actuele families van open-weight modellen (medio 2026)
Opmerking: In 2026 is het momentum duidelijk verschoven naar Chinese labs met open-weight modellen (Qwen, DeepSeek, GLM, Kimi, MiniMax). De meeste nieuwe modellen gebruiken de MoE-architectuur (Mixture-of-Experts): het totale aantal parameters is groot, maar bij elke stap draait slechts een klein “actief” deel → de kwaliteit van een groot model tegen de operationele kosten van een klein model.
- Qwen (Alibaba) — de meest actieve familie. Qwen3-235B-A22B (235B totaal / 22B actief, Apache 2.0). In februari 2026 de Qwen3.5-serie (vlaggenschip Qwen3.5-397B-A17B, ~1M context; daarnaast dense varianten van 0.8B–27B en MoE-varianten 35B-A3B / 122B-A10B). Het nieuwere Qwen3.6-35B-A3B kan bij coderen wedijveren met het oudere 397B. 100–200+ talen.
- DeepSeek — In april 2026 DeepSeek V4 (MIT): V4-Pro (1.6T / 49B actief, 1M context) en V4-Flash (284B / 13B actief). Het oudere redeneermodel R1 en de gedistilleerde versies (1.5B–70B) worden nog steeds veel gebruikt.
- Llama (Meta) — de Llama 4-familie: Scout (109B/17B actief, 10M context), Maverick (~400B/17B actief, 1M context). Het grootste model, “Behemoth”, lijkt in de praktijk op de plank te zijn beland (niet officieel bevestigd). De licentie is restrictief (zie 5.7).
- Google Gemma — Gemma 4: E2B (telefoon), E4B (edge), 12B, 26B-A4B (MoE), 31B dense. 140+ talen, multimodaal (tekst+beeld) vanaf 4B.
- Mistral — Mistral Large 3 (675B/41B actief, multimodaal) en Mistral Small 4 (Apache 2.0). Het 24B-redeneermodel Magistral.
- Microsoft Phi — de Phi-4-familie (redeneermodellen van ~14B, MIT). Sterk in redeneren per parameter, ideaal voor lokaal gebruik.
- Stijgers van 2026: GLM-5.1 (Zhipu/Z.ai) (~744B/40B actief, MIT, sterk in agents/coderen), Kimi K2.6 (Moonshot) (~1T/32B actief, multimodaal, een van de beste open modellen voor coderen), MiniMax M3 (juni 2026; frontier-niveau in coderen + 1M context + multimodaliteit tegelijk), MiMo V2.5 Pro (Xiaomi) (aan de top van open-weight intelligentie). NVIDIA’s open model Nemotron 3 en Gemma 4 zijn de sterkste niet-Chinese open opties; ook de open-weight gpt-oss-serie van OpenAI draait lokaal.
5.4. Balans tussen parametergrootte en prestaties
- Klein (1–4B): In 2026 werkelijk bruikbaar — automatisch aanvullen, samenvatten, slimme antwoorden, eenvoudige vraag en antwoord, lichte codehulp. Draait op telefoons en met 6 GB VRAM.
- 7–14B dense of ~30B MoE (~3B actief): De optimale balans voor de meeste lokale workloads — chat, RAG, codeondersteuning, agenttaken. MoE-modellen als Qwen3.6-35B-A3B en Gemma 4 26B-A4B leveren een kwaliteit die dicht bij die van grote modellen ligt, tegen de kosten van een klein model.
- 70B+ / grote MoE: Voor het moeilijkste redeneerwerk, complexe agentische codeertaken met meerdere stappen, zeer lange context en de hoogste benchmarkscores. Vereist multi-GPU / veel VRAM.
5.5. Kwantisatie
- Formaten: GGUF (llama.cpp/Ollama/LM Studio; CPU+GPU; lokaal het meest gebruikt), GPTQ (GPU), AWQ (activation-aware, bij 4-bit iets beter dan GPTQ).
- Kwaliteit/bit: FP16 = volledige kwaliteit · 8-bit ≈ vrijwel verliesvrij · Q4_K_M ≈ ~92–95% van de kwaliteit · AWQ 4-bit ≈ ~95%. Bij 4-bit is het verlies voor de meeste taken ~1–2%.
- Ontwikkelingen in 2026: quants met imatrix (importance matrix) verbeteren de kwaliteit bij hetzelfde aantal bits; Unsloth Dynamic 2.0 kiest de bits per laag; hardware-native MXFP4 voor Blackwell; FP8 is gangbaar in serveropstellingen.
5.6. Keuze per taak (inclusief Turks)
- Algemene chat: Qwen3/3.5 (meertalig, Apache 2.0), Gemma 4 (multimodaal, geschikt voor de edge).
- Coderen/agents: Kimi K2.6, GLM-5.1, DeepSeek V4-Pro, MiniMax M3, Qwen3.6 (Qwen-Coder).
- Algemene intelligentie op topniveau (inclusief redeneren): In 2026 is redeneren geen aparte categorie meer. De Artificial Analysis Intelligence Index (v4.0; combineert agents + coderen + wetenschappelijk redeneren + algemene vaardigheid, https://artificialanalysis.ai) laat zien dat aan de top van de open-weight modellen dezelfde modellen voorop lopen in intelligentie, coderen en redeneren. Huidige koplopers onder de open-weight modellen: Kimi K2.6, DeepSeek V4-Pro, GLM-5.1 (alle drie statistisch gelijk), gevolgd door MiMo V2.5 Pro (Xiaomi) en Qwen3.6. De sterkste niet-Chinese open modellen: Google Gemma 4 en NVIDIA Nemotron 3. (Let op: Qwen3.7 Max/Plus zijn gesloten API-modellen, geen open-weight modellen.) Voor compact/lokaal redeneren zijn Phi-4 en Magistral 24B sterk per parameter.
- Turks / meertalig: De beste algemene meertalige open modellen zijn Qwen3/3.5 (200+ talen) en Gemma 3/4 (140+ talen). Op TurkBench scoorde Qwen3-235B-Inst 73.4 en Gemma-3-12B-TR 71.4 (grote modellen lopen consequent voorop). Specifiek Turkse modellen: ytu-ce-cosmos Turkish-Llama-8b (YTÜ, gebaseerd op Llama-3), Trendyol-LLM v4.1.0 (Qwen2.5-7B + 13B op Turkse tokens), CosmosGPT (355M–774M, uitsluitend Turks), MODA (Qwen2.5-7B met voortgezette pre-training, 2026). Turkse benchmarks: TurkishMMLU, Cetvel, TurkBench.
- Embedding- & rerankingmodellen voor RAG: De kwaliteit van RAG hangt net zoveel af van het embeddingmodel als van de LLM — wordt het verkeerde fragment opgehaald, dan kan zelfs het beste model niet correct antwoorden. Sterke open opties voor meertalig/Turks: BGE-M3, multilingual-e5, Jina embeddings v3, Nomic Embed; voor reranking de bge-reranker-klasse. Ook embeddings draaien lokaal (bijv. TEI); kies voor werk met veel Turks meertalige/Turkse versies en valideer op uw eigen documenten (zie 5.9).
5.7. Licentie (commercieel gebruik)
- Volledig vrij (Apache 2.0 / MIT): Qwen3/3.5 (Apache 2.0), DeepSeek V4 & R1 (MIT), GLM-5.1 (MIT), de open lagen van Mistral (Apache 2.0), Phi-4 (MIT). Kimi K2.6 “Modified MIT” (controleer bij zeer grote schaal de clausule over merk/naamsvermelding).
- Restrictief: Llama 4 Community License — commercieel gebruik is alleen vrij voor organisaties met minder dan 700M maandelijks actieve gebruikers; gebruikers in de EU zijn uitgesloten van de multimodale/visuele mogelijkheden. Gemma valt onder Googles eigen voorwaarden (permissief, maar geen zuivere Apache).
- Veiligste basis voor commerciële distributie: Qwen (Apache 2.0) en DeepSeek/GLM (MIT). Turkse afgeleide modellen erven de licentie van het basismodel — Trendyol v4.x → Qwen2.5, ytu-cosmos → Llama; controleer elke modelkaart afzonderlijk.
5.8. Waar vergelijkt u modellen in 2026?
- Het oorspronkelijke Hugging Face Open LLM Leaderboard is gearchiveerd (2025). Het is vervangen door aggregator- en arenasites.
- LMArena (voorheen Chatbot Arena/LMSys) — Elo op basis van blinde A/B-stemmen; het beste signaal voor voorkeuren in de praktijk.
- llm-stats.com — 300+ modellen; samengestelde score (GPQA, SWE-Bench Verified, coding-arena, prijs).
- Artificial Analysis — Intelligence Index (v4.0) — een samengestelde score die agents + coderen + wetenschappelijk redeneren + algemene vaardigheid combineert; zet open-weight en gesloten modellen naast elkaar. Het is de meest praktische bron voor een overzicht in één oogopslag bij de keuze van een open model. https://artificialanalysis.ai
- Belangrijke benchmarks: voor agentisch coderen SWE-Bench Pro & Verified / Terminal-Bench; voor redeneren/wetenschap GPQA Diamond / Humanity’s Last Exam; oudere academische benchmarks (MMLU-Pro, AIME, MATH-500) zijn grotendeels verzadigd en maken nu minder onderscheid; voor Turks TurkishMMLU / Cetvel / TurkBench.
5.9. Stel uw eigen evaluatieset (benchmarkset) samen
De algemene ranglijsten in §5.8 zijn een goed startsignaal, maar weerspiegelen uw werkelijkheid niet: uw taal, uw domein, uw documenten en de door u gekozen kwantisatie leveren andere resultaten op; bovendien dragen populaire benchmarks het risico van datacontaminatie (het model heeft de testvragen tijdens de training gezien). De betrouwbaarste beslissing komt uit een kleine, organisatiespecifieke evaluatieset.
- Data: Verzamel 50–200 representatieve voorbeelden uit het werkelijke gebruik (invoer + ideale uitvoer of acceptatiecriteria).
- Methode (per taak):
- Informatie-extractie / classificatie → automatische scoring (exact-match / regex)
- Open vragen / chat → LLM-as-judge (met een groter model, rubric) + menselijke vergelijking naast elkaar
- RAG → recall@k van het ophalen + nauwkeurigheid van bronvermelding/getrouwheid
- Meet niet alleen de kwaliteit: op uw eigen hardware ook TPS/TTFT, gelijktijdige capaciteit, lekken van persoonsgegevens (PII) / percentage onnodige weigeringen.
- Proces: vergelijk kandidaten op dezelfde set → test ook de kwantisatieniveaus (kwaliteitsverlies Q4 vs Q8) → draai dezelfde set opnieuw als regressietest bij updates van model/versie.
- Tools: lm-evaluation-harness, promptfoo, RAGAS / DeepEval voor RAG, Langfuse voor monitoring.
PoC-lus: begin klein → meet op uw eigen set → schaal hardware en model op naarmate de behoeften duidelijker worden. De beslissing over het “juiste model” wordt met deze lus genomen, niet met een marketingscore.
6. Softwarekeuze
Het is het verstandigst om de softwarelaag in zeven categorieën te bekijken: (A) inferentie-engines (de backend die het model daadwerkelijk draait), (B) alles-in-één desktopapplicaties, (C) self-hosted AI-werkruimtes van de nieuwe generatie, (D) klassieke web-UI’s en RAG-oplossingen, (E) API-gateways / routering (de laag vóór opstellingen met meerdere modellen en meerdere gebruikers), (F) tools voor fine-tuning & training en (G) code-assistenten & agents.
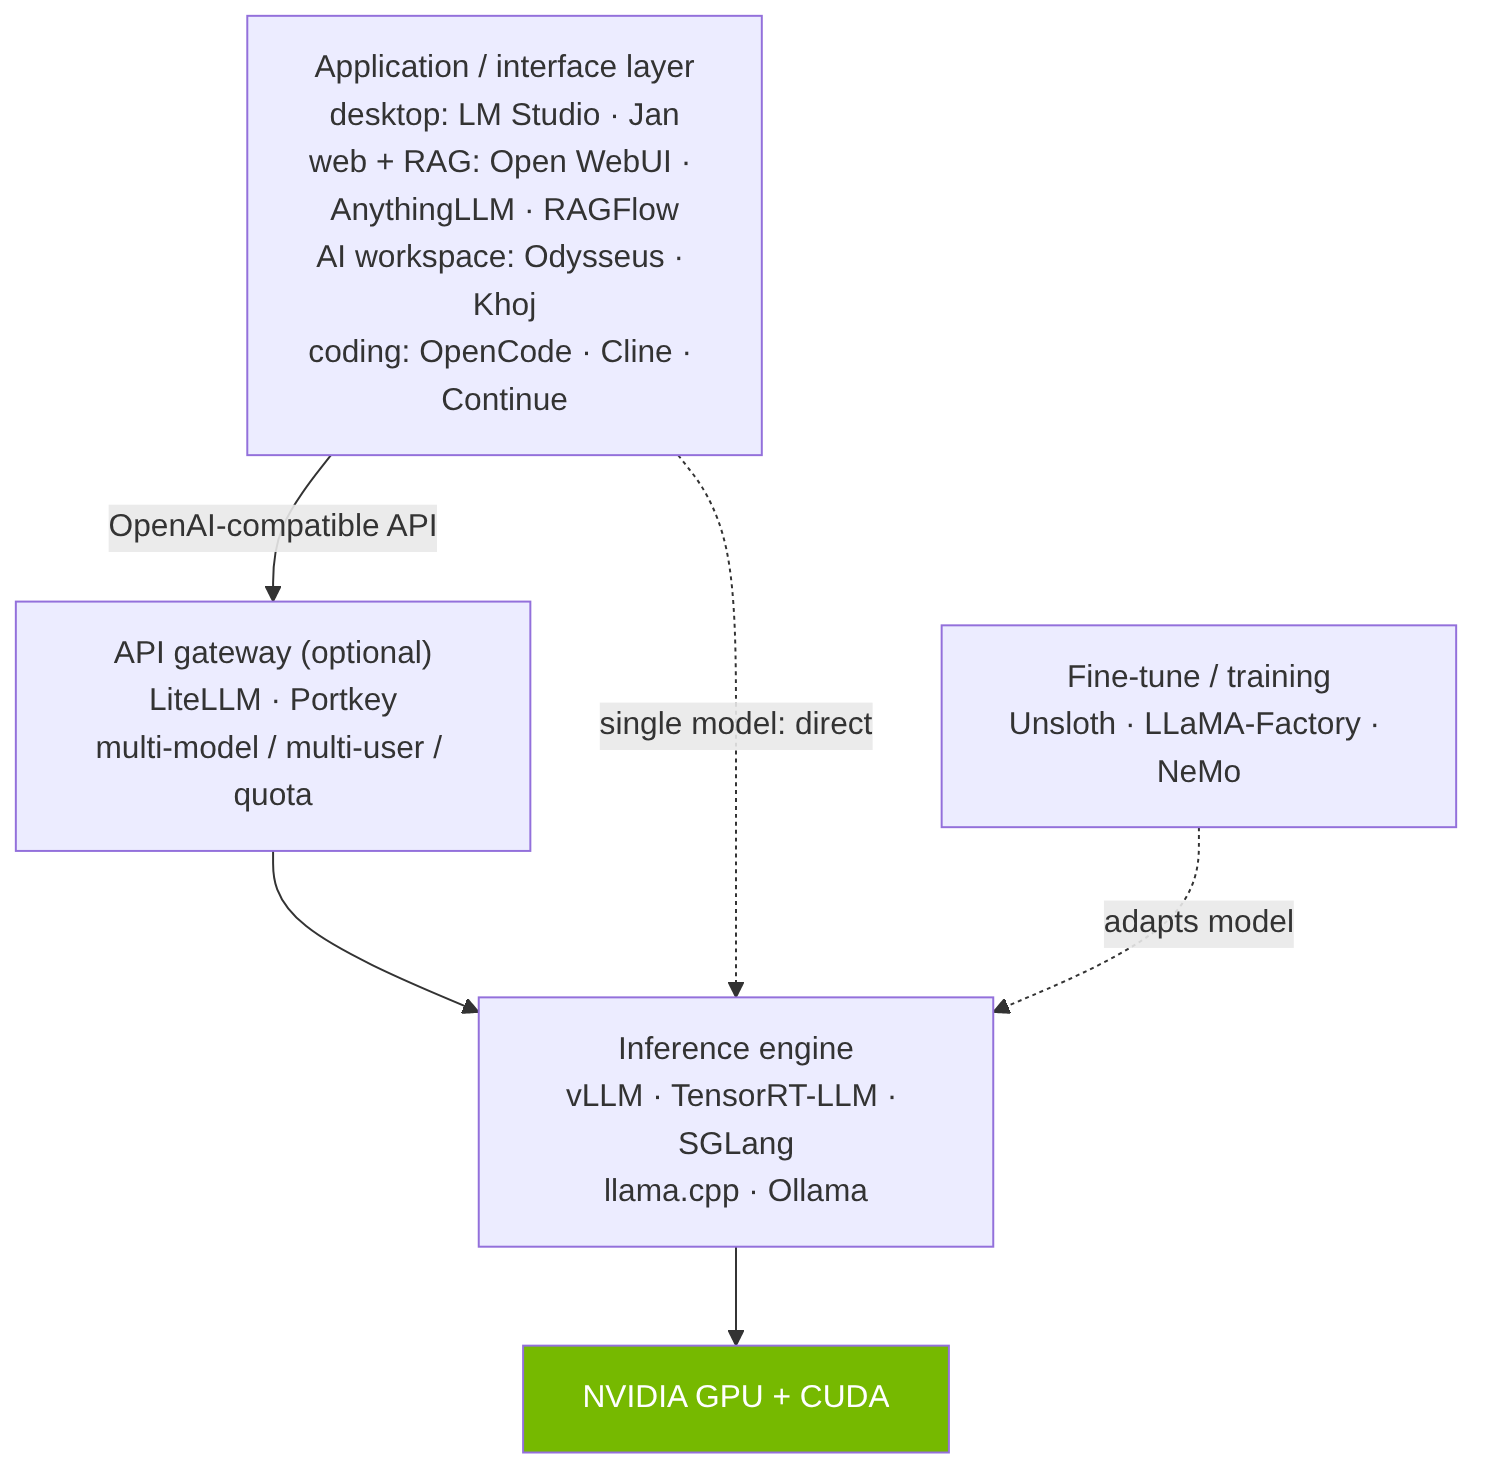
Figuur: Softwarelagen: UI → engine → hardware
Gemeenschappelijke basis — OpenAI-compatibele API: llama.cpp (llama-server), Ollama, vLLM, SGLang en LM Studio bieden allemaal een OpenAI-compatibel endpoint. Dezelfde clientcode (alleen
base_urlwijzigen naar localhost) werkt dus met al deze tools — een cruciaal gemak voor integratie.
6.A. Inferentie-engines (backend)
- llama.cpp — Het fundament van het ecosysteem. C/C++; eigen formaat GGUF (1.5-bit → 8-bit). 15+ backends, waaronder CUDA;
llama-serverbiedt een OpenAI-compatibele HTTP-server. De breedste hardwarecompatibiliteit, draait op de meest bescheiden hardware. Veel tools, zoals LM Studio, Ollama en Jan, bouwen erop voort (GGUF) als inferentie-engine. (Licentie: MIT · ~117k★ · ggml-org/llama.cpp) - Ollama — De eenvoudigste start (
ollama run <model>), met een eigen modelbibliotheek. Verandering in 2026: Sinds juli 2025 is er een officiële desktopapp voor macOS/Windows (chat-GUI, invoer van bestanden/afbeeldingen); Linux blijft CLI. Releases in 2026 voegden een laag voor agents/integraties toe, sneller laden van GGUF, meerdere gelijktijdige sessies en het publiceren van modellen naar de cloud. Zowel een eigen REST-API als een OpenAI-compatibele API. Er zijn tientallen frontends (Open WebUI, AnythingLLM…) bovenop gebouwd. (Licentie: MIT · ~174k★ · ollama/ollama) - vLLM — Serving-engine met hoge doorvoer. PagedAttention verdeelt de KV-cache in pagina’s (geheugenverspilling <4%). ~24× de doorvoer van naïeve HF, en 2–4× die van Ollama bij hoge gelijktijdigheid. OpenAI-compatibele server. Voor productie / meerdere gebruikers / GPU-serving met hoge gelijktijdigheid; niet voor de desktop. (Vrijwel wekelijkse releases; v0.22.1, juni 2026.) (Licentie: Apache-2.0 · ~83k★ · vllm-project/vllm)
- SGLang — Een tegenhanger van vLLM. RadixAttention slaat gemeenschappelijke prefixen (systeemprompt, geschiedenis van meerdere beurten) maar één keer op. Volgens berichten in productie op 400,000+ GPU’s bij onder meer xAI/NVIDIA; in sommige tests ~29% hogere doorvoer dan vLLM op een H100. Sterk voor scenario’s met agents / meerdere beurten / gemeenschappelijke prompts. (Licentie: Apache-2.0 · ~29k★ · sgl-project/sglang)
- TensorRT-LLM (NVIDIA) — NVIDIA’s eigen opensource-inferentie-engine met de hoogste prestaties, uitsluitend voor NVIDIA-GPU’s. Compileert het model tot een TensorRT-engine voor een specifieke combinatie van model, GPU en precisie (fused kernels, geoptimaliseerde attention, agressieve kwantisatie). Ondersteunt FP8, FP4, INT4-AWQ, INT8-SmoothQuant; bevat in-flight batching, een gepagineerde KV-cache en speculatieve decodering. In gepubliceerde benchmarks ligt het op kaarten van de H100-klasse doorgaans ~15–30% voor op vLLM in piekdoorvoer/latentie. Kosten: de compilatiestap (engine build) en de operationele overhead zijn hoger dan bij vLLM, en de aanpassing aan nieuwe modellen verloopt trager. Wanneer: voor productiediensten die voor NVIDIA-hardware hebben gekozen en de laatste druppel prestaties willen. Overkill voor een desktop met één gebruiker; daar zijn Ollama/llama.cpp zinvoller, en voor praktische serving voor meerdere gebruikers vLLM/SGLang. (Licentie: Apache-2.0 · ~14k★ · NVIDIA/TensorRT-LLM)
6.B. Alles-in-één desktopapplicaties
- LM Studio — Verzorgde (closed-source) desktopapp: HF-modelbrowser, downloaden met één klik, chat-GUI en een lokale OpenAI-compatibele server. Win/macOS/Linux. In 2026 kwamen er continuous batching en speculatieve decodering met MTP bij; de
lms-CLI en een headlessllmstervoor server/CI. De beste route voor wie zowel een GUI als een ontwikkeltool wil. (Licentie: closed source · lmstudio.ai) - Jan — Opensource, in de stijl van ChatGPT, 100% offline te gebruiken. Ingebouwde modelhub, cloudconnectoren, MCP-ondersteuning, OpenAI-compatibele API op
localhost:1337. Win/macOS/Linux. Het belangrijkste opensourcealternatief voor LM Studio. (v0.7.9, maart 2026.) (Licentie: Apache-2.0 · ~43k★ · janhq/jan) - Llamafile (Mozilla) — Verpakt het model + llama.cpp in één bestand waarop u dubbelklikt, waarna een chat in de browser opent. Voor absolute eenvoud/draagbaarheid. (Licentie: Apache-2.0 · ~25k★ · Mozilla-Ocho/llamafile)
6.C. Self-hosted AI-werkruimtes van de nieuwe generatie
Deze categorie is de echte vernieuwing van 2026. Het verschil zit niet in “welke chat-UI mooier is”, maar in de vraag of agent + persistent geheugen + MCP + integratie van persoonlijke data (e-mail/agenda/notities) direct uit de doos meekomen. De verschuiving van “chat-UI” → “AI-werkruimte” is echt — maar ook de klassieke UI’s hebben niet stilgestaan (zie de eerlijke beoordeling in 6.D).
- Odysseus (github.com/pewdiepie-archdaemon/odysseus) — Het duidelijkste voorbeeld van dit paradigma. Agentmodus (shell, bestandsbewerkingen, uitvoeren van skills), MCP-ondersteuning, Cookbook (scant uw hardware, stelt VRAM-bewuste modellen voor en downloadt ze — dicht rechtstreeks de kloof “wat kan mijn hardware draaien?”), Deep Research, persistent geheugen & skills met ChromaDB, e-mailtriage (IMAP/SMTP), CalDAV-agenda, notities/taken, vergelijken van modellen. Backend: vLLM, llama.cpp, Ollama (+ OpenRouter/OpenAI/Copilot). Docker compose of native Python. (Licentie: AGPL-3.0 · ~71k★ · pewdiepie-archdaemon/odysseus), actief. (Beveiligingsopmerking: vanwege de brede toegang tot shell en tools raadt het project aan de deployment te beveiligen als een beheerconsole — authenticatie ingeschakeld, niet rechtstreeks aan internet blootgesteld, reverse proxy + HTTPS.)
- Khoj — Een “AI-tweede brein”. Semantisch zoeken + chatten over persoonlijke documenten (PDF, Markdown, Notion, Word, org-mode); eigen agents, geplande automatiseringen, deep research. Een ongewoon breed toegangsoppervlak: browser, Obsidian, Emacs, desktop, mobiel, WhatsApp. Self-hosted (Docker) / cloud / enterprise. Zeer actief. (Licentie: AGPL-3.0 · ~35k★ · khoj-ai/khoj)
- Hermes (Nous Research) — Hermes Agent, een zelfverbeterende autonome agent: automatisch skills aanmaken na complexe taken, persistent geheugen, 40+ tools, MCP, cron-planner, parallelle subagents, berichten via meerdere platforms (Telegram/Discord/Slack/WhatsApp/Signal). Hermes WebUI is een lichte frontend met drie panelen. Een snelgroeiend nieuw project. (Licentie: MIT · ~194k★ · NousResearch/hermes-agent) Belangrijk: onafhankelijk van het model-endpoint (niet local-first); voor een lokale LLM richt u het op een eigen endpoint van Ollama/vLLM.
6.D. Klassieke web-UI’s en RAG-oplossingen
Klassieke / algemene web-UI’s:
- Open WebUI — Het eerlijke antwoord op “is het achterhaald?”: deels, maar minder dan u denkt. De populairste self-hosted chat-UI (~141k★, zeer actief). Het heeft moderne mogelijkheden toegevoegd: MCP-ondersteuning (+registry), native tool calling in Python, het pluginframework Pipelines, lokale RAG met 9 vectordatabases, zoeken op het web via 15+ aanbieders. De terechte kritiek: het is in de kern nog steeds een chatfrontend + RAG + plugins; het heeft geen werkruimte-identiteit met e-mailtriage, agenda, notities, een hardwarebewust model-cookbook of een zelfverbeterende lus voor skills/geheugen. Het staat dus niet stil — het zit alleen op het spoor van de “algemene UI”, niet op dat van de “AI-werkruimte”. (Licentie: Open WebUI License — BSD-3 + merkvoorwaarde · ~142k★ · open-webui/open-webui)
- LibreChat — Meerdere aanbieders, eigen agents/assistenten zonder code, MCP, een beveiligde code-interpreter in een sandbox, zoeken op het web, code-artifacts. De ruimste licentie van de grote UI’s; zeer actief. (Licentie: MIT · ~39k★ · danny-avila/LibreChat)
- LobeChat / LobeHub — Heeft zich expliciet opnieuw gepositioneerd richting het agentparadigma: Agent Builder, Agent Groups, planning voor geautomatiseerde runs, een bewerkbaar “Personal Memory”, 10,000+ tool-/MCP-plugins. Het bewijs dat de verschuiving “chat → werkruimte” ook bij de klassiekers echt is. (Licentie: LobeHub Community License · ~79k★ · lobehub/lobe-chat)
- Cherry Studio — Desktopclient (Electron; Win/macOS/Linux). Uniforme toegang tot LLM’s + lokaal; gebruik van MCP-tools, agents, 300+ kant-en-klare assistenten, vooraf gekoppelde MCP-servers voor bestandssysteem/GitHub/zoeken op het web/geheugen. Ondersteunt de lokale API van Ollama. Voor de desktop met één gebruiker / wie een eigen API-sleutel meebrengt. (Licentie: AGPL-3.0 · ~35k★ · CherryHQ/cherry-studio)
Op RAG gerichte oplossingen (vraag en antwoord over uw eigen documenten):
- AnythingLLM — Een eigen ChatGPT over uw documenten; sterke agentfuncties: agent builder zonder code, surfen op het web, agenttaken gepland via cron, MCP. RAG met bronvermelding; LanceDB + PGVector/Pinecone/Weaviate/Qdrant; meerdere gebruikers. Lokale backends: Ollama, LM Studio, llama.cpp, LocalAI. Docker of desktop. Staat tussen RAG en werkruimte in. (Licentie: MIT · ~62k★ · Mintplex-Labs/anything-llm)
- OpenRAG-Local (CordatusAI) — ⭐ De opensourcebijdrage van Cordatus (github.com/CordatusAI/openrag-local). We hebben het OpenRAG-project van Langflow (
langflow-ai/openrag) geforkt, aangepast zodat het volledig lokaal draait en als opensource uitgebracht: er zijn geen cloud-API-sleutels nodig, inferentie draait op uw eigen GPU met sglang/vLLM (OpenAI-compatibel), en embeddings worden lokaal gemaakt met TEI. U uploadt uw documenten en bevraagt ze via een chatinterface. Stack: Langflow (flow-engine) + OpenSearch (vectoropslag) + Docling (documentparsing met OCR) + SearXNG (lokaal zoeken op het web). Het omvat agentische RAG, re-ranking en orkestratie van meerdere agents; het wordt met één Docker Compose-commando uitgerold en ondersteunt toewijzing van meerdere GPU’s. De voorbeeldconfiguratie gebruikt GLM-5.1-FP8 als LLM — het is dus volledig compatibel met de hardwarekeuzes (RTX PRO / DGX) en modelkeuzes (Apache/MIT) in deze handleiding, zodat u kosteloos een volledig lokale oplossing voor vraag en antwoord over documenten kunt opzetten. (Licentie: Apache-2.0 · CordatusAI/openrag-local — fork vanlangflow-ai/openrag, jong project.) - RAGFlow — Een toonaangevende open RAG-engine die diepgaand documentbegrip combineert met agentmogelijkheden. Sterk in rommelige documenten uit de praktijk (PDF/scans/slides/Excel); verklaarbare chunking, traceerbare/onderbouwde bronvermeldingen (tegen hallucinaties), agentworkflows + code-uitvoering + MCP. Docker Compose (4+ cores, 16 GB RAM). Van de specifieke RAG-engines heeft deze de meeste sterren; voor serieuze/productiewaardige vraag en antwoord over documenten. (Licentie: Apache-2.0 · ~82k★ · infiniflow/ragflow)
6.E. API-gateways / routering (gateway & router)
Deze laag is het idee uit de inleiding van §6 — “allemaal OpenAI-compatibel, één
base_url“ — opgeschaald naar bedrijfsniveau: ze plaatst meerdere modellen/servers/aanbieders achter één OpenAI-compatibel endpoint.
Wanneer is het nodig? Bij één gebruiker + één model is het niet nodig — het eigen endpoint van de engine volstaat. Het komt wel in beeld bij meerdere teams, meerdere modellen, meer dan één GPU-server, een mix van lokaal en cloud, of facturering op gebruik/quota (zie scenario C en G).
Positie in de architectuur: Applications / IDE → [Gateway] → vLLM · TensorRT-LLM · Ollama · llama.cpp endpoints
Wat het biedt: virtuele API-sleutels (isolatie per team), budget + rate limiting (quota), routering + load balancing + fallback (“goedkope taak → klein model, moeilijke taak → groot model”), bijhouden van kosten/gebruik, observability (Langfuse e.d.), caching en guardrails.
Belangrijke opmerking over de vereisten: Een gateway rekent niet, maar stuurt alleen door (proxy) → er is geen GPU nodig, een CPU volstaat, weinig resources. Typische opstelling: Docker + Postgres voor de state (sleutels/budget) + optioneel Redis (cache/rate limiting). Het is dus veel lichter dan de engine-laag; het is niet “nog een GPU-kast”.
- LiteLLM — De meest gangbare keuze. Zowel een Python-SDK als LiteLLM Proxy (gatewayserver): virtuele sleutels, budget/limieten, routering/fallback, bijhouden van kosten, logging naar Langfuse, Redis-cache. Lokaal koppelt het rechtstreeks aan endpoints van vLLM/Ollama. (Licentie: MIT — de map
enterprise/valt onder een aparte commerciële licentie · ~50k★ · BerriAI/litellm) - Portkey AI Gateway — Snelle opensource-edge-gateway; routering/fallback/cache/observability, zelf te hosten. (Licentie: MIT · ~12k★ · Portkey-AI/gateway)
- Kong AI Gateway — Voor organisaties die Kong al gebruiken; geen apart project, maar een functie binnen Kong Gateway (routering over meerdere LLM’s). (Licentie: Apache-2.0 · ~44k★ · Kong/kong)
- Envoy AI Gateway — Gebouwd op Envoy Gateway; een leveranciersneutrale toegangslaag voor K8s-omgevingen. (Licentie: Apache-2.0 · ~2k★ · envoyproxy/ai-gateway)
- Aan de NVIDIA-kant (volgens het rapport): NIM-microservices — gecontaineriseerde, OpenAI-compatibele, geoptimaliseerde inferentiediensten (Licentie: gesloten/propriëtair; voor productie NVIDIA AI Enterprise · docs.nvidia.com/nim); voor geschaalde serving zonder een aparte gateway op te zetten vLLM production-stack met een eigen router (Licentie: Apache-2.0 · ~2k★ · vllm-project/production-stack). Voor modelbeheer over meerdere GPU’s/meerdere nodes (een “clustermanager” naast de gateway) GPUStack (Licentie: Apache-2.0 · ~5k★ · gpustack/gpustack).
6.F. Tools voor fine-tuning & training (opensource)
Met deze tools brengt u de vier niveaus uit §4.2 (pre-training · full fine-tune · LoRA · QLoRA) in de praktijk. De meeste organisaties beginnen met LoRA/QLoRA — zelfs mogelijk op een werkstation met één GPU; volledige fine-tuning en training vanaf nul vereisen meerdere GPU’s/meerdere nodes. Alles draait op NVIDIA CUDA. Voor de koppeling aan hardware, zie 4.2 en scenario F.
Eenvoudige instap — LoRA/QLoRA fine-tune (één / enkele GPU’s):
- Unsloth — De snelste LoRA/QLoRA met het laagste VRAM-gebruik; past grote modellen aan op één GPU. Met Unsloth Studio verloopt data → training → evaluatie → export (LoRA/GGUF) in één flow in een lokale web-UI zonder code. (Licentie: Apache-2.0 / AGPL-3.0 dual — de AGPL-clausule vereist een juridische toets binnen de onderneming · ~67k★ · unslothai/unsloth)
- LLaMA-Factory — WebUI/CLI zonder code; fine-tunet het breedste scala van 100+ LLM’s en VLM’s. De praktischste instap voor teams. (Licentie: Apache-2.0 · ~72k★ · hiyouga/LLaMA-Factory)
- Axolotl — Door YAML-configuratie gestuurde, versiebeheerde, reproduceerbare fine-tune-pipelines; schaalt van één GPU naar meerdere GPU’s. (Licentie: Apache-2.0 · ~12k★ · axolotl-ai-cloud/axolotl)
Alignment / bouwstenen:
- Hugging Face TRL — Componentbibliotheek voor alignment / post-training (SFT, DPO, GRPO/RLHF). (Licentie: Apache-2.0 · ~19k★ · huggingface/trl)
- Hugging Face PEFT — Het fundament van de LoRA-/adapter-engine; niet zelfstandig, maar werkt als afhankelijkheid onder tools als TRL/Axolotl. (Licentie: Apache-2.0 · ~21k★ · huggingface/peft)
Serieuze / grootschalige & gedistribueerde training (meerdere GPU’s / DGX-klasse):
- NVIDIA NeMo — NVIDIA-native end-to-end trainingsframework; voor DGX-klasse met meerdere GPU’s/meerdere nodes. (Licentie: Apache-2.0 · ~17k★ · NVIDIA-NeMo/NeMo)
- Megatron-LM — Voor NVIDIA-GPU’s geoptimaliseerde bibliotheek voor grootschalige pretraining vanaf nul. (Licentie: Apache-2.0 · ~17k★ · NVIDIA/Megatron-LM)
- DeepSpeed — Backend voor gedistribueerde training (ZeRO, offloading naar CPU/NVMe); maakt het mogelijk modellen te trainen waarvoor één kaart onvoldoende VRAM heeft. (Licentie: Apache-2.0 · ~43k★ · deepspeedai/DeepSpeed)
Keuze: Voor snelle aanpassing op één werkstation Unsloth of LLaMA-Factory; voor versiebeheerde pipelines Axolotl; voor alignment TRL; voor gedistribueerde training/pretraining van DGX-klasse NeMo + Megatron + DeepSpeed. Test het gefinetunede model altijd op uw eigen evaluatieset (zie 5.9).
6.G. Code-assistenten & agents (opensource)
Alle onderstaande tools koppelen aan een lokale LLM via een OpenAI-compatibel / Ollama-endpoint — code-assistenten/agents worden dus gebruikt zonder dat uw code of repository de machine verlaat en zonder verbinding met een gesloten cloud. Cruciaal voor zakelijke en air-gapped omgevingen. Kies voor codetaken een model dat tool calling beheerst (zie 5.2); modellen van de klasse Qwen-Coder / DeepSeek-Coder passen goed.
Terminalagents:
- OpenCode — Terminal-native, de populairste open codeeragent; ondersteuning voor 75+ aanbieders + lokale endpoints. (Licentie: MIT · ~175k★ · sst/opencode)
- Aider — Git-bewust “pair programming” in de terminal; volwassen en gevestigd. (Licentie: Apache-2.0 · ~46k★ · Aider-AI/aider)
In de IDE (VS Code / JetBrains):
- Cline — Autonome codeeragent voor VS Code/JetBrains; open ondersteuning voor Ollama/LM Studio/OpenAI-compatibel. (Licentie: Apache-2.0 · ~63k★ · cline/cline)
- Continue — IDE-assistent: chat + automatisch aanvullen + agentmodus, volledig configureerbaar voor lokale modellen. (Licentie: Apache-2.0 · ~34k★ · continuedev/continue)
Brede softwareagent:
- OpenHands — End-to-end software-engineeringagent in een sandbox (voorheen OpenDevin); koppelt aan lokale vLLM/Ollama. (Licentie: MIT · ~77k★ · All-Hands-AI/OpenHands)
Self-hosted automatisch aanvullen (geschikt voor air-gapped):
- Tabby — Volledig zelf te hosten alternatief voor Copilot (FIM-aanvulling + chat); ideaal voor on-prem / air-gapped omgevingen. (Licentie: Apache-2.0-kern +
ee/met aparte commerciële licentie · ~34k★ · TabbyML/tabby)
Opmerking: Roo Code en Void zijn in 2026 gearchiveerd (niet langer actief onderhouden); als vervanging worden respectievelijk Cline / Kilo Code en Cline / Continue aanbevolen. Voor een bredere “agent op uw eigen machine” is ook Goose (Apache-2.0, ~49k★) een optie; omdat het op tool calling leunt, vallen zwakke lokale modellen echter terug naar chatmodus.
7. Voorbeeldscenario’s voor deployment
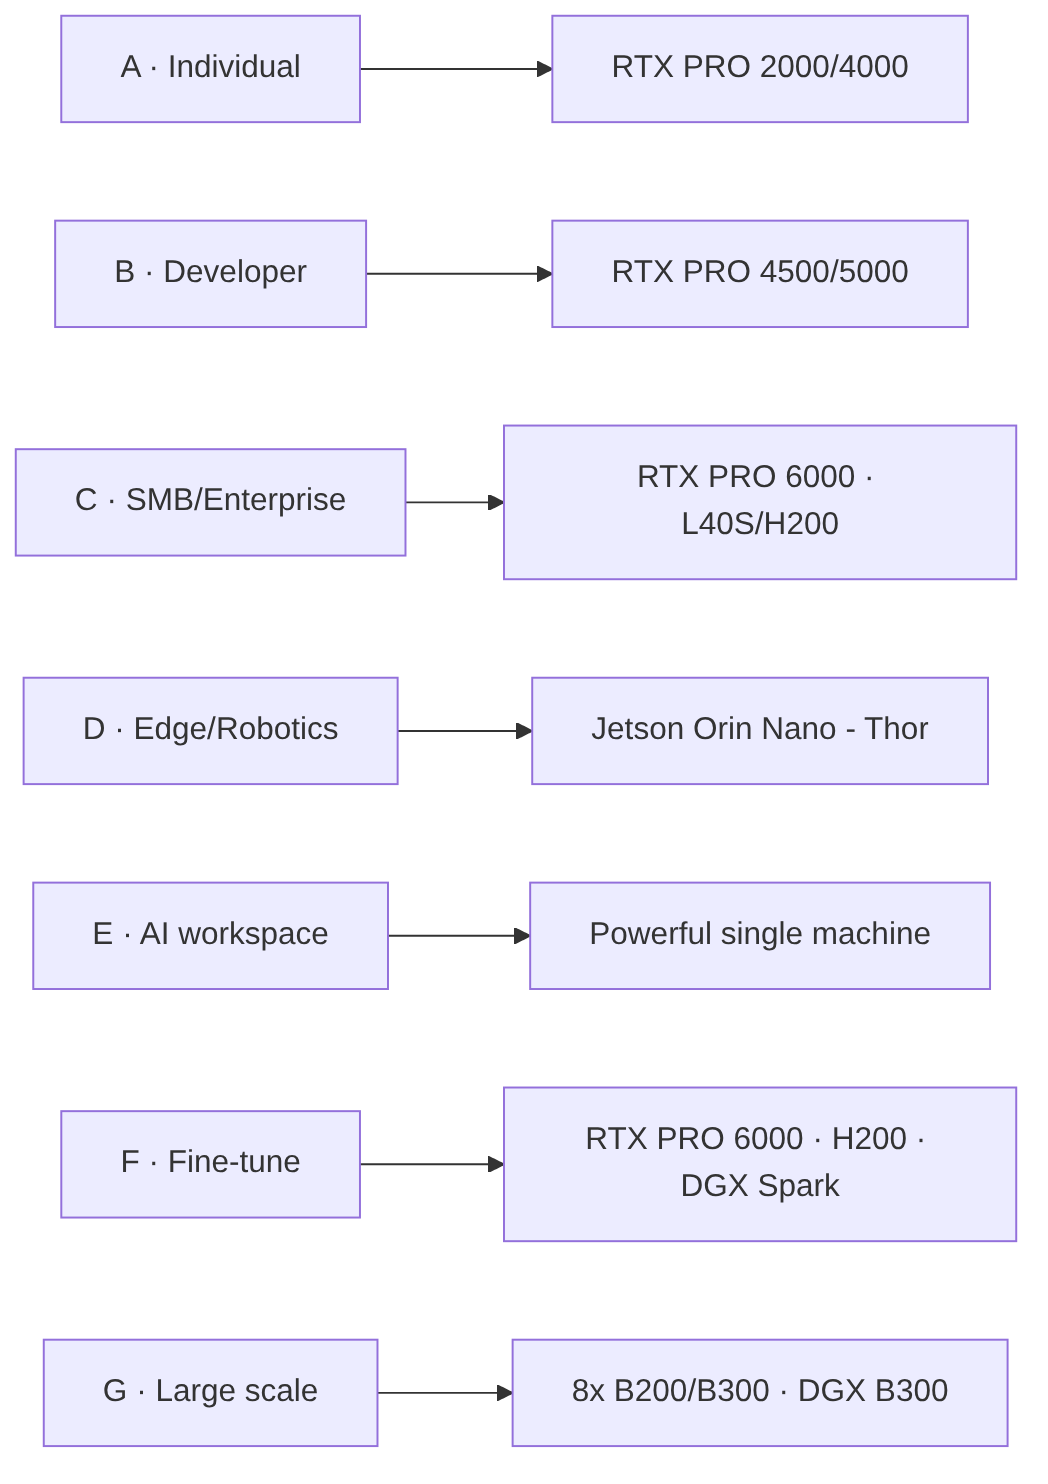
Figuur: Koppeling van scenario aan hardware
Scenario A — Individuele / privacybewuste gebruiker (instapwerkstation). RTX PRO 2000 (16 GB) of RTX PRO 4000 (24 GB) → Ollama of LM Studio → een model van 8B–14B (bijv. Qwen3 8B / Gemma 4 12B, Q4_K_M). Optioneel Jan als UI. Laag vermogen, stil, volledig offline. Wie zich niet met de installatie wil bezighouden, kan meteen aan de slag met de vooraf geïnstalleerde en geteste kant-en-klare werkstations van Aetherix (aetherix.com/product-category/graphics-cards, zie 4.5/B).
Scenario B — Ontwikkelaar (code-assistent + integratie). RTX PRO 4500 (32 GB) of RTX PRO 5000 (48 GB) → Ollama/LM Studio voor persoonlijk gebruik, vLLM of TensorRT-LLM voor veel verzoeken/serving → een codemodel (klasse Qwen3.6 / DeepSeek-Coder). Dankzij het OpenAI-compatibele endpoint koppelt het rechtstreeks aan IDE’s en uw eigen tools; opensourcetools zoals OpenCode / Aider / Cline / Continue koppelen als code-assistent/agent aan het lokale model (zie 6.G). Met een kant-en-klaar werkstation met Ubuntu + NVIDIA-stack vooraf geïnstalleerd kunt u beginnen zonder een dag te verliezen (aetherix.com/product-category/graphics-cards, zie 4.5/B).
Scenario C — Mkb / organisatie (documentgebaseerd, meerdere gebruikers). Server + RTX PRO 6000 (96 GB) of, voor het datacenter, L40S / H100 NVL / H200 NVL → backend vLLM of TensorRT-LLM, met daarbovenop naar behoefte OpenRAG-Local (CordatusAI) / AnythingLLM / RAGFlow (RAG over bedrijfsdocumenten, meerdere gebruikers, bronvermelding). Met een model met Apache-/MIT-licentie (Qwen/DeepSeek/GLM) is het commercieel veilig.
Scenario D — Edge / robotica / in het veld. Jetson Orin Nano (8 GB) voor kleine modellen, Jetson AGX Orin (64 GB) of AGX Thor (128 GB) voor grote modellen aan de edge → llama.cpp/Ollama → inferentie op het apparaat zonder internet. Voor embedded producten, robots en toepassingen in het veld.
Scenario E — Persoonlijke “AI-werkruimte” (agent + geheugen + persoonlijke data). Eén krachtige machine → Odysseus of Khoj → e-mailtriage, agenda, notities, deep research en persistent geheugen onder één dak; als backend lokaal Ollama/vLLM/llama.cpp. Voor wie verder wil gaan dan “alleen chatten”.
Scenario F — Aanpassing van het model (fine-tune). Om een model aan uw eigen data aan te passen: LoRA/QLoRA voor 7B–13B → 1× RTX PRO 6000 (96 GB) of 1× H200; LoRA voor 70B → 2–4× H200, QLoRA voor 70B → 1× DGX Spark (128 GB). 70B fine-tunen op één DGX Spark (QLoRA) kan op de desktop; naarmate het team groeit, schaalt het op met een 2–3× ring. Aan de softwarekant worden Unsloth / LLaMA-Factory / Axolotl (LoRA/QLoRA) gebruikt, en op grote schaal NeMo / DeepSpeed (zie 6.F); valideer het resultaat op uw eigen evaluatieset (zie 5.9).
Scenario F2 — Diepgaande domeinaanpassing (full fine-tune). Voor diepgaande domeinaanpassing waarbij LoRA tekortschiet (bijv. voortgezette pre-training in het Turks, gespecialiseerde medische/juridische modellen): full fine-tune van 70B → 4–8× H200 (met ZeRO-3), ~1 TB VRAM. Een lage learning rate + het mengen van domeindata met algemene data zijn essentieel om catastrofaal vergeten te beperken (zie 4.2). Software: NeMo / Megatron-LM / DeepSpeed (zie 6.F).
Scenario G — Grootschalige productie / training vanaf nul. Inferentie met veel verkeer (500+ gelijktijdig) of pre-training (vanaf nul) → 8× B200 / B300 (HGX/DGX-team), op bedrijfsschaal DGX B300 als “AI-fabriek”. InfiniBand-netwerk, koeling van serverklasse en TCO-planning zijn verplicht (zie 4.9). Op de schaal van een ministerie of instantie on-prem uitgerold, zodat de data volledig binnen de instelling blijven.
8. Risico’s en aandachtspunten
- Betrouwbaarheid van de modelbron. Download modellen van betrouwbare bronnen (officiële modelkaarten op Hugging Face), niet uit willekeurige repository’s.
- Toegangsbeheer op het lokale netwerk. Werkruimtes met toegang tot agents/tools (zoals Odysseus en Hermes) kunnen toegang hebben tot de shell en bestanden — beveilig ze als een beheerconsole: authenticatie ingeschakeld, niet rechtstreeks aan internet blootstellen, een reverse proxy + HTTPS gebruiken.
- Hallucinaties en nauwkeurigheid. Ook lokale modellen kunnen dingen verzinnen; bij kritisch gebruik zijn onderbouwing met bronnen via RAG (antwoorden met bronvermelding) en menselijke controle essentieel.
- Naleving van licenties. Controleer voor commercieel gebruik altijd de modellicentie (vooral bij de Llama-familie en afgeleide Turkse modellen).
- Updates en duurzaamheid. Zowel modellen als tools verouderen snel; plan regelmatige updates en wijs een verantwoordelijke voor het onderhoud aan.
Veelgemaakte fouten bij het dimensioneren van hardware
- ✗ Kleine GPU, hoge verwachtingen: proberen een 70B-model op één L40S te draaien.
- ✗ Het totale VRAM verkeerd berekenen: de som van gewichten + KV-cache + activaties + overhead negeren.
- ✗ B200/B300 als losse kaarten behandelen: deze worden verkocht als team van minimaal 8 GPU’s; plan het budget daarop.
- ✗ Netwerkknelpunt: de InfiniBand-/Ethernet-bandbreedte bij meerdere nodes over het hoofd zien.
- ✗ Koeling verwaarlozen: een server met 8× B200 is ~15 kW+; controleer de koelcapaciteit.
- ✗ Geen TCO berekenen: alleen naar de GPU-prijs kijken en elektriciteit/koeling/onderhoud negeren.
- ✗ Kwaliteit van kwantisatie negeren: INT4/INT8 gebruiken zonder het effect op de nauwkeurigheid van het model te testen.
- ✗ Snelheid van schijf/opslag verwaarlozen: een NVMe-SSD is verplicht voor het laden van modellen en checkpoints; een HDD is te traag.
- ✗ PCIe-knelpunt: geen rekening houden met de bandbreedte tussen GPU en CPU bij multi-GPU.
- ✗ Geen schaalplan: bij de eerste aankoop geen rekening houden met toekomstige groei.
- ✗ Incompatibiliteit in de softwarestack: versies van CUDA/driver/framework die niet op elkaar aansluiten.
- ✗ Geen redundantieplan: onderbreking van de dienst bij uitval van een GPU.
Proces voor het dimensioneren van hardware

Figuur: Proces voor het dimensioneren van hardware
Checklist voor het dimensioneren van hardware
- ☐ Is de toepassing duidelijk? (Training / fine-tune / inferentie)
- ☐ Zijn de beoogde modelgrootte en -familie bepaald?
- ☐ Zijn de kandidaatmodellen getest op uw eigen evaluatieset? (kwaliteit + TPS/TTFT + kwantisatieverlies — zie 5.9)
- ☐ Is het aantal gelijktijdige gebruikers geschat?
- ☐ Zijn de doelen voor de servicekwaliteit vastgesteld? (TTFT, TPS)
- ☐ Is de VRAM-behoefte berekend? (Gewichten + KV-cache + overhead)
- ☐ Is er een GPU-vergelijking gemaakt? (VRAM, FLOPS, bandbreedte, verkoopeenheid)
- ☐ Is het budget voor een team van 8 GPU’s toereikend voor B200/B300?
- ☐ Is de technische specificatie opgesteld?
- ☐ Is er een TCO-analyse gemaakt? (Hardware + elektriciteit + koeling + onderhoud)
- ☐ Is de infrastructuur (stroom, koeling, netwerk) gecontroleerd?
- ☐ Zijn goedkeuring en budgetplanning afgerond?
9. Conclusie en aanbevelingen
Beslismatrix (samenvatting):
| Uw situatie | Aanbeveling |
|---|---|
| Datasoevereiniteit / overheid / gevoelige data | Lokale LLM vrijwel verplicht; model met Apache-/MIT-licentie + on-prem server |
| Intensief en continu gebruik | Een lokale opstelling heeft op de lange termijn de laagste marginale kosten |
| Incidenteel / licht gebruik | Een instapkaart of een bestaand werkstation volstaat |
| Instapwerkstation (laag vermogen) | RTX PRO 2000 (16 GB) / PRO 4000 (24 GB) + Ollama + model van 8–14B in Q4 |
| 70B+ vereist | RTX PRO 6000 (96 GB) / DGX Spark (128 GB) — RTX PRO 5000 (48 GB) alleen op de grens, met Q4 + korte context |
| Edge / robotica / veld | Jetson Orin Nano (8 GB) → AGX Orin (64 GB) → AGX Thor (128 GB) |
| Productiedienst voor meerdere gebruikers | L40S / H100 NVL (94 GB) / H200 NVL (141 GB) + vLLM/TensorRT-LLM |
| Alleen chatten | Ollama/LM Studio + (optioneel) Open WebUI |
| Agent + persoonlijke data + geheugen | Een AI-werkruimte van de klasse Odysseus / Khoj / Hermes |
| Vraag en antwoord over documenten | OpenRAG-Local (CordatusAI) / AnythingLLM / RAGFlow |
Vooruitblik. Drie trends zijn duidelijk: (1) dankzij de MoE-architectuur naderen kleine modellen met weinig “actieve parameters” snel de kwaliteit van grote modellen — dus steeds betere resultaten bij dezelfde rekenkosten (hoewel de geheugenbehoefte nog steeds van het totale aantal parameters afhangt); (2) het leiderschap bij open-weight modellen is verschoven naar Chinese labs (Qwen, DeepSeek, GLM, Kimi), en commercieel gebruik is eenvoudiger geworden dankzij Apache-/MIT-licenties; (3) de softwarelaag is uitgegroeid van “chat-UI” tot “AI-werkruimte” (agent + geheugen + persoonlijke data + hardwarebewuste modelkeuze). Met tools als het Cookbook van Odysseus begint zelfs de “modelkeuze” zelf geautomatiseerd te worden.
Slotaanbeveling. Begin klein: probeer een model van 8–14B met een instapkaart als de RTX PRO 2000/4000, of met Ollama/LM Studio op uw bestaande machine; schaal de hardware- en softwarelaag op naarmate de behoeften duidelijker worden. Werk met modellen met een permissieve licentie (Apache/MIT), zodat er bij de overstap naar commercieel gebruik geen verrassingen zijn. Wilt u samen beoordelen welke hardware bij uw behoeften past, neem dan contact op met het team van Aetherix.
Woordenlijst (begrippen)
- LLM (Large Language Model): Een model dat is getraind op zeer grote hoeveelheden tekstdata en dat natuurlijke taal begrijpt en genereert.
- Inferentie: Een getraind model uitsluitend draaien om antwoorden te produceren.
- Fine-tuning: Een voorgetraind model aanpassen aan uw eigen data. Volledige fine-tuning werkt alle modelparameters bij (veel VRAM, risico op catastrofaal vergeten — zie 4.2); LoRA/QLoRA trainen alleen kleine adapterlagen (weinig VRAM, basismodel blijft behouden).
- LoRA / QLoRA: Efficiënte fine-tuningmethoden die kleine extra lagen trainen in plaats van het hele model; QLoRA verkleint het geheugen verder door te kwantiseren.
- VRAM: Het geheugen van de grafische kaart; de enige harde beperking bij een lokale LLM.
- Token: De teksteenheid die het model verwerkt (ruwweg een stuk van een woord).
- Context: Het venster van tokens dat het model op één moment in beschouwing neemt.
- KV-cache: Het in het geheugen vasthouden van de attention-keys/-values van gegenereerde tokens; groeit lineair met de contextlengte en het aantal gelijktijdige verzoeken.
- Kwantisatie: Gewichten met minder bits opslaan om geheugen te besparen (FP16 → Q8 → Q4).
- GGUF: Het meest gebruikte lokale bestandsformaat voor kwantisatie bij llama.cpp/Ollama.
- Q4_K_M: 4-bit kwantisatie; behoudt ~92–95% van de kwaliteit en verkleint het geheugen ~4×.
- FP16 / FP8 / INT4, MXFP4 / NVFP4: Formaten voor numerieke precisie; naarmate het aantal bits daalt, nemen geheugen- en rekenbehoefte af. Blackwell ondersteunt hardware-native FP4.
- MoE (Mixture-of-Experts): Het totale aantal parameters is groot, maar bij elke stap draait slechts een klein “actief” deel.
- Actieve parameters: Het aantal parameters dat bij MoE per token daadwerkelijk wordt gebruikt; snelheid en kosten volgen dit aantal.
- Dense model: De klassieke architectuur waarbij bij elke stap alle parameters worden gebruikt.
- GQA (Grouped-Query Attention): Een attention-methode die de KV-cache en daarmee het geheugenverbruik verkleint.
- Prefill (verwerking van de prompt): De eerste fase van inferentie; alle invoertokens worden parallel verwerkt, rekengebonden.
- Decode / autoregressieve generatie: De fase waarin het antwoord token voor token, sequentieel wordt gegenereerd; binnen één verzoek niet te paralleliseren, geheugengebonden; stopt bij het EOS-token of de maximale tokenlimiet.
- Speculatieve decodering: Het grote model verifieert in één pass de tokens die een klein draftmodel of een kleine kop voorstelt; versnelt decode 2–3× (bijv. EAGLE-3, MTP).
- Disaggregated prefill: De prefill- en decodefase in aparte GPU-pools draaien; elke fase schaalt volgens haar eigen knelpunt.
- TTFT (Time to First Token): Latentie tot het eerste token; rekengebonden (afhankelijk van FLOPS).
- TPS (Tokens per second): Generatiesnelheid; geheugengebonden (afhankelijk van de geheugenbandbreedte).
- Doorvoer: Het totale aantal verzoeken/tokens dat per tijdseenheid wordt verwerkt; neemt toe naarmate de batch groeit.
- Batch: De groep verzoeken die in één keer wordt verwerkt; doorvoer↑ maar latentie↑.
- Geheugenbandbreedte: De leessnelheid van het GPU-geheugen (GB/s); bepaalt de TPS.
- FLOPS / TOPS: Rekencapaciteit per seconde; heeft invloed op training en TTFT.
- TDP: Het referentievermogen van de kaart (watt).
- Tensor- / pipelineparallellisme: Twee methoden om een model bij multi-GPU over kaarten te verdelen.
- RAG (Retrieval-Augmented Generation): Relevante fragmenten uit uw eigen documenten ophalen en het model daarmee een antwoord laten genereren.
- Embedding: Een model dat tekst omzet in een semantische vector; de basis van semantisch zoeken en RAG.
- Reranking: Opgehaalde resultaten opnieuw rangschikken op relevantie.
- Vectordatabase: Een opslag die embeddings bewaart en op gelijkenis zoekt.
- Agent: Een LLM-toepassing die tools aanroept en taken met meerdere stappen uitvoert.
- MCP (Model Context Protocol): Een open standaard die het model verbindt met externe tools en databronnen.
- Tool calling / function calling: Het vermogen van het model om gedefinieerde tools/functies aan te roepen.
- Guardrail: Een beveiligings-/filterlaag die invoer en uitvoer controleert.
- Gateway / router: De ene OpenAI-compatibele toegangs- en routeringslaag vóór opstellingen met meerdere modellen/meerdere servers.
- TCO (Total Cost of Ownership, totale eigendomskosten): Het totaal van hardware + elektriciteit + koeling + netwerk + onderhoud + personeel.
- Air-gapped (geïsoleerd): Een gerubriceerd netwerk zonder internet of verbinding met externe netwerken, fysiek geïsoleerd.
Bronnen
De onderstaande cijfers (TFLOPS, geheugenbandbreedte, vermogenswaarden en benchmarkscores) zijn per juni 2026 samengesteld uit de betreffende officiële datasheets, modelkaarten en benchmarksites; raadpleeg voor actuele waarden de primaire bronnen. Het aantal sterren is bij benadering en veranderlijk.
Hardware (technische specificaties, TDP):
- NVIDIA-datacenter-GPU’s (B200, B300, H100/H200, L4, L40S) en DGX-systemen — https://www.nvidia.com/en-us/data-center/
- NVIDIA RTX PRO Blackwell-werkstation-GPU’s — https://www.nvidia.com/en-us/products/workstations/
- NVIDIA Jetson-edgeplatforms (Orin, Thor) — https://developer.nvidia.com/embedded-computing
Inferentie-engines & metingen:
- vLLM https://docs.vllm.ai · TensorRT-LLM https://github.com/NVIDIA/TensorRT-LLM · SGLang https://github.com/sgl-project/sglang
Frameworks voor fine-tuning & training:
- Unsloth https://github.com/unslothai/unsloth · LLaMA-Factory https://github.com/hiyouga/LLaMA-Factory · Axolotl https://github.com/axolotl-ai-cloud/axolotl · HF TRL https://github.com/huggingface/trl · NVIDIA NeMo https://github.com/NVIDIA-NeMo/NeMo · DeepSpeed https://github.com/deepspeedai/DeepSpeed
Code-assistenten & agents:
- OpenCode https://github.com/sst/opencode · Aider https://github.com/Aider-AI/aider · Cline https://github.com/cline/cline · Continue https://github.com/continuedev/continue · OpenHands https://github.com/All-Hands-AI/OpenHands · Tabby https://github.com/TabbyML/tabby
Modelfamilies & licenties (modelkaarten, Hugging Face):
- Qwen https://huggingface.co/Qwen · DeepSeek https://huggingface.co/deepseek-ai · Llama https://huggingface.co/meta-llama · Gemma https://huggingface.co/google · Mistral https://huggingface.co/mistralai · Phi https://huggingface.co/microsoft
Vergelijking & benchmarks:
- Artificial Analysis https://artificialanalysis.ai · LMArena https://lmarena.ai · llm-stats.com https://llm-stats.com · SWE-bench https://www.swebench.com
- GPQA, AIME, MMLU-PRO, MATH-500 — de betreffende academische publicaties (arXiv) en datasets op Hugging Face
- Turkse benchmarks: TurkishMMLU, Cetvel, TurkBench — de betreffende datasets/repository’s op Hugging Face
Softwarerepository’s: §6 geeft voor elke tool de officiële GitHub-/websitelink (met licentie · geschat aantal sterren).
Tools: Cordatus VRAM Calculator — https://app.cordatus.ai/#/vram-calculator
Opmerkingen
- Reikwijdte van de hardware: De hardwareaanbevelingen in deze handleiding zijn beperkt tot de Aetherix-catalogus (RTX PRO Blackwell, datacenter-GPU’s, DGX, Jetson); consumentenkaarten uit de GeForce-reeks zijn niet opgenomen. Prijzen worden niet vermeld, omdat ze op offerte-/projectbasis tot stand komen en variëren — neem voor actuele prijzen en beschikbaarheid contact met ons op.
- Actualiteit: Dit vakgebied verandert snel; modelversies, releasenummers en benchmarkresultaten gelden per juni 2026. Wat blijft, is de beslislogica in de paragrafen, niet de namen.
- OpenRAG-Local: De OpenRAG die in deze handleiding wordt uitgelicht voor vraag en antwoord over documenten, is de bijdrage CordatusAI/openrag-local, die Cordatus heeft geforkt van
langflow-ai/openrag, heeft aangepast zodat hij volledig lokaal draait, en als opensource heeft uitgebracht.
Laten we samen uw lokale LLM-infrastructuur plannen. Voor de juiste combinatie van hardware, model en software, VRAM-dimensionering en TCO-analyse, neem contact op met Aetherix: info@aetherix.com · aetherix.com · VRAM-calculator: Cordatus VRAM Calculator