Opgesteld door: Aetherix B.V. — Trusted Jetson Hardware Provider for Edge AI
Testplatform: 8× NVIDIA DGX Spark (GB10) · Model: DeepSeek-V4.1-Flash (763B) · Rapportdatum: september 2026
Inhoud
- 1. Inleiding
- 2. Hardware
- 3. Docker-images
- 4. TP8-optimalisaties
- 5. Configuratie
- 6. Geheugenanalyse
- 7. Prestatieresultaten
- 8. Vergelijkende analyse
- 9. SLO en capaciteit
- 10. Geleerde lessen
- 11. Conclusie
- Bijlage A: verificatieopdrachten
1. Inleiding
Dit rapport documenteert de deployment van DeepSeek-V4.1-Flash (763B MoE) op 8× NVIDIA DGX Spark (GB10) met tensorparallellisme (tensor parallelism, TP=8). Het is de tegenhanger van het deploymentrapport voor 4× DGX Spark met TP4; de modelarchitectuur, de vLLM-buildketen en de SM 12.1a-patches worden daar beschreven en hier niet herhaald.
Er zijn twee configuraties getest:
- TP8-300K (Engram in het geheugen): context van 300K; de Engram-tabellen worden via standaard-vLLM in pinned host-geheugen geladen, GMU 0.80, AutoTuner uit.
- TP8-1M (Engram-on-disk): context van 1M; de Engram-tabellen staan via de Engram-on-disk-patch op lokale NVMe, GMU 0.75, AutoTuner aan.
Beide configuraties gebruiken speculatieve decodering (speculative decoding) met DSpark k=5, CUDA graphs (modus FULL_AND_PIECEWISE), en hebben vision en tool calling ingeschakeld.
Waarom twee configuraties? De Engram-on-disk-patch zet rijen vóór de forward pass klaar in het GPU-geheugen, waardoor CUDA graph capture mogelijk wordt. Bij een context van 300K is de unified memory over 8 ranks echter groot genoeg om Engram in plaats daarvan in pinned host-geheugen te houden. De configuratie met 300K in het geheugen test of het eenvoudigere standaardpad sneller is wanneer de context begrensd is; de configuratie met 1M op schijf verhoogt het geconfigureerde contextplafond. De benchmarks gebruiken korte prompts en testen de maximale contextlengte niet.
2. Hardware
| Component | Waarde |
|---|---|
| GPU | Blackwell-architectuur (GB10), SM 12.1a (CC 12.1), 48 SM’s |
| GPU-geheugen | 128 GB unified LPDDR5X (gedeeld door CPU+GPU) per node |
| Geheugenbandbreedte | ~273 GB/s (unified) per node |
| FP4-piekprestaties (met sparsity) | ~1 PFLOP per node |
| CPU | Arm met 20 cores (10× Cortex-X925 + 10× Cortex-A725) per node |
| Verbinding tussen nodes | NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP) |
| Opslag | 8× NVMe SSD (1× 1 TB + 7× 4 TB; 8 nodes in totaal) |
| Netwerktopologie | 200 GbE-switch (geen NVLink; all-reduce via Ethernet) |
8 nodes × 128 GB = 1024 GB unified memory in totaal over het cluster.
Cruciaal architectuurgegeven: Er is geen NVLink tussen DGX Sparks. TP=8 in dit rapport is tensorparallellisme over meerdere nodes via het ConnectX-7-netwerk van 200 GbE — elke all-reduce loopt via de 200 GbE-switch over de Ethernet-fabric.
3. Docker-images
Er worden twee images gebruikt, beide afgeleid van hetzelfde basisimage als de TP4-deployment. Het eerste (vllm-dsv41:latest) is dat basisimage zelf; het tweede (vllm-dsv41:engram-mem) is daarop gebouwd.
3.1 vllm-dsv41:latest (7 patches, Engram-on-disk)
Gebruikt door de TP8-1M-configuratie. Identiek aan het TP4-image — alle 7 SM 12.1a-patches zijn erin verwerkt, inclusief Engram-on-disk. Zie het TP4-deploymentrapport, Sectie 4 voor de volledige lijst met patches en de build-instructies.
3.2 vllm-dsv41:engram-mem (4 patches, Engram in het geheugen)
Gebruikt door de TP8-300K-configuratie. Gebouwd op vllm-dsv41:latest, waarbij de drie Engram-patchbestanden zijn teruggezet naar de originele vLLM-versies:
FROM vllm-dsv41:latest
COPY vllm/vllm/models/deepseek_v4_1/common/engram.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/common/engram.py
COPY vllm/vllm/model_executor/model_loader/weight_utils.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/model_loader/weight_utils.py
COPY vllm/vllm/models/deepseek_v4_1/nvidia/model_state.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/model_state.py
ENTRYPOINT []
De overige 4 patches (attention, FlashInfer sparse, SWA, sparse indexer) blijven behouden. Met de originele Engram-afhandeling worden de tabellen in pinned host-geheugen geladen en maakt de forward pass bij elke stap een round-trip naar de host — CUDA graphs kunnen de Engram-opzoeking niet vastleggen.
| Image | Engram.py | model_state.py | weight_utils.py | attention.py | flashinfer_sparse.py | sparse_swa.py | sparse_attn_indexer.py |
|---|---|---|---|---|---|---|---|
vllm-dsv41:latest |
gepatcht | gepatcht | gepatcht | gepatcht | gepatcht | gepatcht | gepatcht |
vllm-dsv41:engram-mem |
origineel | origineel | origineel | gepatcht | gepatcht | gepatcht | gepatcht |
4. TP8-optimalisaties
TP=8 introduceert NCCL-communicatie over 8 ranks, wat optimalisaties vereist die bij TP=4 niet nodig zijn.
4.1 Vermindering van het aantal NCCL-kanalen
Bij TP=8 gebruikt NCCL standaard 64 kanalen — ongeveer 37 GB overhead per rank. Drie omgevingsvariabelen verminderen dit:
| Instelling | Waarde | Effect |
|---|---|---|
NCCL_MAX_NCHANNELS |
8 |
64 → 8 kanalen (~26 GB bespaard per rank) |
NCCL_BUFFSIZE |
1048576 |
Buffer van 4 MiB → 1 MiB |
NCCL_NVLS_ENABLE |
0 |
GB10 heeft geen NVLink SHARP |
4.2 Containerlimieten
| Instelling | Waarde | Reden |
|---|---|---|
ulimit: nofile |
1048576:1048576 |
Limiet voor socket-accepts van NCCL 2.30 met 8 ranks |
ulimit: memlock |
-1:-1 |
Pinnen van RDMA-geheugen (ibv_reg_mr) |
ulimit: stack |
67108864 |
Stack van 64 MB |
cap_add: IPC_LOCK |
— | Capability voor het pinnen van RDMA-geheugen |
memory_limit |
112g |
9 GB vrijlaten voor het besturingssysteem (121 GB totaal) |
Zonder memlock=-1:-1 en IPC_LOCK mislukt de initialisatie van NCCL met ibv_reg_mr_iova2 failed with error Cannot allocate memory.
4.3 NCCL-omgeving
NCCL_IB_ROCE_VERSION_NUM: '2'      # RoCE v2
NCCL_IB_ADDR_FAMILY: 'AF_INET'     # IPv4
NCCL_NVLS_ENABLE: '0'              # No NVLink SHARP on GB10
NCCL_IB_MERGE_NICS: '0'           # No NIC merge
NCCL_CROSS_NIC: '1'               # Cross-NIC
NCCL_IGNORE_CPU_AFFINITY: '1'     # Ignore CPU affinity
NCCL_CUMEM_ENABLE: '0'             # NCCL cumem off
TORCH_NCCL_ASYNC_ERROR_HANDLING: '1'
NCCL_DEBUG: 'WARN'
5. Configuratie
5.1 TP8-300K (Engram in het geheugen)
| Parameter | Waarde | Beschrijving |
|---|---|---|
| Image | vllm-dsv41:engram-mem |
Standaard Engram-afhandeling |
tensor_parallel |
8 | 8 nodes × 1 GPU |
gpu_memory_utilization |
0.80 | GMU van 80% |
max_model_len |
300000 | Context van 300K |
max_num_seqs |
8 | Maximaal 8 gelijktijdige sequenties |
max_num_batched_tokens |
8192 | Batchgrootte voor prefill |
block_size |
128 | Blokgrootte van de KV-cache |
distributed-executor-backend |
mp | Multiprocess-backend |
| AutoTuner | uit (VLLM_FLASHINFER_AUTOTUNE: '0') |
Voorkomt een OOM-piek |
5.2 TP8-1M (Engram-on-disk)
| Parameter | Waarde | Beschrijving |
|---|---|---|
| Image | vllm-dsv41:latest |
Engram-on-disk-patch actief |
tensor_parallel |
8 | 8 nodes × 1 GPU |
gpu_memory_utilization |
0.75 | GMU van 75% (lager voor KV-reserve bij 1M) |
max_model_len |
1048576 | Context van 1M |
max_num_seqs |
8 | Maximaal 8 gelijktijdige sequenties |
max_num_batched_tokens |
8192 | Batchgrootte voor prefill |
block_size |
128 | Blokgrootte van de KV-cache |
distributed-executor-backend |
mp | Multiprocess-backend |
DSV41_ENGRAM_DISK |
1 | Engram-rijen op lokale NVMe |
| AutoTuner | aan (standaard) | Voldoende geheugenreserve |
5.3 Speculatieve decodering (beide)
{
  "method": "dspark",
  "num_speculative_tokens": 5,
  "draft_sample_method": "probabilistic",
  "rejection_sample_method": "block",
  "enable_adaptive_verification": false
}
5.4 Startopdracht
# TP8-300K (Engram in memory)
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp8.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.157,192.168.1.158,192.168.1.161,192.168.1.162,192.168.1.166,192.168.1.148 \
  --foreground

# TP8-1M (Engram-on-disk)
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp8-1m.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.157,192.168.1.158,192.168.1.161,192.168.1.162,192.168.1.166,192.168.1.148 \
  --foreground
6. Geheugenanalyse
6.1 TP8-300K (Engram in het geheugen)
| Component | GB/rank |
|---|---|
| Model (GPU) | 49.55 |
| Engram (pinned host) | 23.60 |
| NCCL (8 kanalen) | ~11 |
| CUDA graphs | ~1.5 |
| Totaal | ~85.5 |
| Budget bij GMU=0.80 | 96.8 |
| KV-cache | ~8.7 GB (1.46M tokens) |
6.2 TP8-1M (Engram-on-disk)
| Component | GB/rank |
|---|---|
| Model (GPU, zonder Engram) | 38 |
| NCCL (8 kanalen) | ~11 |
| AutoTune-piek | ~10 |
| CUDA graphs | ~1.5 |
| Totaal | ~60.5 |
| Budget bij GMU=0.75 | 90.75 |
| KV-cache | ~30 GB |
| Benodigd voor een context van 1M | ~3.7 GB |
| Vrije reserve | ~26 GB |
De Engram-on-disk-configuratie rapporteert meer geheugen toegewezen aan de KV-cache (~30 GB tegenover ~8.7 GB) en een geconfigureerde contextlimiet van 1M. Plaatsing van de tabellen, geheugeninstellingen en uitvoeringspaden verschillen allemaal, dus het gemeten snelheidsverschil is geen geïsoleerde prijs voor schijf-I/O. Zie Conditional memory en offloading bij LLM-inferentie voor het mechanisme en de vergelijking op dezelfde hardware.
7. Prestatieresultaten
7.1 TP8-300K (Engram in het geheugen)
De metingen zijn uitgevoerd met CordatusAI/llm-benchmark.
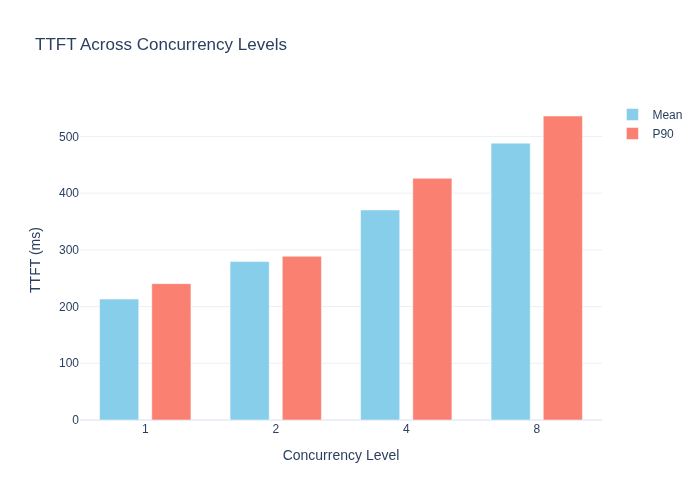
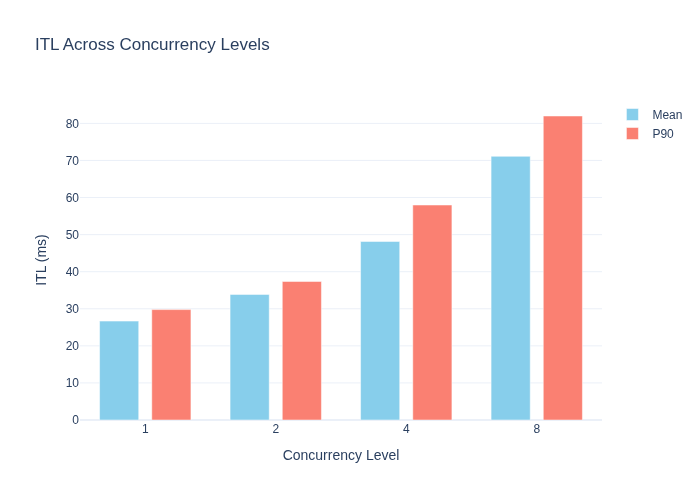
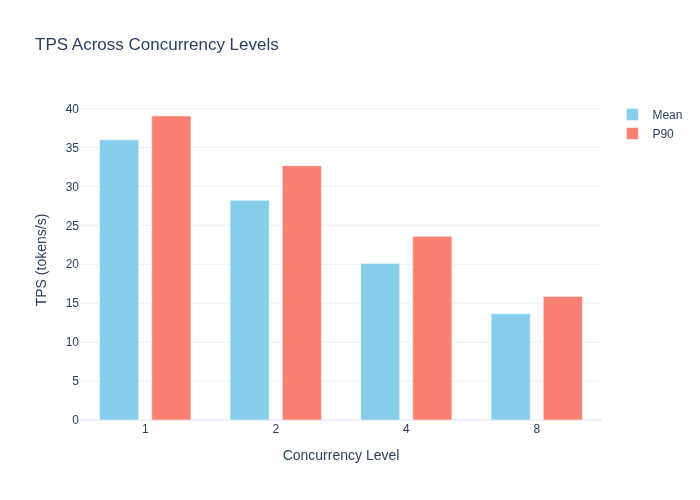
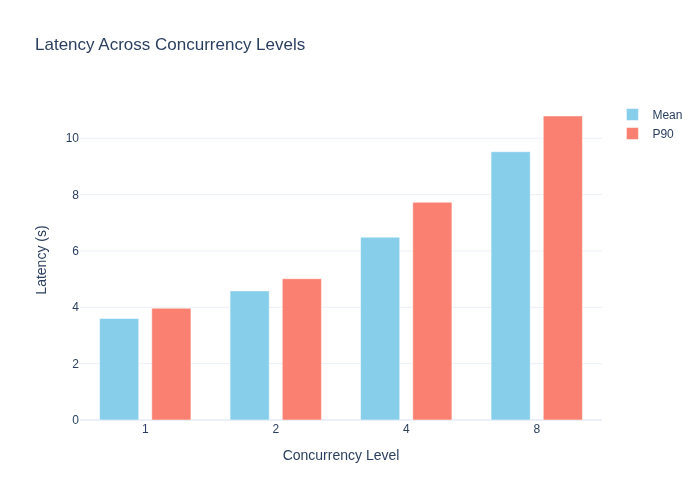
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
| 1 | 213.19 | 26.67 | 35.98 | 3.60 | 0.28 |
| 2 | 279.55 | 33.87 | 28.21 | 4.58 | 0.22 |
| 4 | 370.36 | 48.16 | 20.10 | 6.49 | 0.15 |
| 8 | 488.22 | 71.12 | 13.63 | 9.52 | 0.11 |
7.2 TP8-1M (Engram-on-disk)
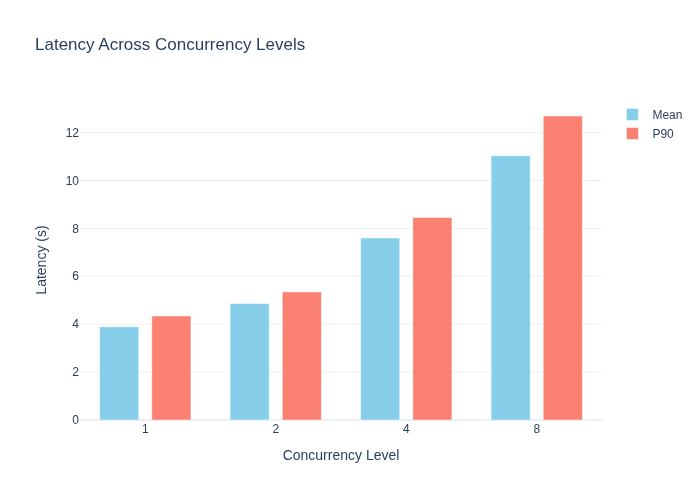
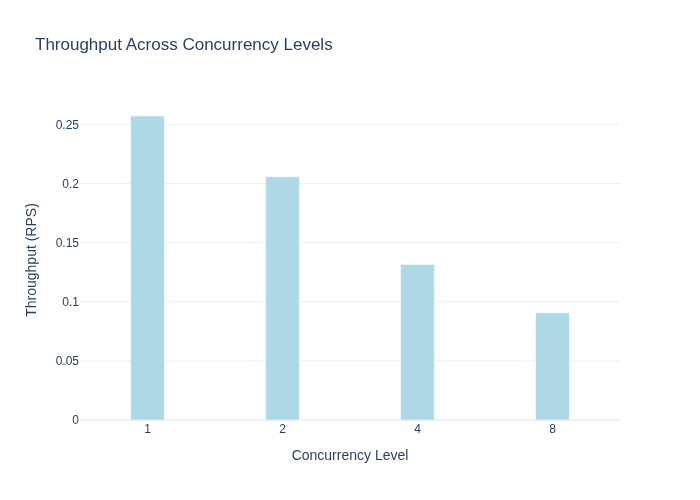
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
| 1 | 198.54 | 29.06 | 33.28 | 3.89 | 0.26 |
| 2 | 301.32 | 35.92 | 26.76 | 4.86 | 0.21 |
| 4 | 400.58 | 56.68 | 17.07 | 7.60 | 0.13 |
| 8 | 553.68 | 82.54 | 11.74 | 11.04 | 0.09 |
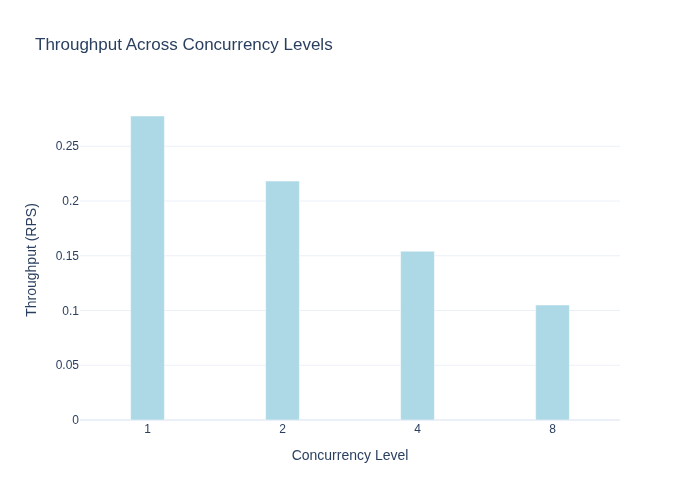
7.3 Grafieken — TP8-300K (Engram in het geheugen)
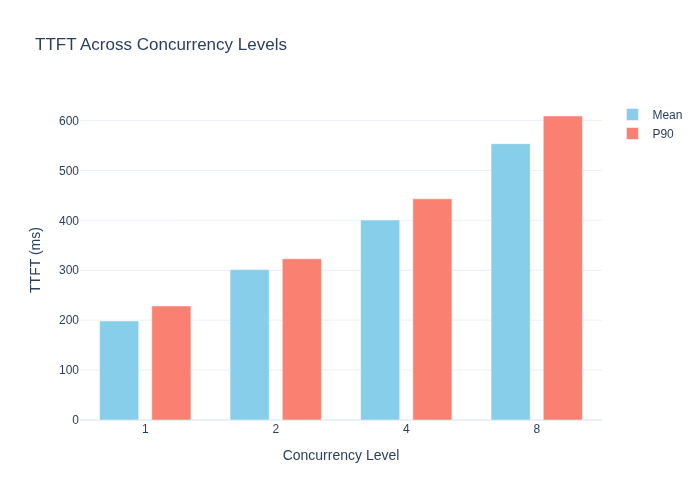
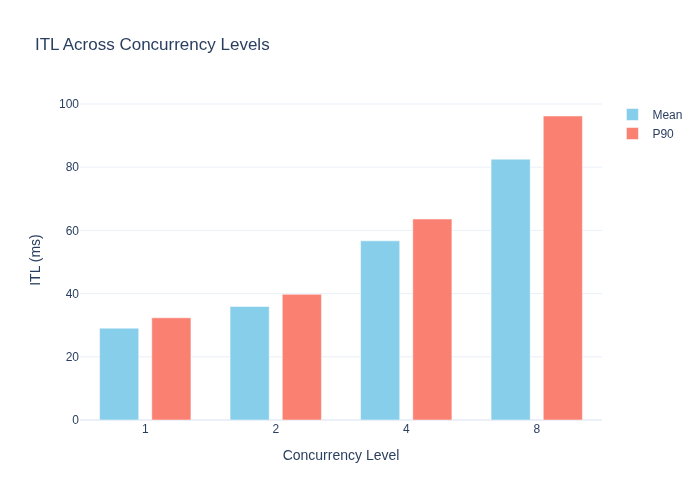
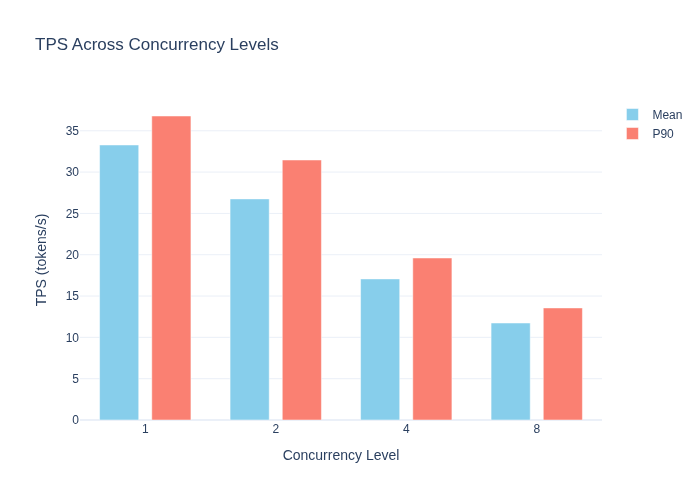
7.4 Grafieken — TP8-1M (Engram-on-disk)
7.5 Beoordeling
- TP8-300K heeft op elk getest niveau van gelijktijdigheid een hogere TPS dan TP8-1M (35.98 tegenover 33.28 bij C=1). Dit vergelijkt de volledige configuraties; de metingen isoleren de effecten van tabelplaatsing, contextinstellingen, CUDA graphs of AutoTuner niet.
- De TTFT bij C=1 is lager voor de 1M-configuratie (199 ms tegenover 213 ms). De uitvoeringspaden verschillen; deze meting alleen wijst de oorzaak niet aan.
- Max C = 4 voor TP8-300K en 2 voor TP8-1M bij de standaarddoelen van de Benchmark Explorer (TTFT≤1000ms, TPS≥20 tok/s). TP8-300K verdubbelt de capaciteit van TP4 (Max C=2); TP8-1M haalt 17.07 tok/s bij C=4, net onder het TPS-doel.
- Daling van de TPS van C=1 naar C=8: 62% lager (300K), 65% lager (1M) — concurrentie om geheugenbandbreedte naarmate het cluster verzadiging nadert.
8. Vergelijkende analyse
8.1 TP4 versus TP8 versus B300
| Gelijktijdigheid | TPS TP4 | TPS TP8-300K | TPS TP8-1M | TPS B300 |
|---|---|---|---|---|
| 1 | 29.48 | 35.98 | 33.28 | 284.54 |
| 2 | 21.32 | 28.21 | 26.76 | 294.56 |
| 4 | 13.09 | 20.10 | 17.07 | 252.60 |
| 8 | 8.79 | 13.63 | 11.74 | 209.41 |
TP8-300K is bij C=1 22% sneller dan TP4 (35.98 tegenover 29.48) en bij C=8 55% sneller (13.63 tegenover 8.79). De schaling is sublineair omdat het model gebonden is aan de geheugenbandbreedte en TP=8 all-reduce-overhead over 8 nodes toevoegt.
B300 blijft bij C=1 ~8× sneller dan TP8-300K (284.54 tegenover 35.98) — het verschil in HBM3e-bandbreedte (~8 TB/s tegenover 273 GB/s) is doorslaggevend.
8.2 Vergelijking van de TTFT
| Gelijktijdigheid | TTFT TP4 (ms) | TTFT TP8-300K (ms) | TTFT TP8-1M (ms) |
|---|---|---|---|
| 1 | 271.63 | 213.19 | 198.54 |
| 2 | 395.75 | 279.55 | 301.32 |
| 4 | 577.41 | 370.36 | 400.58 |
| 8 | 805.89 | 488.22 | 553.68 |
TP8 verlaagt de TTFT ten opzichte van TP4 met 21-39% op alle niveaus van gelijktijdigheid — prefill is rekengebonden en 8 ranks leveren meer geaggregeerde FLOPS.
9. SLO en capaciteit
Bij de standaarddoelen van de Benchmark Explorer (TTFT≤1000ms, TPS≥20 tok/s) levert TP8-300K Max C = 4 op — het dubbele van de capaciteit van TP4 (Max C = 2) — en TP8-1M Max C = 2:
| SLO | Drempel | TP8-300K C=4 | TP8-1M C=4 |
|---|---|---|---|
| TTFT | ≤ 1000 ms | 370 ms ✓ | 401 ms ✓ |
| TPS | ≥ 20 tok/s | 20.10 ✓ | 17.07 ✗ |
Waarschuwing: Bij C=8 zakt de TPS voor beide configuraties onder de drempel van 20 tok/s (13.63 en 11.74), en TP8-1M haalt die al bij C=4 niet. Voor interactieve chatdiensten worden 4 gelijktijdige gebruikers (TP8-300K) of 2 (TP8-1M) aanbevolen; voor hogere belasting verdient datacenterhardware (B300/GB300) de voorkeur.
10. Geleerde lessen
- De NCCL-overhead bij 8 ranks is aanzienlijk. De standaard 64 kanalen verbruiken ~37 GB/rank.
NCCL_MAX_NCHANNELS=8enNCCL_BUFFSIZE=1048576brengen dit terug tot ~11 GB — een cruciale optimalisatie, zonder welke het model niet past. memlock=-1enIPC_LOCKzijn verplicht voor RDMA met 8 ranks. Zonder deze instellingen mislukt de initialisatie van NCCL metibv_reg_mr_iova2 failed with error Cannot allocate memory.nofile=1048576is vereist voor NCCL 2.30. De socket-accepts bij 8 ranks overschrijden de standaard soft limit van 1024 van de container.- De schijfconfiguratie heeft een lagere gemeten TTFT bij C=1 (199 ms tegenover 213 ms). Ze zet rijen vóór de forward pass klaar, maar de vergelijking isoleert die wijziging niet van de andere verschillen tussen de configuraties.
- AutoTuner kan OOM veroorzaken.
VLLM_FLASHINFER_AUTOTUNE: '0'schakelt de autotune van FlashInfer uit, maar niet de autotune van DeepGEMM/CUTLASS mxfp8_gemm, die tijdens het profileren ~10 GB verbruikt. De 1M-configuratie heeft voldoende reserve; de 300K-configuratie schakelt hem uit. - Clusterbeheer met sparkrun.
sparkrun cluster set-default <name>wijzigt het actieve cluster;sparkrun cluster defaulttoont het alleen. - Docker
ENTRYPOINT []is verplicht. Het standaardimagevllm/vllm-openaiheeftENTRYPOINT ["vllm","serve"], waardoor sparkrun zijn opdracht niet kan toevoegen. Het uiteindelijke image moet het entrypoint leegmaken.
11. Conclusie
- DeepSeek-V4.1-Flash (763B) draait op 8× DGX Spark met TP=8 — het grotere cluster verdubbelt de bruikbare gelijktijdigheid (Max C=4 tegenover Max C=2 bij TP4) en verbetert de TPS met 22-55%.
- Twee configuraties bedienen verschillende use cases. TP8-300K (Engram in het geheugen) heeft een hogere TPS bij de gemeten werklast met korte prompts; TP8-1M (Engram-on-disk) laat meer KV-cachegeheugen over en configureert een contextlimiet van 1M. De prestaties bij die maximale contextlengte zijn niet gemeten.
- NCCL-optimalisatie is het cruciale verschil bij TP8. Zonder vermindering van het aantal kanalen en juiste ulimits verhindert de overhead bij 8 ranks dat het model past.
- TP8 vervangt geen datacenterhardware. B300 is bij C=1 nog steeds ~8× sneller, maar TP8 brengt het 763B-model binnen bereik van een 2× hogere capaciteit dan TP4 — genoeg voor ontwikkeling, prototyping en productiescenario’s voor beperkte teams.
Bijlage A: verificatieopdrachten
API-status
curl http://192.168.1.153:8000/v1/models
Eenvoudige test
curl http://192.168.1.153:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4.1-flash","max_tokens":50,
       "messages":[{"role":"user","content":"Count from 1 to 10."}]}'
Aetherix B.V. — aetherix.com · info@aetherix.com
Oude Apeldoornseweg 41, A1.08, 7333 NR Apeldoorn, Nederland
Dit rapport is opgesteld op basis van metingen die zijn uitgevoerd met de tool CordatusAI/llm-benchmark. De deployment-recipe is een aanpassing van de boot10-configuratie van tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark en de TP8-port van im0xMagnus/deepseek-v4.1-flash-uncensored-8x-dgx-spark. Rapportdatum: september 2026