Opgesteld door: Aetherix B.V. — Trusted Jetson Hardware Provider for Edge AI
Testplatform: 1x / 2x / 4x NVIDIA DGX Spark (GB10) · Model: Qwen3.6-27B-NVFP4 · Rapportdatum: juli 2026
Inhoud
- 1. Inleiding en testmethodologie
- 2. Resultaten
- 3. Analyse van de schalingsefficiëntie
- 4. Technische verdieping: waarom tensorparallellisme over Ethernet werkt op GB10
- 5. Capaciteitsplanning op basis van SLO’s
- 6. Deploymenttopologieën: tensorparallellisme versus replicatie
- 7. Nauwkeurigheid: NVFP4 versus FP8
- 8. Beperkingen en toekomstig werk
- 9. Conclusie
- Bijlage A: grafieken per configuratie
1. Inleiding en testmethodologie
1.1 Aanleiding
Onze vorige studie, Qwen3.6-27B DGX Spark-benchmark, vergeleek kwantisatieformaten (quantization formats: FP8, AWQ, NVFP4) en MTP-configuraties van hetzelfde model op één DGX Spark. Dit rapport beantwoordt de voor de hand liggende vervolgvraag:
Wat gebeurt er als u meer DGX Sparks toevoegt? Wordt een 27B-model sneller wanneer het over 2 of 4 machines wordt verdeeld — en hoeveel? En wanneer is uitschalen met tensorparallellisme de juiste keuze, en wanneer het draaien van onafhankelijke replica’s?
We hebben hetzelfde model, dezelfde workload en dezelfde benchmarktool gedraaid op drie clusterconfiguraties — één DGX Spark (TP=1), twee DGX Sparks (TP=2) en vier DGX Sparks (TP=4) — en de resultaten vanuit twee invalshoeken beoordeeld: de schaling van de ruwe prestaties, en capaciteitsplanning op basis van SLO’s (hoeveel echte gebruikers elke configuratie daadwerkelijk kan bedienen).
Twee eigenschappen maken deze opstelling ongebruikelijk en naar onze mening het documenteren waard:
- De interconnect is Ethernet, geen NVLink. DGX Sparks zijn met elkaar verbonden via ConnectX-7 (200 Gb/s RDMA). Tensorparallellisme (tensor parallelism) over een Ethernet-fabric wordt normaal gesproken als onpraktisch beschouwd — deze studie kwantificeert wanneer het werkt en waarom.
- De hardware is bescheiden en realistisch. De modelkaart (model card) van NVIDIA benchmarkt dit model op datacenterhardware van de GB300-klasse. DGX Spark (GB10) zit aan het andere uiterste: een compacte, kantoorvriendelijke machine. De resultaten hier liggen veel dichter bij wat een on-premises deploymentteam in de praktijk zal zien.
1.2 Testomgeving
Hardware — NVIDIA DGX Spark (GB10 Grace Blackwell Superchip):
| Component | Specificatie |
|---|---|
| GPU | Blackwell-architectuur (GB10), tot ~1 PFLOP FP4 |
| Geheugen | 128 GB unified LPDDR5X |
| Geheugenbandbreedte | ~273 GB/s (unified, CPU+GPU) |
| Interconnect tussen nodes | NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP) |
| CPU | 20-core Arm (10x Cortex-X925 + 10x Cortex-A725) |
Belangrijk architectuurfeit: er is geen NVLink tussen DGX Sparks. TP=2 en TP=4 zijn in deze studie tensorparallellisme over meerdere nodes — elke all-reduce gaat over het ConnectX-7-netwerk. Dit ene feit verklaart het grootste deel van het schalingsgedrag dat hieronder wordt beschreven.
Model: nvidia/Qwen3.6-27B-NVFP4 — de NVFP4-kwantisatie (4-bit) van Qwen3.6-27B, gemaakt met NVIDIA TensorRT Model Optimizer. Het model heeft een dense hybride attention-architectuur (Gated DeltaNet + Gated Attention, dense FFN — geen mixture-of-experts) en 262K context. De architectuur wordt in detail behandeld in Sectie 1.1 van de begeleidende paper. Alleen tekstinput en -output zijn getest; de visuele encoder was niet actief.
Runtime: vLLM met Ray voor orkestratie over meerdere nodes (ghcr.io/spark-arena/dgx-vllm-eugr-nightly:latest). Identieke serve-flags in alle configuraties, alleen -tp verschilt:
vllm serve nvidia/Qwen3.6-27B-NVFP4 \
    --gpu-memory-utilization 0.8 \
    --enable-prefix-caching \
    --enable-chunked-prefill \
    --quantization modelopt \
    --reasoning-parser qwen3 \
    --enable-auto-tool-choice \
    --tool-call-parser qwen3_coder \
    -tp {1|2|4}
1.3 Benchmarktool en workload
De metingen zijn verricht met CordatusAI/llm-benchmark, dat het OpenAI-compatibele endpoint /v1/chat/completions aanstuurt met streaming en include_usage voor een exacte tokentelling, reasoning_content ondersteunt en vóór de meting een warm-up uitvoert.
| Parameter | Waarde |
|---|---|
| Promptpool | 100 prompts, per run geschud |
| Inputlengte | ~128 tokens |
| Max. output-tokens | 128 |
| Rondes per gelijktijdigheidsniveau | 10 (→ 10 × gelijktijdigheid verzoeken) |
| Gelijktijdigheidsniveaus | 1, 2, 4, 8, 16, 32, 64 |
| Time-out per verzoek | 50 s |
Karakter van de workload: korte input, korte output — een evenwichtig prefill/decode-profiel dat typerend is voor interactieve chatbeurten. Gedrag bij lange context valt buiten de scope (zie Sectie 8).
1.4 SLO-kader
Ruwe getallen in tokens per seconde beantwoorden niet de vraag die een deploymentteam werkelijk heeft: hoeveel gebruikers kan deze configuratie goed bedienen? Daarom toetsen we elke configuratie aan twee service level objectives, die tegelijk worden toegepast:
| SLO | Drempel | Onderbouwing |
|---|---|---|
| TTFT (time to first token) | ≤ 1000 ms | Nielsen/NNGroup: antwoorden binnen ~1 s houden de gedachtestroom van de gebruiker ononderbroken |
| TPS (decodesnelheid per verzoek) | ≥ 15 tokens/s | Boven het plafond van de visuele leessnelheid (~700 wpm; Rayner et al., 2016) |
Het hoogste gelijktijdigheidsniveau (concurrency) dat aan beide SLO’s voldoet, is de C_max van de configuratie. Gelijktijdige verzoeken worden vervolgens met de wet van Little (Little’s Law) omgerekend naar ondersteunde gebruikers, met een denktijd (de tijd tussen het moment dat een gebruiker een antwoord ontvangt en het versturen van het volgende verzoek):
N_users = C_max × (1 + T_think / L_mean)
waarbij L_mean de gemiddelde end-to-end latentie (latency) van een verzoek op C_max is. We gebruiken T_think = 45 s als primaire aanname (standaard bij capaciteitsplanning voor interactieve chat) en geven in Sectie 5.3 een gevoeligheidsanalyse voor 15/30/60 s.
1.5 Kruisverwijzing: begeleidende benchmark en verschillen in runtime
Deze paper is een vervolg op de Qwen3.6-27B DGX Spark-benchmark, waarin hetzelfde model nvidia/Qwen3.6-27B-NVFP4 op één DGX Spark werd geëvalueerd in de kwantisatievarianten FP8, AWQ en NVFP4. De TP1-metingen (één node) in dit rapport en de NVFP4-baseline in de begeleidende paper hebben betrekking op dezelfde hardware, dezelfde workloadvorm (~128 tokens input, 128 tokens output) en dezelfde benchmarktool — maar ze zijn vastgelegd onder verschillende vLLM-runtimes en serve-flags. De verschillen worden hier voor de transparantie gedocumenteerd; de twee papers beantwoorden complementaire vragen (de benchmarkpaper: welk kwantisatieformaat; deze paper: hoeveel nodes).
Verschillen in runtime en serve-flags:
| Parameter | Begeleidende benchmark (NVFP4-variant) | Deze paper (TP1) |
|---|---|---|
| vLLM-image | vllm/vllm-openai:v0.22.0-ubuntu2404 (standaard upstream) |
ghcr.io/spark-arena/dgx-vllm-eugr-nightly:latest (nightly) |
--quantization |
niet opgegeven (standaard NVFP4-pad) | modelopt |
--enable-auto-tool-choice |
niet ingesteld | ingeschakeld |
--tool-call-parser |
qwen3_coder |
qwen3_coder |
--reasoning-parser |
qwen3 |
qwen3 |
--max-num-batched-tokens |
8192 | niet opgegeven (vLLM-standaard) |
--gpu-memory-utilization |
0.8 | 0.8 |
--enable-prefix-caching / --enable-chunked-prefill |
ingeschakeld | ingeschakeld |
| Orkestratie over meerdere nodes | geen (één node) | Ray (-tp {1\|2\|4}) |
De begeleidende benchmarkpaper (Sectie 6.4.4 en Bijlage A.3) documenteert verschillende SM121-specifieke softwaretekortkomingen in de standaardversie van vLLM v0.22.0 — waaronder een bug in CMake die het achtervoegsel
sm_121averwijdert, een ontbrekende software-fallback voor de E2M1-conversie en niet-geoptimaliseerde CUTLASS-tilegroottes — en voorspelt de versnelling die haalbaar is wanneer die fixes worden toegepast. De nightly image die in dit rapport is gebruikt, kan al dan niet een deel van die fixes bevatten; over de inhoud ervan wordt geen uitspraak gedaan.
Vergelijking van de resultaten voor één gebruiker (C=1):
| Metriek | Begeleidende benchmark — NVFP4 | Deze paper — TP1 | Δ |
|---|---|---|---|
| TPS (tok/s) | 9.86 | 12.63 | +28.1% |
| ITL (ms) | 100.40 | 77.97 | −22.4% |
| TTFT (ms) | 228.42 | 233.30 | +2.1% |
| Latentie (s) | 12.98 | 10.14 | −21.9% |
De metrieken aan de decodekant (TPS, ITL, end-to-end latentie) verschillen aanzienlijk; de metriek aan de prefillkant (TTFT) komt tot op ~5 ms overeen. Deze verschillen worden voor de transparantie vermeld; TP1 in dit rapport is geen herhaalde meting van de NVFP4-variant uit de benchmarkpaper onder identieke software, en de conclusies over SLO’s en capaciteit in Sectie 5 zijn afgeleid van de TP1-kolom van dit rapport, niet van de NVFP4-baseline van de begeleidende paper.
2. Resultaten
2.1 Prestaties voor één gebruiker (gelijktijdigheid = 1)
| Metriek | TP1 | TP2 | TP4 | TP1→TP4 |
|---|---|---|---|---|
| TPS (tokens/s) | 12.63 | 22.57 | 33.11 | 2.62x |
| ITL (ms) | 77.97 | 43.48 | 29.14 | 2.67x lager |
| TTFT (ms) | 233.30 | 148.87 | 163.59 | TP2 het best |
| Latentie (s) | 10.14 | 5.67 | 3.87 | 2.62x lager |
Twee hoofdobservaties:
- Uitschalen werkt. Eén gebruiker ziet 12.6 tok/s op één Spark en 33.1 tok/s op vier — het model wordt echt 2.6x sneller, ook al loopt het parallellisme over Ethernet.
- TTFT gaat niet mee. De time-to-first-token van TP4 is bij lage belasting slechter dan die van TP2 (164 ms versus 149 ms). Prefill is rekengebonden (compute-bound), en bij batch 1 kosten de extra all-reduce-hops meer dan de parallelle rekenkracht oplevert. Sectie 4.4 analyseert dit.
2.2 Volledige gelijktijdigheidsreeks
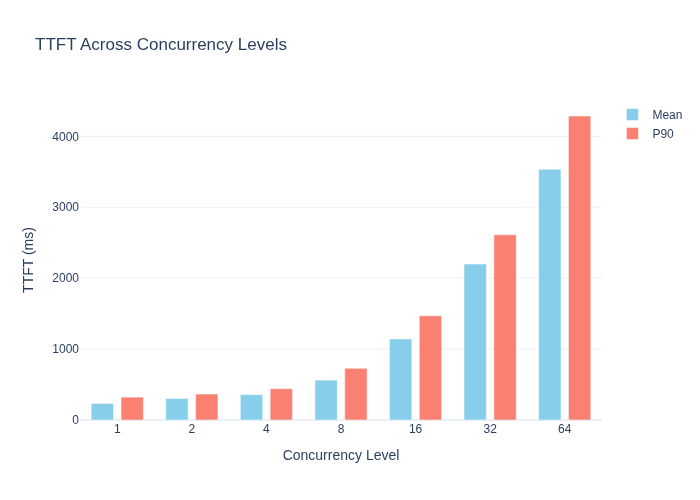
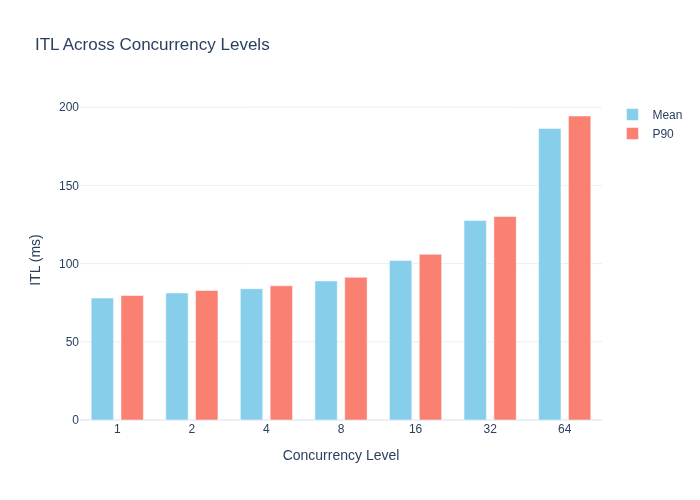
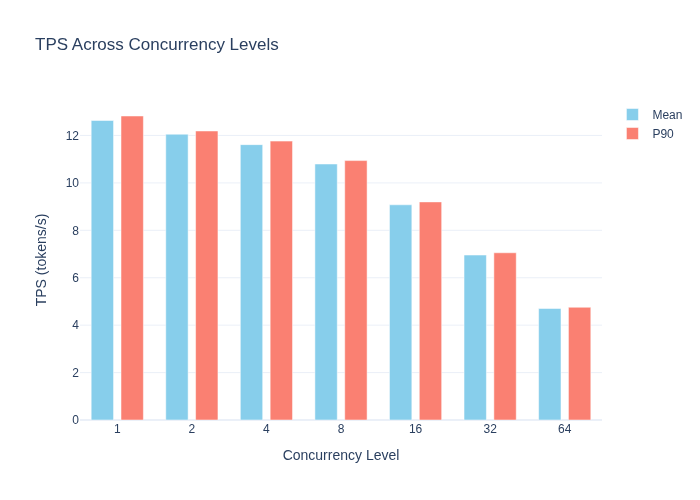
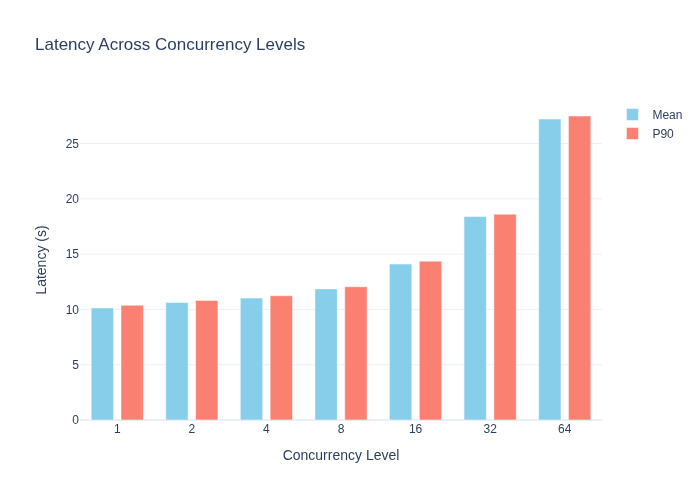
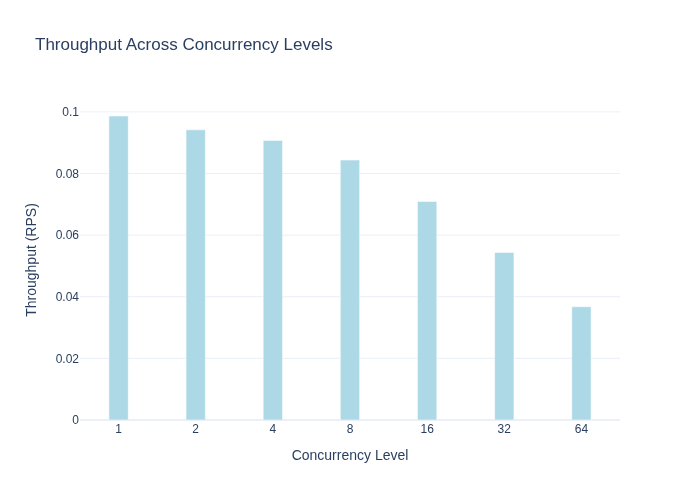
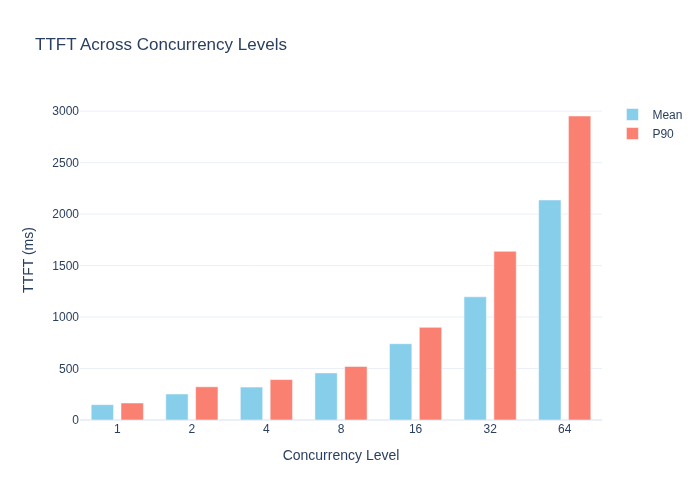
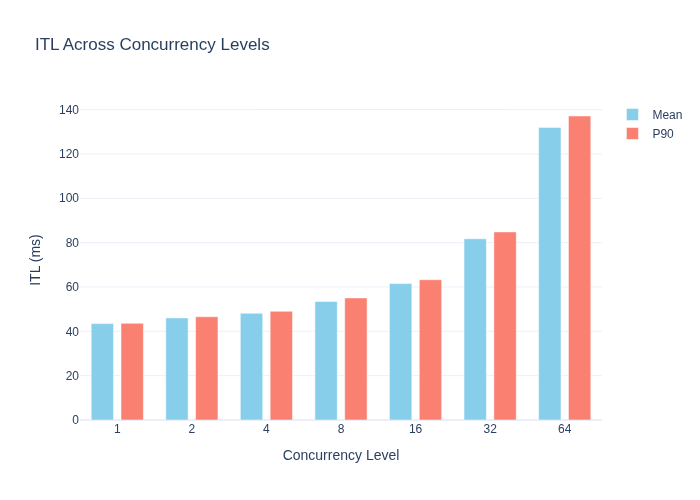
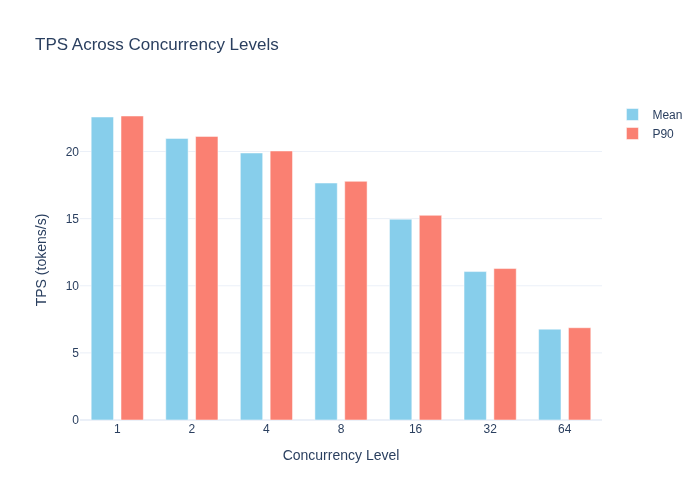
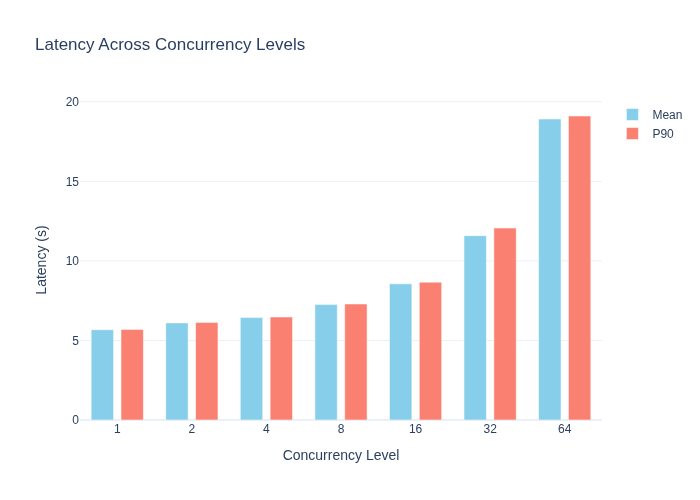
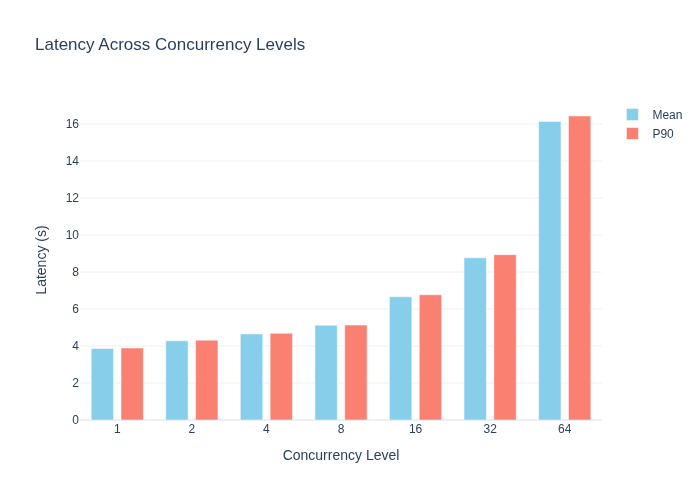
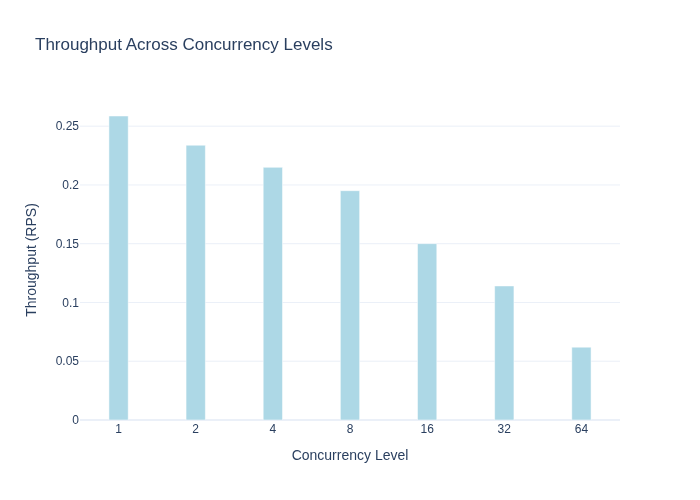
Gemiddelde waarden per configuratie (p50 volgt het gemiddelde op elk punt nauwkeurig; grafieken per configuratie, inclusief p50/p90, staan in Bijlage A).
TP1 — één DGX Spark:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) |
|---|---|---|---|---|
| 1 | 233.30 | 77.97 | 12.63 | 10.14 |
| 2 | 304.00 | 81.22 | 12.05 | 10.62 |
| 4 | 357.46 | 83.97 | 11.61 | 11.02 |
| 8 | 562.38 | 88.92 | 10.80 | 11.86 |
| 16 | 1143.17 | 102.03 | 9.08 | 14.10 |
| 32 | 2198.77 | 127.52 | 6.96 | 18.40 |
| 64 | 3535.15 | 186.40 | 4.70 | 27.22 |
TP2 — 2x DGX Spark:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) |
|---|---|---|---|---|
| 1 | 148.87 | 43.48 | 22.57 | 5.67 |
| 2 | 252.45 | 46.05 | 20.98 | 6.10 |
| 4 | 320.11 | 48.14 | 19.89 | 6.44 |
| 8 | 457.03 | 53.48 | 17.65 | 7.25 |
| 16 | 741.35 | 61.52 | 14.96 | 8.56 |
| 32 | 1196.59 | 81.72 | 11.05 | 11.59 |
| 64 | 2137.37 | 131.97 | 6.77 | 18.92 |
TP4 — 4x DGX Spark:
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) |
|---|---|---|---|---|
| 1 | 163.59 | 29.14 | 33.11 | 3.87 |
| 2 | 267.42 | 31.57 | 29.93 | 4.28 |
| 4 | 373.16 | 33.69 | 27.51 | 4.65 |
| 8 | 446.41 | 36.83 | 24.98 | 5.13 |
| 16 | 804.86 | 46.09 | 19.21 | 6.66 |
| 32 | 1005.44 | 60.99 | 14.61 | 8.77 |
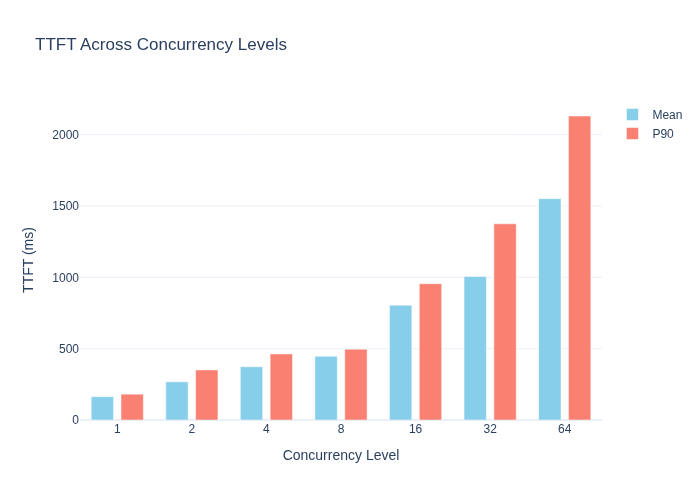
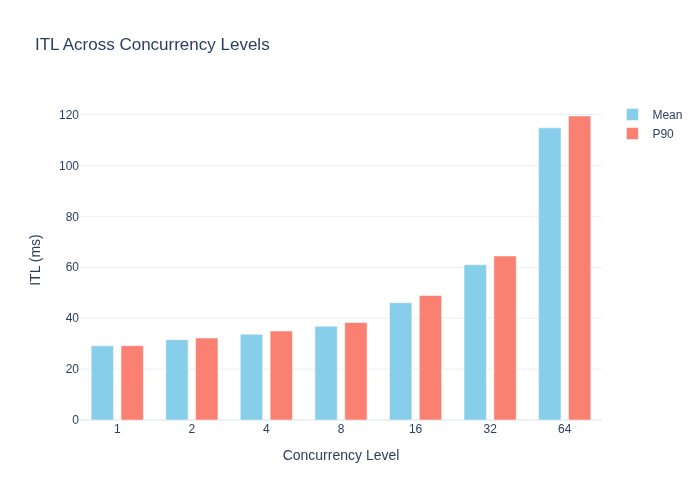
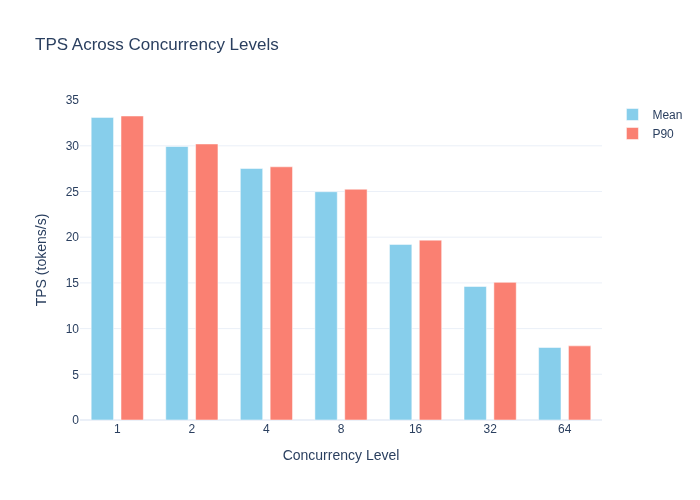
| 64 | 1551.45 | 114.76 | 7.93 | 16.14 |
2.3 Vergelijkingsgrafieken
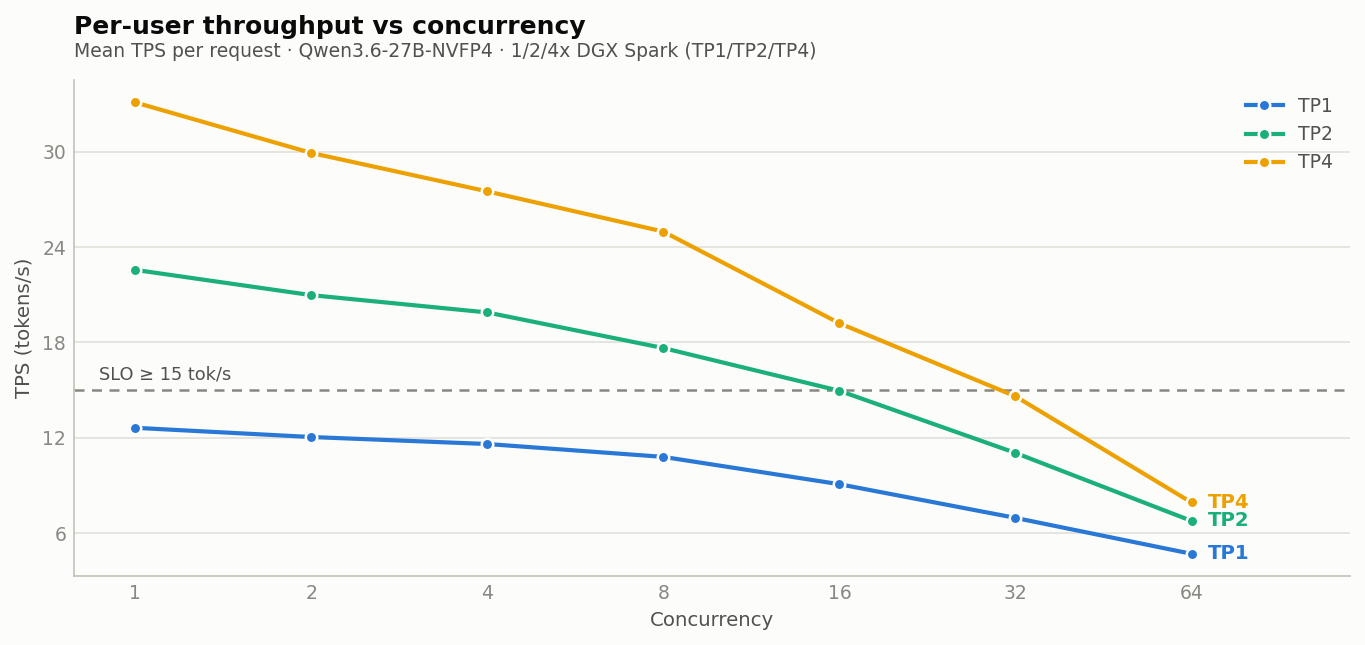 Figuur 1: decodesnelheid per verzoek. De stippellijn is de leessnelheids-SLO van 15 tok/s — TP1 komt er nooit boven, TP2 houdt die vast tot C=8, TP4 tot C=16 (C=16 komt voor TP2 uit op 14.96, een haar eronder; zie Sectie 5.4).
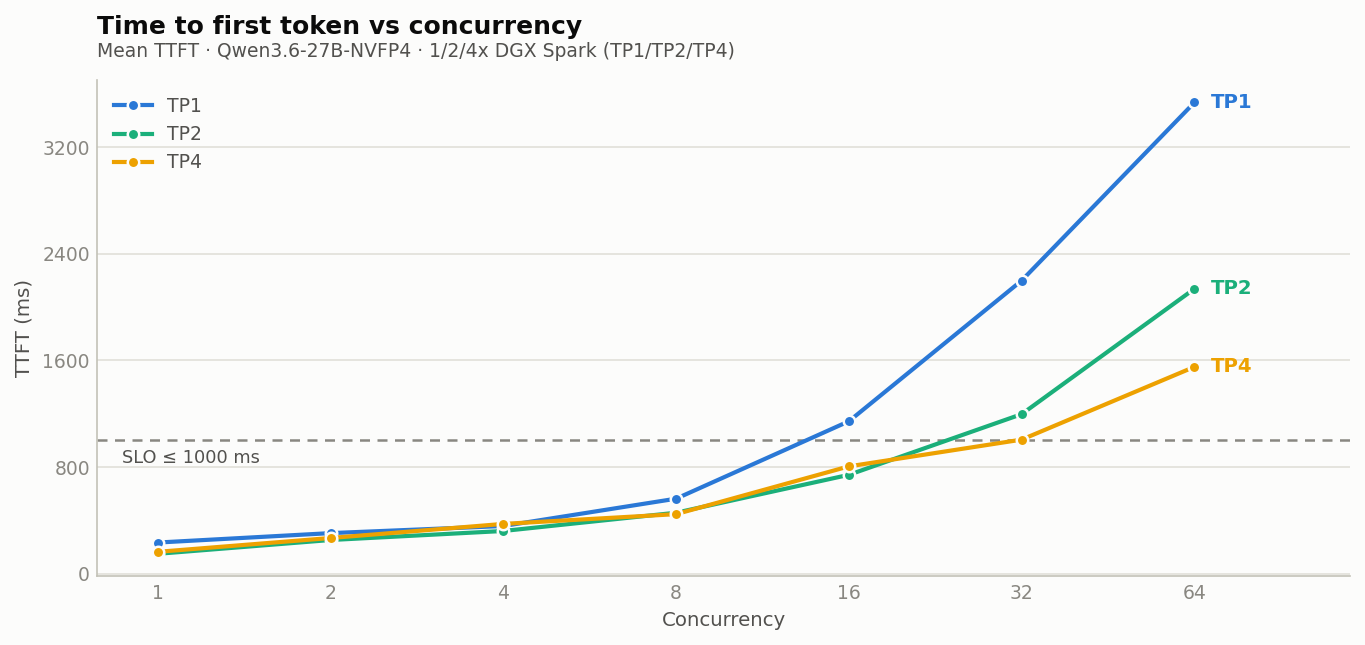 Figuur 2: time to first token. TP1 overschrijdt de SLO van 1000 ms al bij C=16 (1143 ms); TP2 en TP4 gaan er bij C=32 overheen (respectievelijk 1196 ms en 1005 ms). Geen enkele afzonderlijke instantie bedient C=64 interactief — replicatie is nodig.
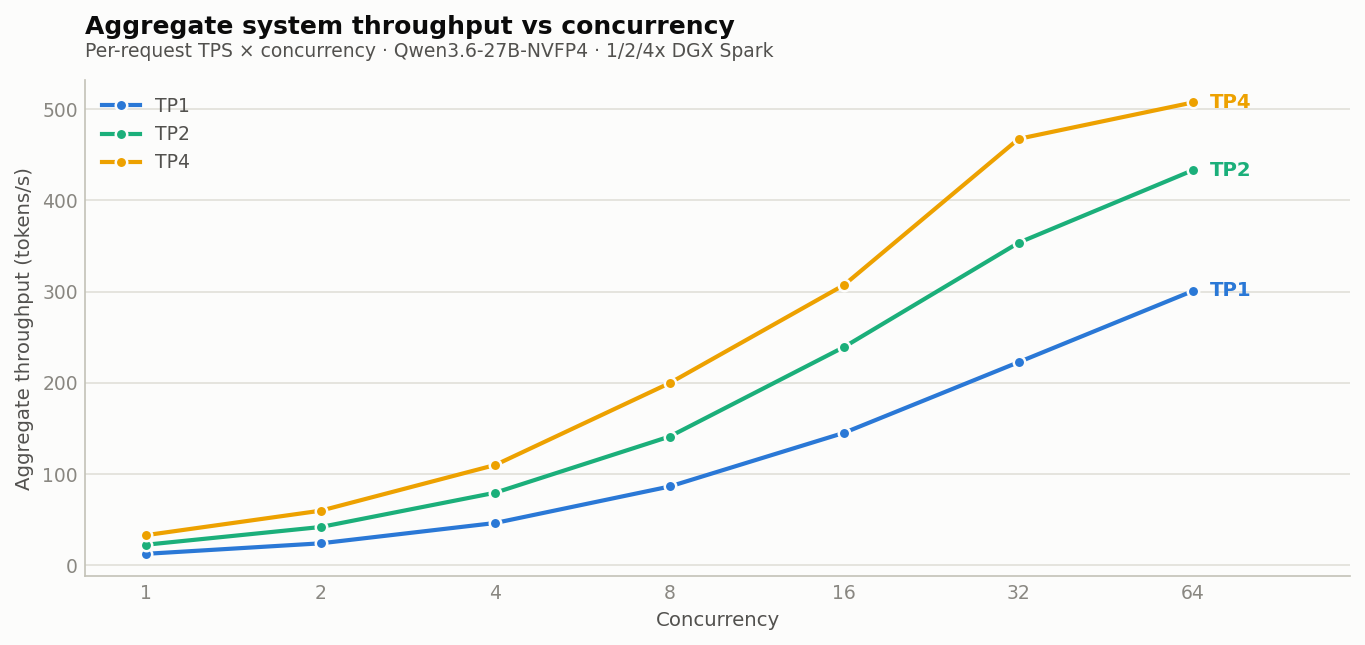 Figuur 3: totale systeemdoorvoer (throughput; TPS per verzoek × gelijktijdigheid). Terwijl de snelheid per gebruiker met de belasting daalt, stijgt de totale tokenproductie — hetzelfde cluster is een assistent van 33 tok/s bij C=1 en een tokenfabriek van ~508 tok/s bij C=64.
3. Analyse van de schalingsefficiëntie
3.1 Afnemende meeropbrengst
TPS-schalingsfactoren ten opzichte van het ideale lineaire geval:
| Stap | C=1 gemeten | C=1 efficiëntie | C=64 gemeten | C=64 efficiëntie |
|---|---|---|---|---|
| TP1 → TP2 | 1.79x | 89% | 1.44x | 72% |
| TP2 → TP4 | 1.47x | 73% | 1.17x | 59% |
| TP1 → TP4 (totaal) | 2.62x | 66% | 1.69x | 42% |
De efficiëntie neemt af langs twee onafhankelijke assen:
- Meer nodes → meer communicatie. Elke transformerlaag vereist een all-reduce over alle deelnemende nodes. De overgang van 2 naar 4 nodes verhoogt zowel de datahoeveelheid als de synchronisatiekosten van elk van deze operaties.
- Meer belasting → een verzadigend netwerk. Bij hoge gelijktijdigheid vervoert de ConnectX-7-fabric all-reduce-verkeer voor grote batches; het aandeel communicatie in elke stap groeit, en daarom is de efficiëntie bij C=64 (42%) veel slechter dan bij C=1 (66%).
Praktische consequentie: op deze topologie zit TP=4 dicht bij de bruikbare grens. Nu de marginale winst van TP2→TP4 onder belasting al tot 1.17x is gedaald, zou een hypothetische TP=8 waarschijnlijk weinig tot niets opleveren — extra Sparks boven de vier kunnen beter aan replica’s worden besteed (Sectie 6).
3.2 Waar het verlies zit
De afwijking van lineair zit vrijwel volledig in de all-reduce over het netwerk. Op een systeem met NVLink kost deze operatie tientallen microseconden; over 200GbE RDMA kost ze een orde van grootte meer, en ze wordt één keer per laag, per gegenereerd token betaald. Sectie 4 legt uit waarom de rekensom op deze specifieke hardware toch in het voordeel van uitschalen uitvalt.
4. Technische verdieping: waarom tensorparallellisme over Ethernet werkt op GB10
4.1 Decode wordt begrensd door de geheugenbandbreedte
Qwen3.6-27B is een dense model: voor het genereren van elk token moeten alle modelgewichten (weights) uit het geheugen worden gelezen. Op GB10 is dat geheugen unified LPDDR5X met ~273 GB/s — ongeveer 1/30e van de HBM-bandbreedte (bandwidth) van een datacenter-GPU. De tijd voor het lezen van de gewichten, niet het rekenwerk, domineert elke decodestap.
Tensorparallellisme verdeelt de gewichtsmatrices over de nodes. Met TP=4:
Spark0: W₀·x →  │
Spark1: W₁·x →  ├─ all-reduce (ConnectX-7) ─→ next token
Spark2: W₂·x →  │
Spark3: W₃·x →  │
- Elke node voert 1/4 van de matrixvermenigvuldiging uit
- Elke node leest slechts 1/4 van de gewichten uit zijn eigen LPDDR5X ← de eigenlijke winst
- Eén all-reduce per laag over de 200GbE-fabric ← de kosten
De ITL-getallen (inter-token latency) laten de balans van deze afweging zien:
| Configuratie | ITL (ms) | Versnelling t.o.v. TP1 | Ideaal |
|---|---|---|---|
| TP1 | 77.97 | 1.00x | 1.0x |
| TP2 | 43.48 | 1.79x | 2.0x |
| TP4 | 29.14 | 2.67x | 4.0x |
Het verschil met het ideaal is de all-reduce over het netwerk per laag; al het andere schaalt.
4.2 TPS is simpelweg het spiegelbeeld van ITL
Controle — de decodesnelheid is het omgekeerde van de inter-token latency:
| Configuratie | 1000 / ITL | Gemeten TPS |
|---|---|---|
| TP1 | 12.8 | 12.63 ✓ |
| TP2 | 23.0 | 22.57 ✓ |
| TP4 | 34.3 | 33.11 ✓ |
Er is geen onafhankelijk doorvoermechanisme: de volledige TPS-winst is de ITL-verlaging, oftewel het effect van het bundelen van bandbreedte.
4.3 Waarom dit hier werkt en niet op datacenter-GPU’s
De vuistregel “draai nooit TP over Ethernet” komt uit de HBM-wereld, en de rekensom verklaart die: het voordeel van TP is evenredig met de bespaarde tijd voor het lezen van gewichten, en de kosten zijn de all-reduce over het netwerk. Op een datacenter-GPU van de SM100-klasse (B200/GB200, ~8 TB/s HBM3e — ongeveer 30x de bandbreedte van de GB10) is het lezen van gewichten ~30x sneller, zodat de all-reduce voor een 27B-model meer zou kosten dan ze bespaart — u zou het model dan gewoon op één GPU draaien. (Op de oudere H100 met ~3.35 TB/s is de factor ~12x; de ongelijkheid blijft gelden.)
Op GB10 is de term voor het lezen van gewichten enorm (lage bandbreedte), terwijl de all-reduce-term gematigd is (200 Gb/s RDMA, kleine activaties bij korte sequentielengtes). De ongelijkheid draait om. Tensorparallellisme over Ethernet is op DGX Spark rendabel juist omdat de geheugenbandbreedte het knelpunt is — de zwakte van het platform is wat uitschalen effectief maakt.
Twee extra eigenschappen van dit model helpen:
- Het is dense. Elke forward pass raakt elk gewicht, dus elke node doet volledig werk voor elk token. Een MoE-model zou nodes stil laten staan wanneer hun experts niet door de router worden gekozen, wat de TP-efficiëntie verlaagt.
- NVFP4 halveert de verhouding tussen verkeer en rekenwerk. 4-bit-gewichten betekenen dat elke node per token minder bytes leest, waardoor de rekenfase kort blijft ten opzichte van de uitwisseling van activaties (met vaste omvang).
4.4 De uitzondering: prefill
Prefill (het verwerken van de prompt) is rekengebonden, niet bandbreedtegebonden — alle 128 input-tokens worden parallel verwerkt en het rekenwerk domineert. TP helpt ook bij rekenwerk, maar veel minder, en bij batch 1 is de overhead van de all-reduce groter dan de winst van de parallellisatie: de TTFT van TP4 bij C=1 (164 ms) is slechter dan die van TP2 (149 ms). Pas onder zware belasting, wanneer de prefill-batches groot zijn, loopt TP4 uit (C=64: 1551 ms versus 2137 ms). Als uw workload TTFT-kritisch is en licht belast wordt, is meer TP niet automatisch beter.
5. Capaciteitsplanning op basis van SLO’s
5.1 C_max: de hoogste gelijktijdigheid die aan de SLO’s voldoet
Beide SLO’s (TTFT ≤ 1000 ms en TPS ≥ 15 tok/s) toegepast op de tabellen in Sectie 2.2:
| Configuratie | C_max | Bepalende beperking | Latentie @ C_max |
|---|---|---|---|
| TP1 | 0 | TPS = 12.63 < 15, zelfs bij C=1 | — |
| TP2 | 8 | C=8 haalt beide SLO’s (TPS 17.65, TTFT 457 ms); C=16 faalt op TPS (14.96 < 15) | 7.25 s |
| TP4 | 16 | C=16 haalt beide (TPS 19.21, TTFT 805 ms); C=32 faalt op beide (TTFT 1005 ms, TPS 14.61) | 6.66 s |
Kritische bevinding: binnen dit SLO-kader kan één DGX Spark dit model helemaal niet in productie bedienen — de decodesnelheid ligt zelfs voor één gebruiker onder de leessnelheid. Twee Sparks zijn de minimale levensvatbare productie-eenheid.
5.2 Ondersteunde gebruikers (de wet van Little, T_think = 45 s)
| Configuratie | C_max | N_users |
|---|---|---|
| TP1 | 0 | 0 |
| TP2 | 8 | ~58 |
| TP4 | 16 | ~124 |
TP4 ondersteunt 2.14x zoveel gebruikers als TP2 — aanzienlijk beter dan de ruwe TPS-schaling ten opzichte van TP2 (1.47x), omdat twee effecten elkaar versterken: C_max verdubbelt en de latentie op C_max is lager, zodat elk slot sneller weer vrijkomt. Merk ook op dat de efficiëntie per Spark door de SLO-bril behouden blijft: TP2 bedient ~29 gebruikers per machine, TP4 ~31 — het toevoegen van machines verwatert de waarde per apparaat niet, anders dan het beeld van de ruwe doorvoer suggereert.
5.3 Gevoeligheid: denktijd
De denktijd hangt af van de use case; 45 s past bij bedachtzame chat. N_users opnieuw berekend:
| Scenario | T_think | TP2 | TP4 |
|---|---|---|---|
| Agentisch / snel achter elkaar | 15 s | ~25 | ~52 |
| Actieve chat | 30 s | ~41 | ~88 |
| Bedachtzame chat (primair) | 45 s | ~58 | ~124 |
| Veel lezen / af en toe | 60 s | ~74 | ~160 |
De verhouding TP4/TP2 blijft over de hele linie ~2.1x — de aanname over de denktijd verschuift de absolute capaciteit, niet de vergelijking.
5.4 Gevoeligheid: SLO-drempels — een resultaat op het scherp van de snede
Twee van de gemeten punten liggen vrijwel precies op de SLO-drempels, en de conclusies over de capaciteit zijn daar gevoelig voor:
- TP2 levert bij C=16 een TPS van 14.96 — 0.3% onder de drempel van 15 tok/s. Als de SLO 14.9 tok/s bedroeg, zou de C_max van TP2 naar 16 springen en de capaciteit naar ~100 gebruikers — bijna gelijk aan de 124 van TP4 met de helft van de hardware.
- TP4 mist bij C=32 beide drempels op een haar na (TTFT 1005 ms, TPS 14.61). Een iets ruimere SLO (1100 ms / 14.5 tok/s) zou de C_max van TP4 verdubbelen tot 32 en de capaciteit tot ~197 gebruikers.
- Een strengere TTFT-SLO (≤ 500 ms, bijvoorbeeld voor RAG- of agentpijplijnen) begrenst TP4 op C_max = 8 (TTFT 805 ms bij C=16) → ~78 gebruikers, waardoor het voordeel ten opzichte van TP2 krimpt tot 1.35x.
- Een ruimere TPS-SLO (≥ 10 tok/s, informeel gebruik) brengt eindelijk TP1 in het spel: C_max = 8, ~38 gebruikers op één Spark.
Aanbeveling: behandel de SLO-drempels als volwaardige deploymentparameters, niet als vaste constanten. Op deze hardware kan het antwoord over de capaciteit binnen het plausibele bereik van drempels met ~2x veranderen — valideer C_max tegen uw SLO voordat u een cluster dimensioneert.
6. Deploymenttopologieën: tensorparallellisme versus replicatie
Vier DGX Sparks bezitten betekent niet dat u TP=4 moet draaien. Dezelfde vloot ondersteunt drie topologieën, en onze gegevens beantwoorden alle drie (2x TP2 en 4x TP1 zijn afgeleid door de resultaten van één instantie te vermenigvuldigen; er wordt uitgegaan van een loadbalancer ervoor):
| Topologie | SLO-gebruikers (45 s denktijd) | Maximale totale doorvoer | Hoge beschikbaarheid (HA) |
|---|---|---|---|
| 4x TP1 (replica’s) | 0 | ~1203 tok/s | het best |
| 2x TP2 (replicapaar) | ~116 | ~867 tok/s | één paar blijft overeind |
| 1x TP4 | ~124 | ~508 tok/s | geen — single point of failure |
Het patroon laat zich veralgemenen tot een eenvoudige beslisregel:
Latentie en naleving van SLO’s → tensorparallellisme. Ruwe doorvoer → replica’s.
TP bundelt geheugenbandbreedte om elk verzoek sneller te maken; replicatie vermenigvuldigt het aantal slots zonder dat een verzoek sneller wordt. Omdat de TPS-SLO een ondergrens voor de snelheid per verzoek is, kan alleen TP een configuratie daarboven tillen — geen enkel aantal TP1-replica’s zal dat ooit doen. Omgekeerd leveren replica’s voor offline workloads zonder SLO per verzoek (batchsamenvattingen, het genereren van synthetische data, evaluatieruns) 2.4x zoveel tokens in totaal als TP4, met dezelfde vier machines.
Aanbevelingsmatrix:
| Doel van de deployment | Configuratie |
|---|---|
| Ontwikkeling, prototyping, één power user | 1x DGX Spark (TP1) |
| Interactieve dienst, klein team (~50 gebruikers) | 2x DGX Spark, TP2 |
| Interactieve dienst, ~100+ gebruikers, HA vereist | 4x DGX Spark als 2x TP2 + loadbalancer |
| Interactieve dienst, maximale capaciteit per vloot, HA-risico aanvaardbaar | 4x DGX Spark als 1x TP4 |
| Offline / batchproductie van tokens | N x TP1-replica’s |
Merk op hoe dicht 2x TP2 (~116 gebruikers) en 1x TP4 (~124 gebruikers) bij elkaar liggen: voor de ~7% extra capaciteit van TP4 krijgt u een single point of failure, terwijl 2x TP2 bij uitval van een nodepaar blijft bedienen (op halve capaciteit) — en in het scenario met de ruimere SLO uit Sectie 5.4 zonder meer wint. Voor de meeste productiedeployments is 2x TP2 de robuustere keuze; TP4 is bedoeld voor het maximaliseren van de capaciteit voor één tenant of de snelheid voor één gebruiker (33 tok/s).
7. Nauwkeurigheid: NVFP4 versus FP8
Conclusies over schaling zijn alleen van belang als het 4-bit-model het bedienen waard is. De modelkaart van NVIDIA rapporteert vrijwel gelijke resultaten voor FP8 en NVFP4 op tekst- en multimodale benchmarks:
| Benchmark | FP8 | NVFP4 | Δ |
|---|---|---|---|
| MMLU Pro | 86.1 | 86.3 | +0.2 |
| GPQA Diamond | 86.0 | 85.5 | −0.5 |
| HLE | 21.7 | 21.8 | +0.1 |
| τ²-Bench Telecom | 95.2 | 95.4 | +0.2 |
| MMMU Pro | 74.6 | 74.3 | −0.3 |
| SciCode | 44.8 | 44.5 | −0.3 |
| AIME 2025 | 93.1 | 92.7 | −0.4 |
| AA-LCR | 68.8 | 68.3 | −0.5 |
| IFBench | 65.1 | 65.5 | +0.4 |
Het verlies aan nauwkeurigheid is op elke benchmark minder dan 1 punt, tegenover een ~4x kleinere geheugenvoetafdruk ten opzichte van 16-bit — en volgens Sectie 4.3 zijn de kleinere gewichten zelf een deel van de reden waarom TP over meerdere nodes op dit platform efficiënt is. Voor een analyse op hardwareniveau van de uitvoering van NVFP4 op GB10 (inclusief de beperkingen van SM121), zie de begeleidende paper.
8. Beperkingen en toekomstig werk
- Eén workloadvorm. Alle resultaten gelden voor inputs van ~128 tokens en outputs van 128 tokens. Workloads met lange context (RAG over het venster van 262K) verschuiven het werk naar rekengebonden prefill, waar de TP-winst het kleinst is — het voordeel van TP4 zou bij TTFT-zwaar verkeer met lange prompts waarschijnlijk krimpen. Workloads met lange output (redeneren) verschuiven de andere kant op. Beide verdienen een eigen meetreeks.
- Afgeleide replicagetallen. De cijfers voor de topologieën 2x TP2 en 4x TP1 in Sectie 6 zijn berekend uit metingen van één instantie; een gemeten deployment met loadbalancing zou effecten van wachtrijen en routering toevoegen.
- Alleen tekst. De beeld- en videomogelijkheden van het model zijn niet getest.
- Hardwarespecifiek. Deze resultaten karakteriseren de GB10-klasse (unified memory met lage bandbreedte + 200GbE-fabric). Ze zijn niet over te dragen op HBM/NVLink-systemen, waar de rekensom uit Sectie 4.3 omdraait — en dus voorspellen de cijfers uit de GB300-modelkaart van NVIDIA ook niet het gedrag van DGX Spark.
- Toekomstig werk: pipelineparallellisme als alternatief voor TP op deze fabric (minder, grotere overdrachten), gemeten replicadeployments, meetreeksen met lange context en de wisselwerking tussen MTP en TP.
9. Conclusie
- Eén DGX Spark draait Qwen3.6-27B, maar als werkstation, niet als server. 12.6 tok/s is prima voor één ontwikkelaar en ligt voor een gebruikersbestand onder de interactieve SLO. Twee Sparks zijn de minimale productie-eenheid.
- Tensorparallellisme over 200GbE werkt op dit platform echt — 2.62x versnelling voor één gebruiker op vier nodes — omdat de lage geheugenbandbreedte van GB10, de dense architectuur van het model en de kleine gewichten van NVFP4 de balans tussen rekenwerk en communicatie allemaal in het voordeel van TP doen doorslaan. Dit is niet te veralgemenen naar hardware van de HBM-klasse.
- TP=4 is op deze fabric de praktische schalingsgrens. De marginale efficiëntie daalt onder belasting tot 1.17x; besteed de vijfde Spark aan een replica.
- Onder de SLO’s bedient TP4 ~124 gebruikers, TP2 ~58 en TP1 nul (45 s denktijd) — en de capaciteit per Spark blijft stabiel op ~30 gebruikers per machine, dus uitschalen verspilt geen hardware.
- Dezelfde vier Sparks zijn drie verschillende producten: een interactieve dienst voor ~124 gebruikers (TP4), een HA-dienst voor ~116 gebruikers (2x TP2), of een batchengine van ~1200 tok/s (4x TP1). Kies de topologie op basis van het doel — TP voor snelheid per verzoek, replica’s voor totale doorvoer — en behandel SLO-drempels als instelbare inputs, omdat het antwoord over de capaciteit binnen hun plausibele bereik met ~2x verschuift.
Bijlage A: grafieken per configuratie
A.1 TP1 — één DGX Spark
A.2 TP2 — 2x DGX Spark
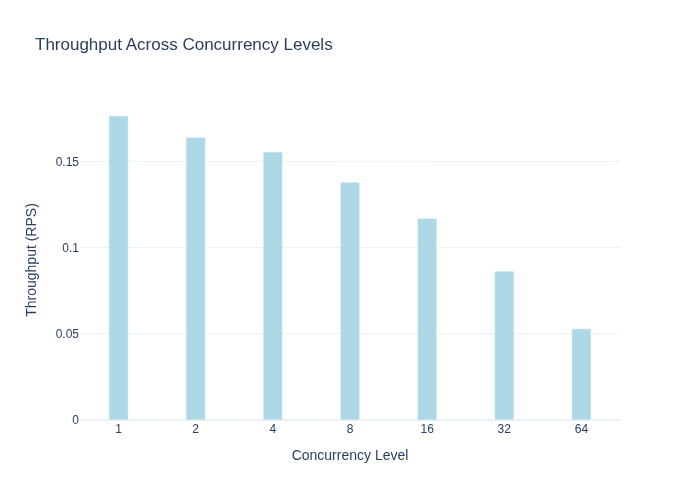
A.3 TP4 — 4x DGX Spark
Aetherix B.V. — aetherix.com · info@aetherix.com
Oude Apeldoornseweg 41, A1.08, 7333 NR Apeldoorn, Nederland